Nie każda podstrona powinna pojawiać się w Google. Strona z podziękowaniem za wysłanie formularza, wyniki wewnętrznej wyszukiwarki, stary cennik, regulamin akcji, która dawno się skończyła, albo wersja testowa oferty to adresy, które w wynikach wyszukiwania bardziej szkodzą, niż pomagają. Do ich wyłączenia służy metatag noindex, czyli krótka informacja w kodzie strony, którą Google odczytuje i stosuje.
Ten tekst jest instrukcją dla właścicieli firm i osób, które samodzielnie opiekują się swoją stroną. Nie wymaga wiedzy programistycznej. Wystarczy dostęp do panelu strony oraz do Google Search Console.
Po lekturze czytelnik będzie umiał sprawdzić, czy dana podstrona jest w Google, dodać do niej noindex na trzy sposoby, przyspieszyć jej zniknięcie z wyników, potwierdzić, że zmiana zadziałała, i rozpoznać przyczynę, jeżeli adres mimo wszystko nadal się wyświetla.
Czym jest noindex i które podstrony warto nim oznaczyć?
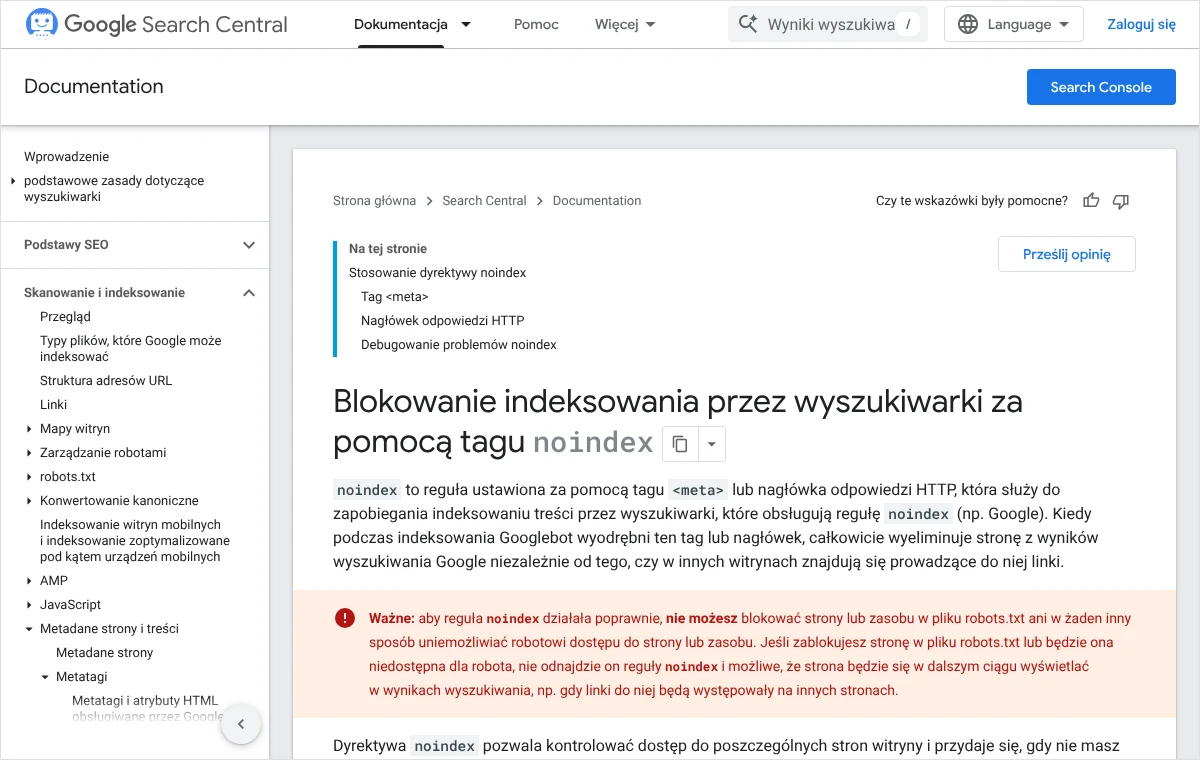
Noindex to reguła, którą umieszcza się w kodzie strony albo w odpowiedzi serwera. Według dokumentacji Google robot, który podczas odwiedzin odczyta tę regułę, całkowicie wyłącza stronę z wyników wyszukiwania, bez względu na to, czy prowadzą do niej linki z innych witryn. Strona nadal istnieje i działa. Każdy, kto zna jej adres albo kliknie link, otworzy ją tak samo jak wcześniej.
To ważne rozróżnienie. Noindex nie jest zabezpieczeniem. Nie chroni treści przed osobami, które znają adres, i nie obowiązuje wyszukiwarek, które tej reguły nie obsługują. Dokumentacja Google wymienia trzy trwałe sposoby usunięcia strony z wyników: usunięcie treści, zabezpieczenie jej hasłem albo noindex. Jeżeli podstrona zawiera dane, których nikt postronny nie powinien zobaczyć, właściwym rozwiązaniem jest hasło albo usunięcie treści, a nie sam metatag.
Podstrony, które zwykle warto wyłączyć
- strony z podziękowaniem po wysłaniu formularza lub złożeniu zamówienia,
- wyniki wewnętrznej wyszukiwarki i strony filtrów bez własnej wartości,
- koszyk, logowanie, rejestracja, panel klienta,
- wersje robocze i testowe, które są dostępne pod publicznym adresem,
- strony kampanii reklamowych przeznaczone tylko dla osób z reklamy,
- archiwa autorów, dat i tagów, jeżeli powielają treść innych podstron.
Podstrony, których nie należy oznaczać
Noindex nie jest narzędziem do porządkowania duplikatów. Jeżeli ta sama treść jest dostępna pod dwoma adresami i jeden z nich ma zostać w Google, lepszym wyborem jest wskazanie wersji głównej, co opisałem w tekście o tym, jak działa tag kanoniczny. Podstrona, która została przeniesiona pod nowy adres, wymaga przekierowania, a nie noindex. Z kolei podstrona usunięta na stałe powinna po prostu zwracać kod 404 lub 410.
Radzę też nie oznaczać podstron tylko dlatego, że mają słabe pozycje. Strona usługi, kategorii albo wpis, który sprowadza choćby kilka wejść, po oznaczeniu traci cały ruch z Google. Przed zmianą trzeba mieć pewność, że adres naprawdę nie jest potrzebny w wynikach.
Jak sprawdzić, czy podstrona jest teraz w Google?
Zanim cokolwiek zostanie zmienione, należy ustalić stan wyjściowy. Dzięki temu po kilku dniach będzie wiadomo, czy coś się rzeczywiście zmieniło. Najpewniejszym źródłem jest Narzędzie do sprawdzania adresów URL w Google Search Console, ponieważ pokazuje dane prosto z indeksu Google.
- Po zalogowaniu do Google Search Console wybiera się usługę, czyli witrynę, do której należy podstrona.
- W pasku wyszukiwania na samej górze ekranu wkleja się pełny adres podstrony, razem z początkiem https, i zatwierdza klawiszem Enter.
- Po chwili pojawia się wynik. Komunikat „Adres URL znajduje się w Google” oznacza, że podstrona jest w indeksie i może wyświetlać się w wynikach. Komunikat „Adres URL nie znajduje się w Google” oznacza, że w indeksie jej nie ma.
- W sekcji „Indeksowanie stron” należy odszukać pole „Czy indeksowanie jest dozwolone”. Wartość „Tak” oznacza, że Google nie widzi obecnie żadnej blokady. Wartość „Nie” pojawia się razem z przyczyną, na przykład wykrytym tagiem noindex.
- W tej samej sekcji warto odczytać pole „Czy skanowanie jest dozwolone”. Jeżeli widnieje tam „Nie”, dostęp robota blokuje plik robots.txt, co ma duże znaczenie w dalszej części instrukcji.
Wynik najlepiej zanotować albo zapisać w postaci zrzutu ekranu. Osoby, które chcą poznać więcej metod, znajdą je w osobnym tekście o tym, jak sprawdzić, czy Google zaindeksował stronę.
Pomocniczo można wpisać w wyszukiwarce Google operator site: z pełnym adresem podstrony, na przykład site:przyklad.pl/dziekujemy/. Jest to jednak sprawdzenie orientacyjne. O stanie faktycznym rozstrzyga Search Console.
Jak dodać metatag noindex bezpośrednio w kodzie strony?
Metatag umieszcza się w sekcji <head> tej jednej podstrony, która ma zniknąć z wyników. Wersja skierowana do wszystkich wyszukiwarek obsługujących tę regułę wygląda tak:
<meta name="robots" content="noindex">
Jeżeli podstrona ma zniknąć wyłącznie z Google, a w innych wyszukiwarkach pozostać, słowo robots zastępuje się nazwą robota Google:
<meta name="googlebot" content="noindex">
W większości przypadków właściwa jest pierwsza wersja. Druga przydaje się rzadko i łatwo o niej zapomnieć przy późniejszych zmianach.
Sam noindex czy noindex z nofollow?
Reguły można łączyć, oddzielając je przecinkiem. Zapis content="noindex, nofollow" oznacza, że strona ma zniknąć z wyników, a Google nie ma korzystać z umieszczonych na niej linków do odkrywania kolejnych stron. Ten sam skutek daje pojedyncze słowo none.
W typowej sytuacji radzę zostać przy samym noindex. Podstrona wyłączona z wyników nadal może prowadzić robota do pozostałych części serwisu, co pomaga w ich odnajdywaniu. Dodawanie nofollow ma sens głównie wtedy, gdy linki na podstronie prowadzą w miejsca, których Google nie powinien odwiedzać.
Gdzie dokładnie wkleić wiersz?
- Otwarcie pliku lub szablonu, który odpowiada za tę jedną podstronę. W stronach pisanych ręcznie jest to plik HTML tej podstrony, w kreatorach stron zwykle pole na własny kod w nagłówku w ustawieniach konkretnej podstrony.
- Odszukanie początku sekcji
<head>i wklejenie wiersza z metatagiem przed jej zamknięciem, czyli przed znacznikiem</head>. - Upewnienie się, że wiersz trafił tylko do tej podstrony, a nie do wspólnego nagłówka całego serwisu. Wklejenie go do wspólnego szablonu wyłączy z Google wszystkie podstrony.
- Zapisanie zmian i wyczyszczenie pamięci podręcznej strony, jeżeli serwis z niej korzysta.
- Otwarcie podstrony w przeglądarce, wyświetlenie jej źródła skrótem Ctrl+U i wyszukanie słowa noindex skrótem Ctrl+F. Wiersz powinien wystąpić dokładnie raz.
Jedna uwaga techniczna dla stron, które budują treść za pomocą JavaScriptu. Dokumentacja Google ostrzega, że po napotkaniu noindex robot może pominąć dalsze przetwarzanie strony, a dodawanie lub usuwanie tej reguły skryptem może działać niezgodnie z oczekiwaniami. Najbezpieczniej jest więc, gdy metatag znajduje się w kodzie wysyłanym przez serwer od razu.
Jak ustawić noindex w WordPressie bez edycji kodu?
W WordPressie nie trzeba dotykać plików motywu. Dokumentacja Google wprost wskazuje, że w systemach takich jak WordPress regułę ustawia się zwykle w panelu administracyjnym. Sam WordPress ma jednak tylko jedno wbudowane ustawienie tego rodzaju i dotyczy ono całej witryny.
Ustawienie, którego nie wolno pomylić
W menu „Ustawienia”, w zakładce „Czytanie”, znajduje się pole „Proś wyszukiwarki o nieindeksowanie tej witryny”. Jego zaznaczenie obejmuje cały serwis, a nie pojedynczą podstronę. To jedna z najczęstszych przyczyn zniknięcia całej strony firmowej z Google, zwykle po przeniesieniu wersji testowej na docelowy adres. Do wyłączenia jednej podstrony to pole się nie nadaje i powinno pozostać odznaczone.
Noindex dla jednej podstrony we wtyczce SEO
Pojedynczą podstronę oznacza się we wtyczce SEO. Wszystkie popularne wtyczki tego typu mają taką funkcję, różnią się jedynie nazwami pól. Ogólna kolejność czynności jest wspólna:
- W panelu WordPressa należy otworzyć listę „Strony” albo „Wpisy” i wejść w edycję właściwej podstrony.
- Pod treścią albo w bocznym panelu edytora znajduje się blok ustawień wtyczki SEO. Należy przejść w nim do części z ustawieniami zaawansowanymi.
- W tej części trzeba odszukać ustawienie dotyczące robotów. W zależności od wtyczki jest to pole wyboru z napisem noindex albo pytanie o to, czy wyszukiwarki mają pokazywać tę treść w wynikach wyszukiwania.
- Po zaznaczeniu noindex albo wybraniu odpowiedzi odmownej zapisuje się podstronę przyciskiem „Zaktualizuj”.
- Na koniec należy wyczyścić pamięć podręczną we wtyczce przyspieszającej stronę oraz w usłudze CDN, jeżeli serwis z nich korzysta. Bez tego odwiedzający i roboty mogą jeszcze przez pewien czas otrzymywać starą wersję kodu.
Wtyczki SEO mają także ustawienia zbiorcze dla całych typów treści, na przykład dla wszystkich tagów, archiwów autorów albo stron załączników. To wygodne, gdy do wyłączenia jest cała grupa podobnych adresów. Wymaga jednak ostrożności, ponieważ jedno kliknięcie obejmuje wtedy wiele podstron naraz.
Po zapisaniu zawsze należy potwierdzić wynik w źródle strony, tak jak w poprzedniej sekcji. Zdarza się, że dwie wtyczki albo wtyczka i motyw wstawiają własne metatagi robots. Google stosuje wtedy regułę bardziej restrykcyjną, więc noindex zadziała, ale taki bałagan utrudnia późniejsze cofnięcie zmiany.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: ustalę, które podstrony rzeczywiście powinny zniknąć z wyników, ustawię noindex we właściwym miejscu i dopilnuję w Search Console, żeby Google tę zmianę odczytał.
Co zrobić z plikiem PDF, obrazem lub innym plikiem bez kodu HTML?
Plik PDF, arkusz albo zdjęcie nie mają sekcji <head>, więc metatagu nie da się w nich umieścić. Dla takich zasobów Google przewiduje nagłówek odpowiedzi serwera o nazwie X-Robots-Tag. Działa tak samo jak metatag, tylko informacja jest wysyłana przez serwer razem z plikiem:
X-Robots-Tag: noindex
Na serwerach Apache nagłówek ustawia się w pliku .htaccess. Dokumentacja Google podaje gotowy wzór dla pojedynczego pliku. Plik .htaccess z tym zapisem musi znajdować się w tym samym katalogu co oznaczany plik:
<Files "cennik-archiwalny.pdf">
Header set X-Robots-Tag "noindex"
</Files>
Na serwerach NGINX odpowiednikiem jest wpis w konfiguracji serwera, do której zwykle ma dostęp tylko administrator hostingu:
location = /pliki/cennik-archiwalny.pdf {
add_header X-Robots-Tag "noindex";
}
Edycja pliku .htaccess jest czynnością ryzykowną. Jeden błędny znak potrafi wyłączyć całą stronę i wyświetlić odwiedzającym komunikat o błędzie serwera. Przed zmianą trzeba pobrać kopię obecnego pliku na dysk, a po zapisaniu od razu otworzyć stronę główną i sprawdzić, czy działa. Jeżeli nie działa, wystarczy wgrać z powrotem kopię.
Bezpieczniejszą drogą jest zlecenie tej zmiany administratorowi hostingu. W zgłoszeniu można napisać: „Proszę o ustawienie nagłówka odpowiedzi X-Robots-Tag: noindex dla pliku pod adresem [pełny adres pliku] oraz o potwierdzenie, że nagłówek jest zwracany”. Jeżeli plik nie jest już nikomu potrzebny, najprostszym i najpewniejszym rozwiązaniem pozostaje usunięcie go z serwera.
Dlaczego plik robots.txt nie może blokować tej podstrony?
To najważniejsza zasada w całej instrukcji i zarazem źródło najczęstszej pomyłki. Wiele osób, chcąc mieć pewność, dodaje noindex i jednocześnie blokuje ten sam adres w pliku robots.txt. Skutek jest odwrotny do zamierzonego.
Robots.txt mówi robotowi, których adresów nie wolno mu odwiedzać. Noindex jest natomiast zapisany wewnątrz strony, więc robot musi ją odwiedzić, żeby go przeczytać. Jeżeli wejście jest zablokowane, Google nigdy nie zobaczy reguły. Dokumentacja Google ostrzega, że taka podstrona może nadal wyświetlać się w wynikach, na przykład wtedy, gdy prowadzą do niej linki z innych stron. W Search Console widać ją wówczas ze stanem „Strona zindeksowana, ale zablokowana przez plik robots.txt”.
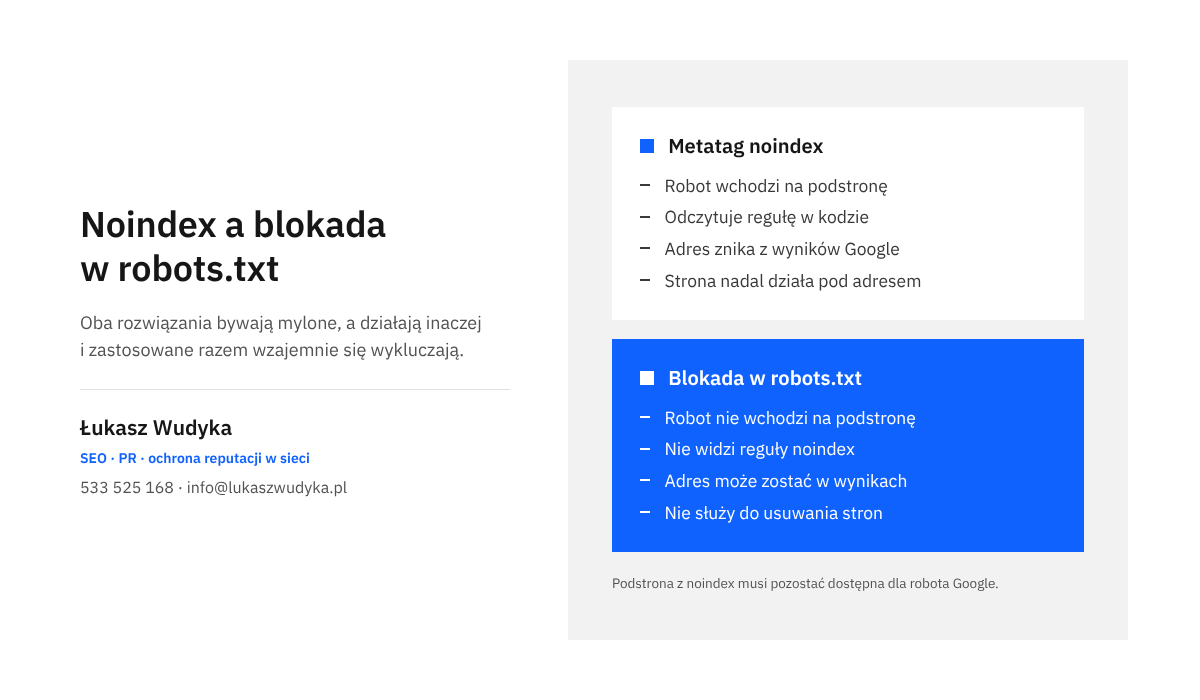
Zasada jest więc prosta: podstrona z noindex musi być dostępna dla robota. Jeżeli w kroku sprawdzającym pole „Czy skanowanie jest dozwolone” pokazało „Nie”, najpierw trzeba usunąć z pliku robots.txt wiersz, który blokuje ten adres, a dopiero potem liczyć na działanie metatagu. Budowę tego pliku i bezpieczny sposób jego zmiany opisałem w tekście o tym, jak ustawić plik robots.txt.
Druga pułapka dotyczy samego zapisu. Google nie obsługuje reguły noindex umieszczonej w pliku robots.txt. Wiersz w rodzaju „Noindex: /dziekujemy/” w tym pliku nie robi nic. Reguła działa tylko jako metatag w kodzie strony albo jako nagłówek odpowiedzi serwera.
Blokadę w robots.txt można przywrócić dopiero wtedy, gdy podstrona zniknęła już z wyników, i tylko wtedy, gdy jest ku temu powód, na przykład oszczędzanie zasobów serwera. W większości małych serwisów nie ma takiej potrzeby.
Jak przyspieszyć zniknięcie podstrony z wyników?
Samo dodanie metatagu niczego jeszcze nie zmienia w wynikach. Google musi ponownie odwiedzić podstronę i odczytać nową regułę. Dokumentacja uprzedza, że w zależności od znaczenia strony w internecie może to potrwać nawet kilka miesięcy. Są dwa sposoby, żeby nie czekać biernie.
Prośba o ponowne odwiedzenie podstrony
- W Google Search Console należy ponownie wkleić adres podstrony w górnym pasku Narzędzia do sprawdzania adresów URL.
- Po wyświetleniu wyniku trzeba kliknąć „Sprawdź URL wersji opublikowanej”. Narzędzie pobierze aktualną wersję strony.
- W wyniku testu pole „Czy indeksowanie jest dozwolone” powinno pokazywać „Nie” z informacją o wykrytym noindex. To potwierdzenie, że Google widzi nową regułę.
- Następnie należy kliknąć „Poproś o zindeksowanie”. Nazwa przycisku bywa myląca, ale w tym przypadku chodzi właśnie o to, żeby robot szybciej wrócił na stronę i odczytał noindex.
Liczba takich próśb jest ograniczona dziennym limitem dla każdej usługi, a wielokrotne wysyłanie prośby dla tego samego adresu niczego nie przyspiesza. Wystarczy jedna.
Tymczasowe ukrycie adresu w Narzędziu do usuwania
Jeżeli podstrona powinna zniknąć z wyników pilnie, Search Console oferuje Narzędzie do usuwania. Według dokumentacji przetworzenie prośby może zająć nawet cały dzień, a blokada trwa około 6 miesięcy. Jest to ukrycie tymczasowe, dlatego stosuje się je razem z noindex, a nie zamiast niego.
- W menu po lewej stronie Search Console, w części dotyczącej indeksowania, należy otworzyć pozycję „Usunięcia”.
- Na karcie „Tymczasowe usunięcia” trzeba kliknąć przycisk „Nowa prośba”.
- W oknie należy pozostać przy opcji „Tymczasowe usunięcie adresu URL” i wpisać adres dokładnie w takiej postaci, w jakiej pojawia się w wynikach Google, z zachowaniem wielkości liter.
- Dla jednej podstrony zaznacza się „Usuń tylko ten URL”. Opcja „Usuń wszystkie URL-e z tym prefiksem” ukrywa wszystkie adresy zaczynające się od wpisanego ciągu, więc wybrana przez pomyłkę może ukryć cały dział serwisu.
- Po kliknięciu „Dalej” i potwierdzeniu prośba trafia do tabeli z historią, gdzie widać jej stan, na przykład „Przetwarzam prośbę” albo „Tymczasowe usunięcie”.
- Jeżeli ta sama treść otwiera się także pod innymi adresami, na przykład z parametrem po znaku zapytania, dla każdego z nich przesyła się osobną prośbę.
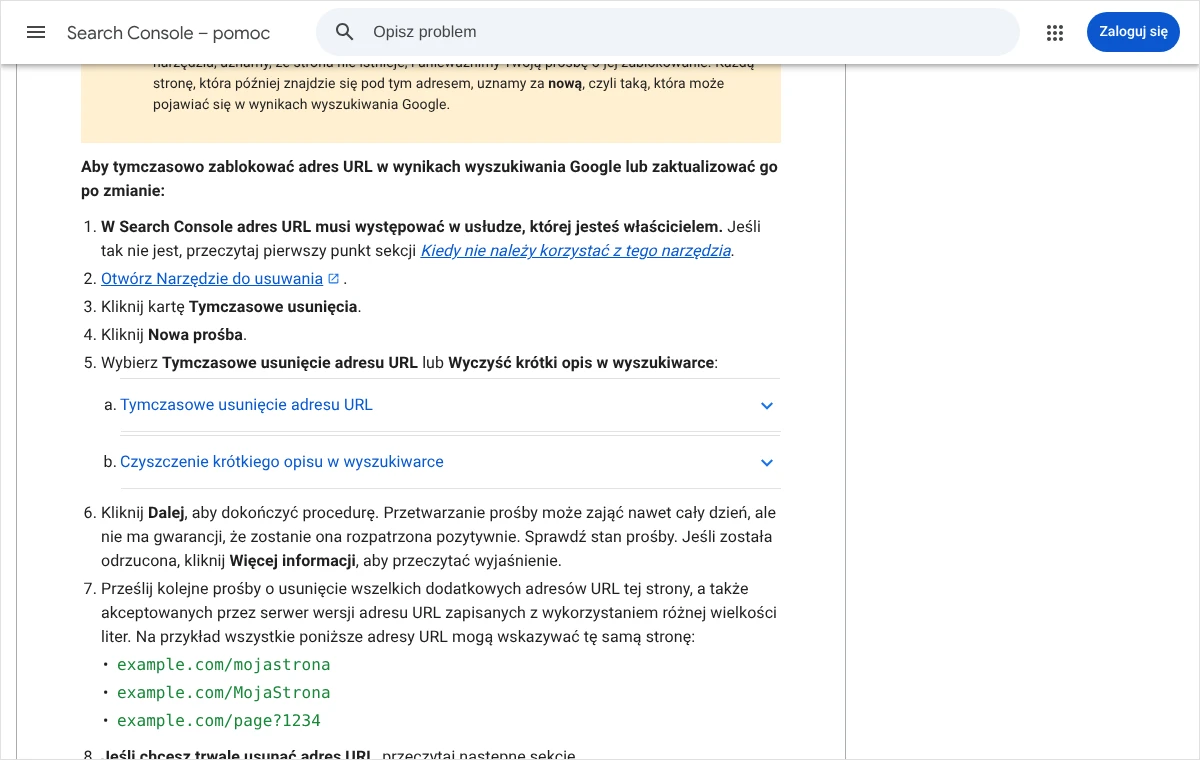
Prośbę wysłaną przez pomyłkę da się wycofać. W tabeli z historią należy kliknąć ikonę z trzema kropkami przy danej pozycji i wybrać „Anuluj prośbę”. Trzeba też wiedzieć, że samo narzędzie nie usuwa strony z indeksu na stałe. Jeżeli w ciągu pół roku na podstronie nie będzie noindex, hasła albo kodu 404 lub 410, adres może wrócić do wyników.
Po czym poznać, że noindex zadziałał?
Potwierdzenie składa się z trzech prostych obserwacji. Pierwsza jest możliwa od razu, dwie kolejne dopiero po ponownych odwiedzinach robota.
- W źródle strony widać wiersz z noindex, a test wersji opublikowanej w Search Console pokazuje w polu „Czy indeksowanie jest dozwolone” wartość „Nie”.
- Po pewnym czasie zwykłe sprawdzenie adresu w Narzędziu do sprawdzania adresów URL zwraca komunikat „Adres URL nie znajduje się w Google”.
- W raporcie „Indeksowanie stron” adres przechodzi do grupy stron niezindeksowanych, a na liście przyczyn pojawia się pozycja ze słowem noindex. Po jej kliknięciu widać listę adresów, z których robot odczytał tę regułę.
Raport „Indeksowanie stron” warto przejrzeć także z innego powodu. Jeżeli na liście adresów z noindex znajdują się podstrony, które miały być widoczne w Google, oznacza to, że reguła trafiła w niewłaściwe miejsce i trzeba to niezwłocznie poprawić.
Search Console może wyświetlać wykrycie noindex w formie problemu do naprawy. W przypadku celowego wyłączenia podstrony nie jest to błąd i nie wymaga żadnej reakcji. Przycisk „Sprawdź poprawkę” służy do sytuacji odwrotnej, czyli gdy noindex został usunięty i Google ma potwierdzić, że strona może wrócić do indeksu.
Podstrona nadal widnieje w wynikach. Co sprawdzić?
Jeżeli po kilku tygodniach adres wciąż się wyświetla, przyczyna prawie zawsze mieści się w jednej z poniższych sytuacji. Radzę sprawdzać je po kolei, ponieważ są ułożone od najczęstszej.
Robot jeszcze nie wrócił na stronę
W Narzędziu do sprawdzania adresów URL, w sekcji „Indeksowanie stron”, widać czas ostatniego skanowania. Jeżeli jest wcześniejszy niż moment dodania noindex, Google po prostu nie odczytał jeszcze zmiany. Rozwiązaniem jest jednorazowa prośba o zindeksowanie, a w pilnych przypadkach tymczasowe usunięcie.
Dostęp blokuje robots.txt albo logowanie
Pole „Czy skanowanie jest dozwolone” z wartością „Nie” oznacza blokadę w pliku robots.txt. Trzeba ją zdjąć i poczekać na odwiedziny robota. Podobnie działa każda inna przeszkoda, przez którą robot nie otrzymuje kodu strony, na przykład błąd serwera.
Metatag jest w złym miejscu albo zawiera literówkę
W źródle strony należy sprawdzić, czy wiersz znajduje się w sekcji <head>, czy cudzysłowy są proste, a słowo noindex zapisane poprawnie. Częstym błędem jest wklejenie kodu do treści wpisu w edytorze wizualnym, który zamienia znaki na zwykły tekst widoczny dla czytelników.
Pamięć podręczna podaje starą wersję
Jeżeli w przeglądarce właściciela metatag jest widoczny, a test wersji opublikowanej w Search Console go nie wykrywa, przyczyną bywa pamięć podręczna wtyczki albo usługi CDN. Po jej wyczyszczeniu test należy powtórzyć.
W wynikach wyświetla się inny adres tej samej treści
Ta sama podstrona bywa dostępna pod kilkoma adresami: z ukośnikiem na końcu i bez niego, z www i bez www, z parametrami. Noindex ustawiony na jednym wariancie nie obejmuje pozostałych, jeżeli zwracają one osobny kod bez tej reguły. Adres z wyników trzeba skopiować i sprawdzić jego źródło osobno.
Adres wyświetla się w innej wyszukiwarce
Noindex obowiązuje wyszukiwarki, które tę regułę obsługują. Jeżeli treść nie powinna być dostępna nigdzie, pewniejszym rozwiązaniem jest zabezpieczenie hasłem albo usunięcie podstrony.
Jakich błędów unikać przy wyłączaniu podstron?
Większość kłopotów z noindex nie wynika z samej reguły, tylko z nieuwagi przy jej wdrażaniu. Oto pomyłki, które widuję najczęściej.
- Noindex wstawiony do wspólnego nagłówka serwisu zamiast do jednej podstrony. Po każdej zmianie w szablonie należy sprawdzić źródło strony głównej.
- Pozostawienie adresu z noindex w mapie witryny. Mapa powinna zawierać tylko adresy przeznaczone do wyników, a sposób jej uporządkowania pokazuję w tekście o tym, jak oczyścić mapę witryny z adresów z noindex.
- Łączenie noindex z tagiem kanonicznym wskazującym na inną podstronę. Te dwa sygnały mówią Google co innego, dlatego dla jednego adresu wybiera się jedno rozwiązanie.
- Oznaczenie strony docelowej ważnej kampanii albo podstrony, do której prowadzą wartościowe linki z innych serwisów. W takim przypadku lepiej rozważyć przekierowanie na aktualną treść.
- Traktowanie noindex jako ochrony danych. Dokumenty z danymi osobowymi, umowy i wewnętrzne cenniki wymagają hasła albo usunięcia z serwera.
- Pozostawienie noindex po zakończeniu prac nad nową wersją strony. Przed publikacją należy przejrzeć ustawienia wtyczki SEO oraz pole w zakładce „Czytanie”.
Jak cofnąć noindex, gdy podstrona ma wrócić do Google?
Powrót wymaga odwrócenia tych samych czynności. Należy usunąć metatag albo odznaczyć ustawienie we wtyczce, wyczyścić pamięć podręczną i potwierdzić w źródle strony, że słowo noindex zniknęło. Jeżeli adres był zgłoszony w Narzędziu do usuwania, trzeba dodatkowo anulować tę prośbę, ponieważ ukrycie działa niezależnie od metatagu.
Następnie w Narzędziu do sprawdzania adresów URL uruchamia się test wersji opublikowanej. Pole „Czy indeksowanie jest dozwolone” powinno pokazać „Tak”. Wtedy można kliknąć „Poproś o zindeksowanie”. Powrót do wyników nie następuje natychmiast, a pozycje sprzed wyłączenia nie są gwarantowane, dlatego decyzję o oznaczeniu ważnej podstrony zawsze należy dobrze przemyśleć.
Najczęstsze pytania
Ile trwa zniknięcie podstrony z Google po dodaniu noindex?
Nie ma jednego terminu. Google musi ponownie odwiedzić podstronę, a według dokumentacji może to potrwać nawet kilka miesięcy, zależnie od znaczenia strony. Prośba o zindeksowanie w Search Console zwykle skraca oczekiwanie, a tymczasowe usunięcie pozwala ukryć adres w ciągu mniej więcej jednego dnia.
Czy noindex na jednej podstronie szkodzi pozycjom reszty serwisu?
Nie. Reguła dotyczy wyłącznie adresu, na którym została umieszczona. Wyłączenie stron technicznych i powielonych bywa wręcz korzystne, ponieważ w wynikach zostają tylko treści, które właściciel chce pokazywać. Ryzyko pojawia się dopiero wtedy, gdy noindex trafi przez pomyłkę na ważne podstrony.
Czy podstrona z noindex jest nadal dostępna dla klientów?
Tak. Noindex wpływa tylko na wyniki wyszukiwania. Podstrona otwiera się normalnie po wpisaniu adresu, po kliknięciu linku w menu, w wiadomości albo w reklamie. Jeżeli ma być niedostępna dla osób postronnych, potrzebne jest zabezpieczenie hasłem.
Czy wystarczy zablokować podstronę w pliku robots.txt?
Nie. Blokada w robots.txt zabrania robotowi odwiedzin, ale nie gwarantuje usunięcia adresu z wyników. Podstrona może się w nich nadal pojawiać, jeżeli prowadzą do niej linki. Dokumentacja Google wprost odradza stosowanie tego pliku do usuwania stron z wyszukiwarki.
Czy można wpisać regułę noindex w pliku robots.txt?
Nie. Google nie obsługuje takiego zapisu w pliku robots.txt i po prostu go ignoruje. Regułę noindex umieszcza się wyłącznie jako metatag w sekcji head podstrony albo jako nagłówek X-Robots-Tag wysyłany przez serwer.
Czym różni się noindex od Narzędzia do usuwania w Search Console?
Noindex jest rozwiązaniem trwałym, ale działa dopiero po odwiedzinach robota. Narzędzie do usuwania działa szybko, lecz ukrywa adres tylko na około 6 miesięcy. W pilnych sprawach stosuje się oba sposoby jednocześnie: narzędzie daje natychmiastowy efekt, a noindex go utrwala.
Czy noindex usuwa podstronę także z innych wyszukiwarek?
Zależy to od wyszukiwarki. Wersja z nazwą robots jest skierowana do wszystkich robotów, jednak stosują ją tylko te, które tę regułę obsługują. Google zaznacza, że inne wyszukiwarki mogą ją interpretować inaczej albo pomijać, dlatego treści poufne wymagają hasła lub usunięcia.
Czy podstrona z noindex powinna zostać w menu i w linkach wewnętrznych?
Jeżeli jest potrzebna odwiedzającym, może zostać. Strona logowania czy koszyk muszą być dostępne z menu, mimo że nie powinny wyświetlać się w Google. Linki wewnętrzne nie przeszkadzają w działaniu noindex, a nawet ułatwiają robotowi dotarcie do podstrony i odczytanie reguły.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zupełnie zrozumiałe. Wyłączenie jednej podstrony wygląda na drobiazg, ale wymaga zajrzenia do kilku miejsc naraz i odrobiny cierpliwości. Chętnie zrobię to od początku do końca: sprawdzę, co dokładnie Google ma teraz w indeksie, wskażę, które adresy powinny zniknąć z wyników, a które lepiej zostawić, ustawię noindex we właściwy sposób, uporządkuję plik robots.txt i mapę witryny, a potem dopilnuję w Search Console, żeby zmiana została odczytana i żadna ważna podstrona nie ucierpiała.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Odpowiem, co da się zrobić i ile to potrwa.