W raporcie indeksowania w Google Search Console pojawia się czasem stan „Pozorny błąd 404”. Brzmi groźnie, a jednocześnie niejasno: strona się przecież otwiera, nikt nie zgłaszał awarii, a Google mimo to nie chce pokazywać jej w wynikach. Dla właściciela firmy oznacza to jedno: adres, który miał przyciągać klientów, jest dla wyszukiwarki tak samo bezużyteczny jak strona, której nie ma.
Ta instrukcja jest przeznaczona dla osób, które same prowadzą stronę firmową, sklep lub blog i chcą zrozumieć, co dokładnie Google zobaczył pod wskazanym adresem. Nie wymaga wiedzy programistycznej, choć w kilku miejscach przyda się dostęp do panelu strony albo kontakt z osobą, która opiekuje się serwerem.
Po lekturze czytelnik będzie umiał odnaleźć listę adresów z tym stanem, sprawdzić, jak widzi je robot Google, rozpoznać przyczynę, dobrać właściwą naprawę do każdego adresu, zgłosić poprawkę i ocenić, czy przyniosła skutek.
Co oznacza „Pozorny błąd 404” i czym różni się od zwykłego błędu 404?
Każda strona internetowa, zanim wyświetli treść, wysyła krótką odpowiedź liczbową, czyli kod odpowiedzi HTTP. Kod 200 oznacza „wszystko w porządku, oto treść”. Kod 404 oznacza „pod tym adresem niczego nie ma”. Człowiek tych liczb nie widzi, ale robot Google odczytuje je jako pierwszą informację o stronie.
Pozorny błąd 404 powstaje wtedy, gdy te dwie informacje sobie przeczą. Serwer odpowiada kodem 200, czyli twierdzi, że strona istnieje, a jej treść wygląda jak strona błędu: jest pusta, prawie pusta albo zawiera komunikat w rodzaju „nie znaleziono”. Pomoc Search Console opisuje to wprost: wyświetla się przystępny komunikat o nieznalezieniu strony, ale bez kodu odpowiedzi HTTP 404.
Google rozstrzyga tę sprzeczność na podstawie treści. Jeśli jego algorytmy uznają, że strona w rzeczywistości jest stroną błędu, wyklucza ją z wyszukiwarki i pokazuje w raporcie jako „Pozorny błąd 404”. W dokumentacji dla programistów ten sam stan nosi angielską nazwę „soft 404”.
Zwykły stan „Nie znaleziono (404)” to coś innego i często nie wymaga żadnej reakcji. Usunięta strona, która uczciwie zwraca kod 404, zachowuje się poprawnie. Pozorny błąd 404 zawsze oznacza natomiast, że coś jest ustawione niezgodnie z prawdą: albo nieistniejąca strona udaje istniejącą, albo istniejąca strona wygląda dla robota na pustą.
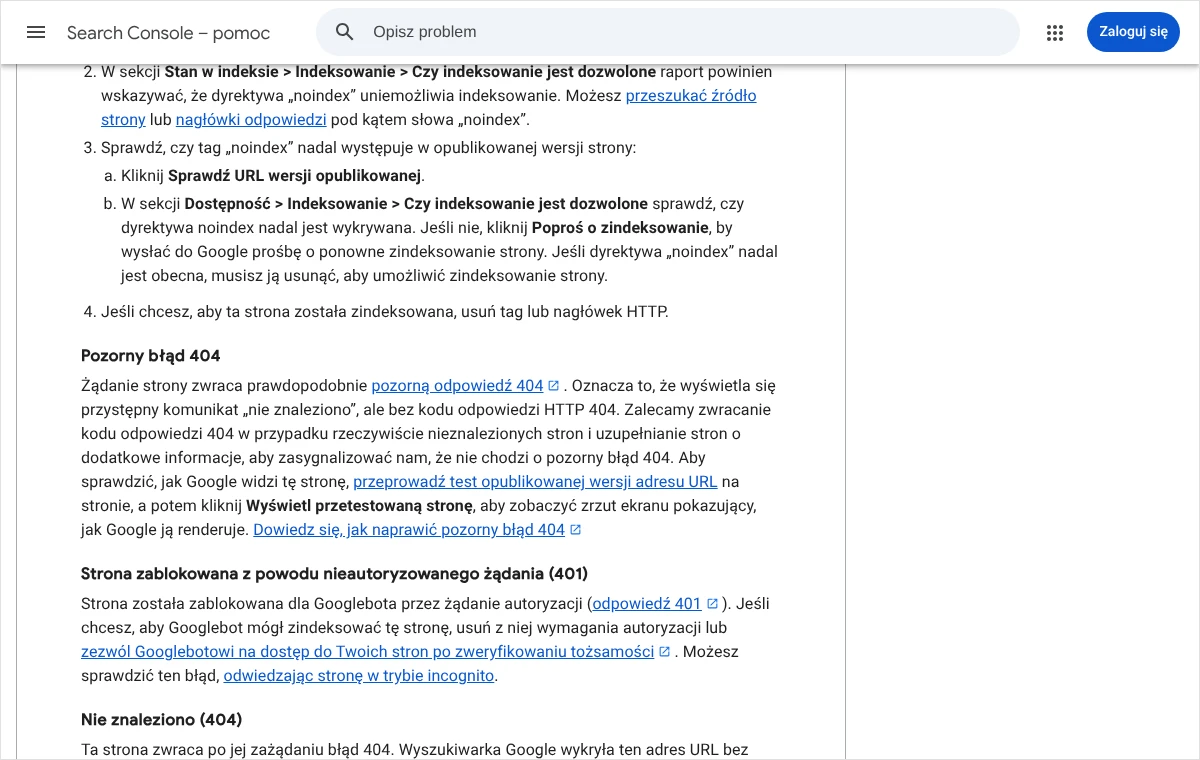
W opisie stanu Google podaje dwa zalecenia. Rzeczywiście nieznalezione strony powinny zwracać kod 404, a strony, które mają pozostać w wyszukiwarce, trzeba uzupełnić o dodatkowe informacje, tak aby było jasne, że nie są stronami błędu. Cała dalsza część tej instrukcji jest rozwinięciem tych dwóch zdań.
Gdzie w Search Console znaleźć adresy z tym stanem?
Lista adresów znajduje się w raporcie indeksowania stron. Do jego otwarcia potrzebny jest dostęp do usługi Search Console założonej dla danej witryny. Jeśli firma jeszcze jej nie ma, warto zacząć od tego, jak sprawdzić, czy Google zaindeksował stronę, bo tam opisałem podstawy pracy z tym narzędziem.
- Po zalogowaniu się do Search Console należy wskazać właściwą usługę, czyli witrynę, na liście w lewym górnym rogu.
- W menu po lewej stronie, w grupie „Indeksowanie”, trzeba kliknąć pozycję „Strony”.
- Pod wykresem znajduje się tabela „Dlaczego strony nie są indeksowane”. Każdy jej wiersz to jedna przyczyna wraz z liczbą adresów.
- W tabeli należy odszukać wiersz „Pozorny błąd 404” i go kliknąć. Otworzy się strona szczegółów z wykresem i listą przykładowych adresów.
- Listę najlepiej od razu pobrać przyciskiem „Eksportuj” w prawym górnym rogu, do arkusza albo pliku. Praca na własnej kopii ułatwia oznaczanie adresów już sprawdzonych.
Jeśli wiersza „Pozorny błąd 404” w tabeli nie ma, Google nie wykrył w witrynie takich adresów i nie ma czego naprawiać. Jeśli jest, liczy się nie tylko liczba adresów, ale przede wszystkim to, jakie to adresy.
Lista w raporcie zawiera przykłady i jest ograniczona do tysiąca wierszy, więc w dużym sklepie może nie obejmować wszystkiego. Zwykle to wystarcza, ponieważ adresy układają się w grupy: puste kategorie, wyniki wyszukiwarki wewnętrznej, wycofane produkty. Naprawa przyczyny w jednej grupie rozwiązuje problem dla wszystkich podobnych adresów naraz.
Przy każdym adresie widać datę ostatniego skanowania. Ma ona znaczenie: jeśli robot odwiedził stronę dawno, a od tego czasu coś na niej poprawiono, raport może pokazywać stan, który już nie istnieje. Dlatego przed jakąkolwiek zmianą trzeba sprawdzić stan bieżący.
Jak sprawdzić, co robot Google widzi pod danym adresem?
Do tego służy narzędzie do sprawdzania adresów URL, wbudowane w Search Console. Pokazuje ono dwie rzeczy: to, co Google zapamiętał podczas ostatniej wizyty, oraz to, co widzi teraz, po przeprowadzeniu testu na żywo. Przy pozornym błędzie 404 potrzebny jest ten drugi widok.
- Pełny adres strony wkleja się w pole wyszukiwania u góry ekranu Search Console i zatwierdza klawiszem Enter. Można też kliknąć adres na liście przykładów w raporcie i skorzystać z ikony lupy.
- Po wyświetleniu wyniku należy kliknąć „Sprawdź URL wersji opublikowanej”. Test trwa zwykle od kilkunastu sekund do kilku minut.
- Po zakończeniu testu trzeba kliknąć „Wyświetl przetestowaną stronę”.
- W panelu, który się otworzy, karta „Zrzut ekranu” pokazuje obraz strony w takiej postaci, w jakiej wyrenderował ją robot. To najważniejszy widok: od razu widać, czy strona jest pełna, pusta, czy wyświetla komunikat o błędzie.
- W części „Więcej informacji” znajdują się odpowiedź HTTP, czyli zwrócony kod, oraz lista zasobów strony, których nie udało się wczytać.
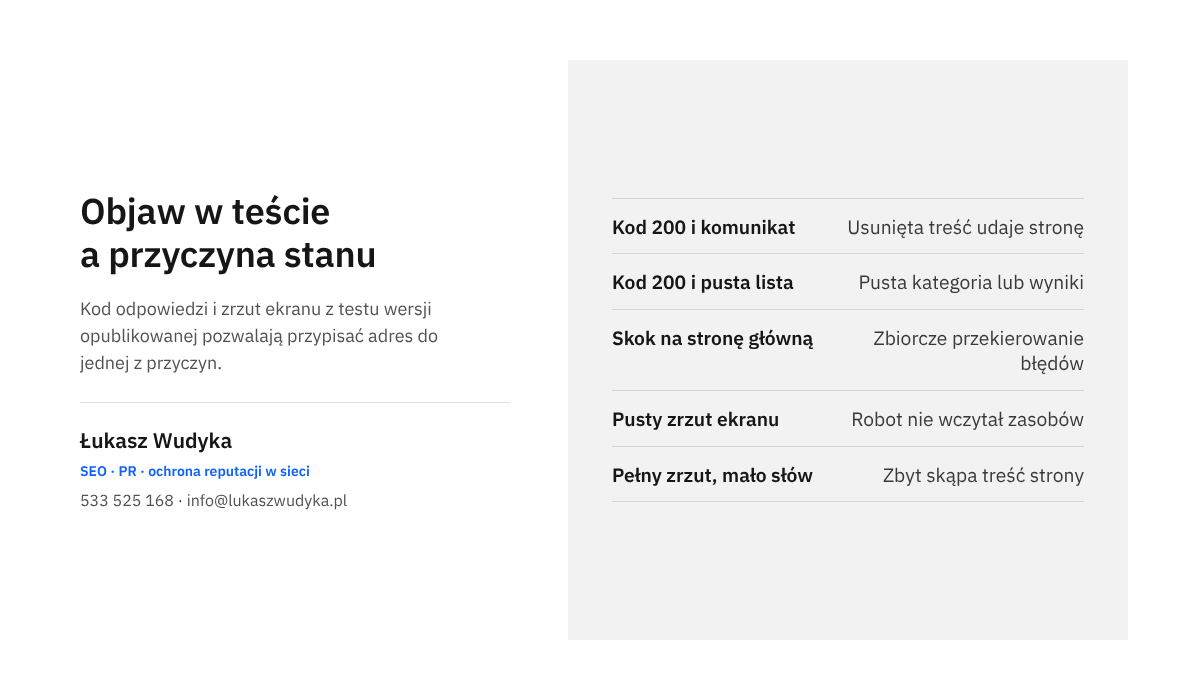
Z tego testu należy zanotować trzy rzeczy: kod odpowiedzi, wygląd zrzutu ekranu i liczbę niewczytanych zasobów. Te trzy informacje wystarczą, żeby w dalszej części przypisać adres do właściwej przyczyny.
Uwaga na jedno ograniczenie. Test wersji opublikowanej nie zawsze pokaże stan „Pozorny błąd 404”, bo ocena treści odbywa się dopiero podczas właściwego indeksowania. Test odpowiada na pytanie, co robot dostaje, a nie na pytanie, jak to ostatecznie oceni. Liczba testów na dobę jest też ograniczona, więc przy długiej liście rozsądnie jest sprawdzić po dwa lub trzy adresy z każdej grupy.
Jak odczytać kod odpowiedzi bez Search Console?
Kod odpowiedzi można zobaczyć także w zwykłej przeglądarce. W Chrome po naciśnięciu klawisza F12 otwierają się narzędzia dla programistów. Na karcie „Sieć” (w wersji angielskiej „Network”) po odświeżeniu strony pierwszy wiersz listy dotyczy samego adresu, a w kolumnie ze stanem widnieje liczba: 200, 301, 404 lub inna.
Najprostszy test polega na wpisaniu w przeglądarce adresu, który na pewno nie istnieje, na przykład domeny z dopisanym na końcu przypadkowym ciągiem liter. Jeśli strona pokaże komunikat o błędzie, a w kolumnie stanu pojawi się 200 zamiast 404, cała witryna ma źle ustawioną obsługę nieistniejących adresów. To najpoważniejszy wariant problemu, bo dotyczy nieograniczonej liczby adresów.
Skąd bierze się pozorny błąd 404? Najczęstsze przyczyny
Dokumentacja Google wymienia kilka typowych źródeł: brak pliku po stronie serwera, uszkodzone połączenie z bazą danych, pustą stronę wyników wyszukiwania wewnętrznego oraz niewczytany lub brakujący plik JavaScript. W praktyce firmowych stron i sklepów przyczyny układają się w pięć grup.
Usunięta treść, która nadal odpowiada kodem 200
Produkt wycofano, wpis skasowano, a pod starym adresem system wyświetla napis „brak produktu” albo „nie znaleziono” na zwykłej, poprawnie działającej stronie. Dla robota to klasyczny pozorny błąd 404. Rozpoznanie: zrzut ekranu z komunikatem o braku treści i kod 200 w odpowiedzi.
Puste strony tworzone automatycznie
Kategoria sklepu bez produktów, tag bez wpisów, archiwum autora, który niczego nie opublikował, wyniki wyszukiwarki wewnętrznej dla zapytania bez trafień. Takie strony mają nagłówek, menu i stopkę, ale nie mają treści głównej. Rozpoznanie: adresy z listy mają wspólny fragment, na przykład znak zapytania i parametr wyszukiwania albo ten sam katalog.
Przekierowanie wszystkiego na stronę główną
Część wtyczek i ustawień serwera wysyła każdy nieistniejący adres na stronę główną. Wydaje się to przyjazne, ale użytkownik, który szukał konkretnego produktu, trafia w miejsce bez związku z pytaniem, a Google może potraktować takie przekierowanie jak pozorny błąd 404. Rozpoznanie: kod 301 lub 302 i adres docelowy niezwiązany tematycznie ze starym.
Strona istnieje, ale robot nie mógł jej wczytać
Według dokumentacji działająca strona może dostać ten stan, gdy nie wczytała się prawidłowo podczas wizyty robota, zabrakło jej ważnych zasobów albo podczas renderowania pojawił się wyraźny komunikat o błędzie. Zasoby bywają zablokowane w pliku robots.txt, jest ich zbyt wiele, są za duże, wczytują się zbyt wolno albo serwer odpowiada błędami. Rozpoznanie: człowiek widzi pełną stronę, a zrzut ekranu w teście jest pusty lub niepełny.
Strona istnieje, ale ma bardzo mało treści
Podstrona z jednym zdaniem, karta produktu z samym zdjęciem i napisem „produkt niedostępny”, strona „w budowie”. Jeśli na stronie widnieje sformułowanie przypominające komunikat o błędzie, a treści głównej prawie nie ma, algorytm może uznać ją za stronę błędu. Rozpoznanie: zrzut ekranu zgodny z tym, co widzi człowiek, kod 200, a mimo to niewiele do przeczytania.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: przejrzę listę adresów z raportu, ustalę przyczynę dla każdej grupy i przygotuję konkretne poprawki do wdrożenia na stronie.
Jak dobrać naprawę do adresu? Trzy sytuacje
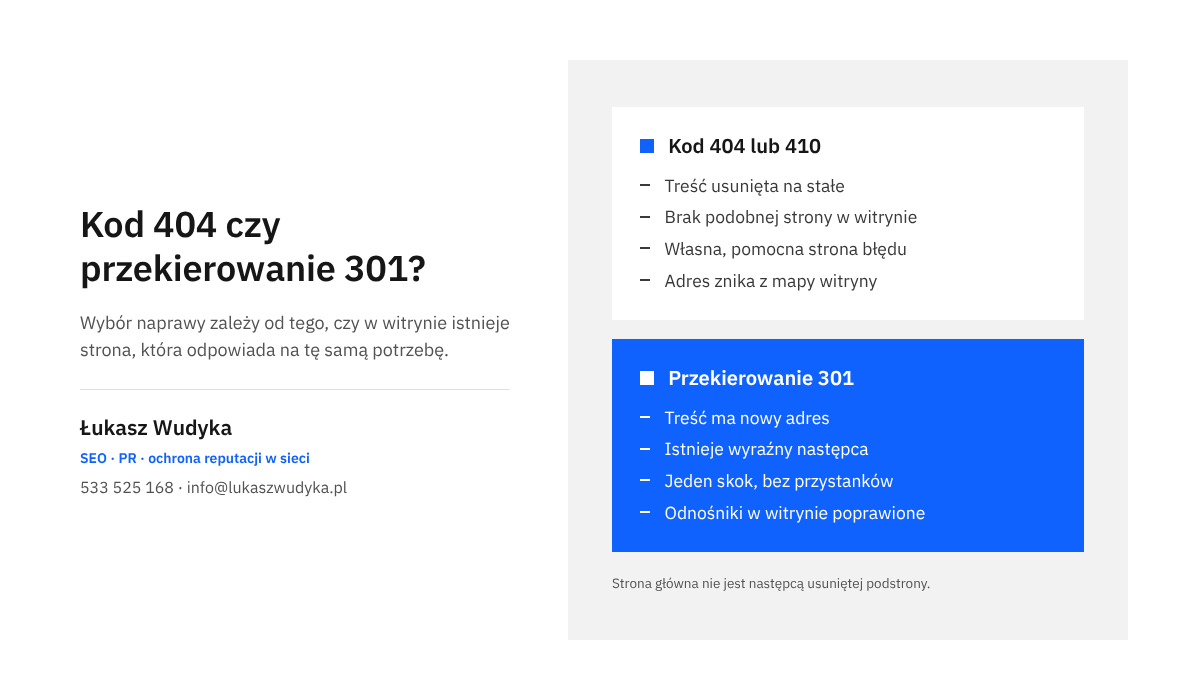
Google dzieli naprawę na trzy przypadki, zależnie od tego, co stało się z treścią. Przed jakąkolwiek zmianą należy przypisać każdy adres, albo każdą grupę adresów, do jednego z nich.
- Strona i jej zawartość nie są już dostępne i nie mają następcy: adres powinien zwracać kod 404 albo 410.
- Strona lub jej zawartość mają nową lokalizację: stary adres powinien prowadzić przekierowaniem 301 do nowego.
- Strona i jej zawartość nadal istnieją: trzeba ustalić, dlaczego robot uznał ją za stronę błędu, i usunąć tę przyczynę.
Dokumentacja radzi kierować się tym, co będzie najlepsze dla użytkowników. To dobra miara. Jeśli ktoś wszedłby pod stary adres z zakładki w przeglądarce, to czy istnieje w witrynie strona, która odpowiada na tę samą potrzebę? Jeśli tak, przekierowanie. Jeśli nie, uczciwy kod 404.
Radzę nie zaczynać od adresów pojedynczych, tylko od wzorców. Jedna źle ustawiona reguła potrafi odpowiadać za setki pozycji w raporcie, a jej poprawienie zajmuje mniej czasu niż ręczne przekierowanie dziesięciu adresów.
Strona nie istnieje i nie ma następcy: jak ustawić prawdziwy kod 404?
Jeśli strona została usunięta i w witrynie nie ma strony zastępczej o podobnej zawartości, powinna zwracać kod 404 („nie znaleziono”) albo 410 („usunięto na stałe”). Oba kody mówią wyszukiwarkom, że strona nie istnieje i nie ma być indeksowana. Google traktuje je bardzo podobnie, więc wybór między nimi nie jest istotny dla wyniku.
W WordPressie nieistniejące adresy standardowo zwracają kod 404 i wyświetlają szablon strony błędu z motywu. Jeśli test z przypadkowym adresem pokazał kod 200 albo przekierowanie, przyczyną jest zwykle dodatek. Należy przejrzeć zainstalowane wtyczki pod kątem funkcji przekierowywania błędów 404 na stronę główną i tę funkcję wyłączyć. Tak samo trzeba postąpić z regułami przekierowań dopisanymi ręcznie w pliku .htaccess.
Na serwerach Apache własną stronę błędu wskazuje się w pliku .htaccess jednym wierszem:
ErrorDocument 404 /404.htmlŚcieżka musi być lokalna, czyli zaczynać się od ukośnika. Wpisanie w tym miejscu pełnego adresu z nazwą domeny powoduje, że serwer wysyła przekierowanie, a odwiedzający i robot nie otrzymują kodu 404. To jedna z częstszych przyczyn pozornych błędów 404 na stronach pisanych ręcznie.
Gdy pojedynczy adres ma zostać oznaczony jako trwale usunięty, w tym samym pliku można dopisać wiersz:
Redirect gone /stary-adres/Plik .htaccess jest wrażliwy: jedna literówka potrafi wyłączyć całą witrynę. Przed zmianą należy pobrać jego kopię na dysk, a po zapisaniu od razu otworzyć stronę główną i kilka podstron. Szczegółowo opisałem to przy okazji przekierowań 301 w pliku .htaccess.
Co zrobić ze stronami budowanymi przez JavaScript?
W aplikacjach, w których treść powstaje dopiero w przeglądarce, serwer często odpowiada kodem 200 na każdy adres. Dokumentacja Google wskazuje dwa wyjścia. Pierwsze to przekierowanie skryptem na adres, pod którym serwer zwraca kod 404. Drugie to dodanie skryptem do strony błędu znacznika <meta name="robots" content="noindex">. Jest to zadanie dla programisty i wystarczy przekazać mu te dwa zdania.
Jak powinna wyglądać dobra strona błędu?
Kod 404 nie oznacza brzydkiej, pustej strony. Dokumentacja zachęca do przygotowania własnej strony błędu, która pomaga odwiedzającym znaleźć to, czego szukali. Powinna jasno informować, że strony nie znaleziono, wyglądać jak reszta serwisu, zawierać menu, wyszukiwarkę oraz odnośniki do strony głównej i najważniejszych działów. Warunek jest jeden: przy całej swojej przyjazności nadal musi zwracać kod 404.
Puste wyniki wyszukiwania wewnętrznego
Strony wyników wyszukiwarki wbudowanej w witrynę nie powinny w ogóle trafiać do indeksu. Najprostszym zabezpieczeniem jest znacznik <meta name="robots" content="noindex"> na wszystkich stronach wyników. Popularne wtyczki SEO do WordPressa mają do tego gotowe ustawienie w części dotyczącej widoczności stron specjalnych.
Strona ma nowy adres: jak ustawić przekierowanie 301?
Jeśli treść została przeniesiona albo w witrynie istnieje jej wyraźny następca, stary adres powinien zwracać przekierowanie 301, czyli stałe. Dokumentacja podkreśla, że nie zakłóca to przeglądania witryny i jest dobrym sposobem poinformowania wyszukiwarek o nowej lokalizacji.
Wyraźny następca to strona, która odpowiada na tę samą potrzebę: nowsza wersja tego samego produktu, zaktualizowany wpis na ten sam temat, ta sama usługa pod zmienionym adresem. Strona główna następcą nie jest. Kategoria bywa następcą produktu tylko wtedy, gdy odwiedzający znajdzie w niej bardzo podobny towar.
Na serwerze Apache pojedyncze przekierowanie zapisuje się w pliku .htaccess tak:
Redirect 301 /stary-adres/ https://www.przyklad.pl/nowy-adres/W WordPressie wygodniej użyć wtyczki do przekierowań albo modułu przekierowań we wtyczce SEO. W obu przypadkach podaje się adres źródłowy, adres docelowy i typ 301.
Przekierowanie powinno prowadzić wprost do strony końcowej, bez przystanków pośrednich. Po ustawieniu należy sprawdzić stary adres w narzędziu do sprawdzania adresów URL i upewnić się, że zwracany kod jest poprawny. Trzeba też poprawić odnośniki w samej witrynie, tak aby prowadziły od razu pod nowy adres.
Strona istnieje i jest potrzebna: jak pokazać Google, że to nie strona błędu?
To przypadek najbardziej kosztowny, bo dotyczy stron, które miały pracować na sprzedaż. Postępowanie zależy od tego, co pokazał zrzut ekranu w teście wersji opublikowanej.
Zrzut ekranu jest pusty albo niepełny
Skoro człowiek widzi treść, a robot nie, problem leży w zasobach. W części „Więcej informacji” należy przejrzeć listę zasobów, których nie udało się wczytać. Jeśli przy plikach stylów lub skryptów widnieje informacja o blokadzie przez plik robots.txt, trzeba usunąć z tego pliku reguły zamykające robotowi dostęp do katalogów z plikami motywu, wtyczek i skryptów.
Zasady działania tego pliku i bezpieczne wzory wpisów zebrałem w tekście o tym, jak ustawić plik robots.txt. Ogólna reguła jest prosta: robot ma mieć dostęp do wszystkiego, czego przeglądarka potrzebuje do narysowania strony.
Jeśli zasoby nie są zablokowane, a mimo to się nie wczytują, przyczyną bywa ich liczba, rozmiar, powolne działanie albo błędy serwera. Wtedy pomaga ograniczenie liczby skryptów, zmniejszenie ciężkich plików oraz rozmowa z firmą hostingową o stabilności serwera. Istotne jest też to, aby najważniejsza treść, czyli nagłówek, opis i cena, znajdowała się w kodzie strony od razu, a nie była dociągana dopiero po dłuższej chwili.
Na zrzucie ekranu widać komunikat o błędzie
Zdarza się, że podczas wizyty robota strona wyświetliła komunikat o błędzie bazy danych albo pustą listę, choć zwykle działa poprawnie. Oznacza to chwilową awarię albo przeciążenie serwera. Należy sprawdzić dziennik błędów w panelu hostingu i ustalić, czy awarie się powtarzają. Jeśli tak, naprawa samej strony nic nie da, dopóki serwer nie zacznie działać stabilnie.
Zrzut ekranu jest poprawny, ale treści jest mało
Tu sprawdza się drugie zalecenie Google: uzupełnić stronę o informacje, które pokażą, że nie jest stroną błędu. Karta produktu powinna mieć własny opis, parametry i zdjęcia. Strona usługi powinna mówić, co obejmuje usługa, dla kogo jest i jak ją zamówić. Kategoria powinna mieć przynajmniej krótki opis i rzeczywiste pozycje.
Trzeba też przejrzeć słownictwo. Napisy „nie znaleziono”, „brak wyników”, „strona nie istnieje” albo „produkt niedostępny”, umieszczone jako główny element strony, przypominają komunikat o błędzie. Przy czasowo niedostępnym produkcie lepiej zostawić pełny opis i dopisać informację o terminie dostawy albo o możliwości powiadomienia o powrocie towaru.
Jeśli pustej strony nie da się sensownie wypełnić, nie ma powodu utrzymywać jej w indeksie. Pustą kategorię lub tag można ukryć do czasu, aż pojawi się w nich zawartość, albo usunąć i pozwolić, aby adres zwracał kod 404.
Jak zgłosić poprawkę i po czym poznać, że zadziałała?
Po wdrożeniu zmian Google sam je kiedyś zauważy, ale można ten proces przyspieszyć i śledzić. Najpierw należy ponownie przetestować kilka adresów w narzędziu do sprawdzania adresów URL i upewnić się, że kod odpowiedzi oraz zrzut ekranu są już takie, jak zaplanowano. Dopiero potem ma sens zgłoszenie poprawki.
- W raporcie „Strony” należy ponownie otworzyć wiersz „Pozorny błąd 404”, czyli stronę szczegółów problemu.
- Trzeba kliknąć „Sprawdź poprawkę”. Przycisku nie należy klikać ponownie, dopóki weryfikacja się nie zakończy.
- Postęp widać w historii weryfikacji na tej samej stronie. Stan zmienia się z „Rozpoczęto” na „Powodzenie” albo „Niepowodzenie”.
- Przy niepowodzeniu należy kliknąć „Sprawdź szczegóły”, poprawić adresy, które nie przeszły, i uruchomić proces od nowa przyciskiem „Rozpocznij nową weryfikację”.
Według pomocy Search Console weryfikacja zajmuje zwykle do dwóch tygodni, a w niektórych przypadkach znacznie dłużej. Nie należy w tym czasie niczego wymuszać. Najgorsze, co można zrobić, to po trzech dniach uznać, że naprawa nie działa, i wprowadzić kolejną zmianę.
Dla stron, które mają wrócić do wyników, można dodatkowo użyć przycisku „Poproś o zindeksowanie” w narzędziu do sprawdzania adresów URL. Obowiązuje dzienny limit takich próśb, więc warto zachować je dla najważniejszych podstron. Przy większej liczbie adresów lepiej zadbać o aktualną mapę witryny, o czym piszę w tekście o zgłaszaniu mapy witryny w Search Console.
Jak wygląda prawidłowy wynik?
Powodzenie nie oznacza, że adresy znikną z raportu. Oznacza, że przejdą do innego, właściwego wiersza. Usunięte strony pojawią się w stanie „Nie znaleziono (404)”, co jest poprawne i nie wymaga działań. Adresy przekierowane trafią do stanu „Strona zawiera przekierowanie”. Strony uzupełnione o treść powinny przejść do stron zindeksowanych.
Liczba w wierszu „Pozorny błąd 404” powinna z tygodnia na tydzień maleć. Wykres na stronie szczegółów pokazuje to wyraźnie i jest najprostszym miernikiem postępu.
Co zrobić, gdy stan nie znika albo wraca?
Najpierw należy porównać datę ostatniego skanowania przy adresie z datą wdrożenia poprawki. Jeśli robot nie odwiedził strony po zmianie, raport pokazuje jeszcze stary stan i wystarczy cierpliwość.
Jeśli skanowanie odbyło się po zmianie, a stan pozostał, trzeba powtórzyć test wersji opublikowanej i jeszcze raz spojrzeć na zrzut ekranu. Częste powody to pamięć podręczna, która nadal serwuje starą wersję strony, poprawka wdrożona tylko dla części adresów oraz treść nadal zbyt skąpa. Po każdej zmianie w ustawieniach należy wyczyścić pamięć podręczną wtyczki i serwera.
Gdy w raporcie stale przybywa nowych adresów, źródło problemu wciąż działa. Wtedy trzeba ustalić, skąd robot bierze te adresy: z mapy witryny, z odnośników w menu i filtrach, czy z automatycznie tworzonych archiwów. Dopóki witryna sama podsuwa robotowi puste strony, lista będzie rosła.
Jakich błędów unikać przy naprawie?
Większość kłopotów z tym stanem nie wynika z zaniedbania, lecz z naprawy przeprowadzonej w dobrej wierze, ale nietrafnie. Poniższych działań radzę unikać.
- Przekierowanie wszystkich adresów z listy na stronę główną. Nie rozwiązuje to problemu, a jedynie zmienia jego postać.
- Blokowanie adresów w pliku robots.txt. Robot przestaje je odwiedzać, więc nigdy nie zobaczy poprawionego kodu odpowiedzi, a adres może pozostać w indeksie bez opisu.
- Ukrywanie pustych stron przez dopisywanie do nich przypadkowego lub powielonego tekstu. Treść ma być użyteczna dla odwiedzającego, inaczej strona pozostanie mało wartościowa.
- Pozostawianie usuniętych adresów w mapie witryny. Mapa ma zawierać wyłącznie strony, które istnieją i mają być indeksowane.
- Usuwanie stron, które mają odwiedziny i odnośniki z innych serwisów, bez przekierowania do następcy. To strata ruchu, którą trudno potem odrobić.
- Wielokrotne klikanie „Sprawdź poprawkę” albo zgłaszanie poprawki przed sprawdzeniem, czy zmiana rzeczywiście działa.
Uważam też, że nie należy dążyć do zera za wszelką cenę. W dużym sklepie pojedyncze adresy z tym stanem będą się pojawiać, bo oferta się zmienia. Istotne jest, aby na liście nie było stron ważnych dla sprzedaży i aby nie rosła ona w sposób niekontrolowany.
Raport warto przeglądać regularnie, na przykład raz w miesiącu, a obowiązkowo po każdej większej zmianie: przebudowie sklepu, zmianie motywu, wymianie wtyczki SEO lub przeniesieniu strony na inny serwer. Właśnie po takich pracach pozorne błędy 404 pojawiają się najczęściej.
Najczęstsze pytania
Czy pozorny błąd 404 obniża pozycje całej witryny?
Sam stan dotyczy konkretnych adresów: są one wykluczone z wyszukiwarki i nie przynoszą ruchu. Nie jest to kara nałożona na witrynę. Duża liczba takich adresów oznacza jednak, że robot poświęca czas na strony bez wartości zamiast na te, które powinny być indeksowane, co w rozbudowanych serwisach opóźnia odświeżanie ważnych podstron.
Czym różni się kod 404 od kodu 410?
Kod 404 informuje, że strony nie znaleziono, a kod 410, że została usunięta na stałe. Dokumentacja Google wymienia oba jako poprawne dla stron, które nie istnieją i nie mają następcy, i traktuje je bardzo podobnie. W większości firmowych witryn wystarcza kod 404, ponieważ systemy zarządzania treścią ustawiają go samodzielnie.
Strona wyświetla się poprawnie, dlaczego więc Google widzi błąd?
Robot nie zawsze widzi to samo co człowiek. Mógł trafić na chwilową awarię, nie wczytać skryptów zablokowanych w pliku robots.txt albo nie doczekać się treści dociąganej z opóźnieniem. Rozstrzyga to test wersji opublikowanej i karta „Zrzut ekranu” w narzędziu do sprawdzania adresów URL, która pokazuje stronę oczami robota.
Czy można przekierować wszystkie błędne adresy na stronę główną?
Technicznie można, ale nie należy. Odwiedzający trafia w miejsce, które nie odpowiada na jego pytanie, a Google może potraktować takie przekierowanie jak pozorny błąd 404. Przekierowanie ma sens tylko wtedy, gdy strona docelowa jest rzeczywistym następcą starej. W pozostałych przypadkach właściwy jest kod 404 i pomocna strona błędu.
Ile trwa zniknięcie adresów z raportu po naprawie?
Pomoc Search Console podaje, że weryfikacja poprawki zajmuje zwykle do dwóch tygodni, a czasem znacznie dłużej. Zależy to od tego, jak często robot odwiedza daną witrynę. Małe strony, na których rzadko pojawia się coś nowego, są skanowane rzadziej, więc na pełne odświeżenie raportu trzeba poczekać dłużej.
Czy produkt chwilowo niedostępny powinien zwracać kod 404?
Nie. Jeśli towar wróci do oferty, strona powinna pozostać dostępna, zwracać kod 200 i zachować pełny opis, zdjęcia oraz parametry. Wystarczy wyraźna informacja o braku w magazynie i przewidywanym terminie dostawy. Kod 404 albo przekierowanie stosuje się dopiero wtedy, gdy produkt został wycofany na stałe.
Czy pusta kategoria w sklepie zawsze dostanie ten stan?
Nie zawsze, ale ryzyko jest duże, bo strona bez żadnej pozycji i z napisem o braku produktów wygląda jak strona błędu. Bezpieczniej jest nie publikować kategorii, dopóki nie ma w niej towaru, a istniejącą pustą kategorię ukryć lub usunąć. Jeśli ma zostać, powinna mieć własny opis i odnośniki do pokrewnych działów.
Czy trzeba naprawiać adresy, których nikt nigdy nie tworzył?
W raporcie pojawiają się czasem dziwne adresy z parametrami albo z błędnie przepisanymi odnośnikami z innych serwisów. Pojedynczych przypadków nie trzeba poprawiać ręcznie. Należy natomiast sprawdzić, czy zwracają kod 404. Jeśli tak się dzieje, problem zniknie sam po kolejnym skanowaniu. Jeśli zwracają kod 200, to znak, że obsługa nieistniejących adresów w całej witrynie wymaga poprawy.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zrozumiałe. Kody odpowiedzi, przekierowania i pliki serwera nie są zajęciem, na które właściciel firmy ma czas między klientami. Chętnie zajmę się tym od początku do końca: pobiorę listę adresów z Search Console, sprawdzę, co pod każdą grupą widzi robot Google, ustalę przyczynę, przygotuję i wdrożę poprawki albo przekażę je w gotowej postaci osobie opiekującej się stroną, a potem zgłoszę naprawę i dopilnuję, żeby raport się oczyścił.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Odpowiem, co widzę w raporcie i co proponuję zrobić w pierwszej kolejności.