W raporcie „Indeksowanie stron” w Google Search Console pojawia się czasem ostrzeżenie, które na pierwszy rzut oka przeczy samo sobie: „Strona zindeksowana, ale zablokowana przez plik robots.txt”. Skoro robot dostał zakaz wstępu, to dlaczego adres i tak znalazł się w wyszukiwarce? Odpowiedź jest prosta, ale wymaga zrozumienia, że plik robots.txt zamyka drzwi przed robotem, a nie przed wynikami wyszukiwania.
Ten tekst jest instrukcją dla właścicieli firm i osób, które same opiekują się swoją stroną. Nie trzeba być programistą, żeby poradzić sobie z tym ostrzeżeniem. Wystarczy dostęp do Search Console i możliwość edycji pliku robots.txt albo ustawień strony.
Po lekturze będzie wiadomo, jak odnaleźć adresy objęte ostrzeżeniem, jak ustalić, która reguła je blokuje, jak zdecydować, czy stronę należy odblokować, czy trwale ukryć, oraz jak sprawdzić, że naprawa zadziałała. Kolejność ma tu duże znaczenie, bo najczęstszy błąd polega na wykonaniu dobrych czynności w złej kolejności.
Co dokładnie oznacza komunikat „Strona zindeksowana, ale zablokowana przez plik robots.txt”?
Dokumentacja Search Console opisuje ten stan jednym zdaniem: strona została zindeksowana, mimo że została zablokowana przez plik robots.txt w witrynie. Google przestrzega instrukcji z tego pliku, więc nie wysyła żądania skanowania i nie czyta treści strony. Może jednak dodać sam adres do indeksu, jeśli prowadzi do niego link z innego miejsca.
W praktyce oznacza to, że Google wie o istnieniu adresu, ale nie wie, co się pod nim znajduje. Informacje o stronie czerpie wtedy z otoczenia, przede wszystkim z tekstu linków, które do niej prowadzą. Według dokumentacji taki adres może pojawiać się w wynikach wyszukiwania, ale bez opisu.
Search Console traktuje ten stan jako ostrzeżenie, a nie jako błąd. Strona jest liczona jako zindeksowana, jednak Google sygnalizuje, że coś tu się nie zgadza: albo strona miała być widoczna i wtedy blokada szkodzi, albo miała być ukryta i wtedy blokada nie spełnia swojego zadania.
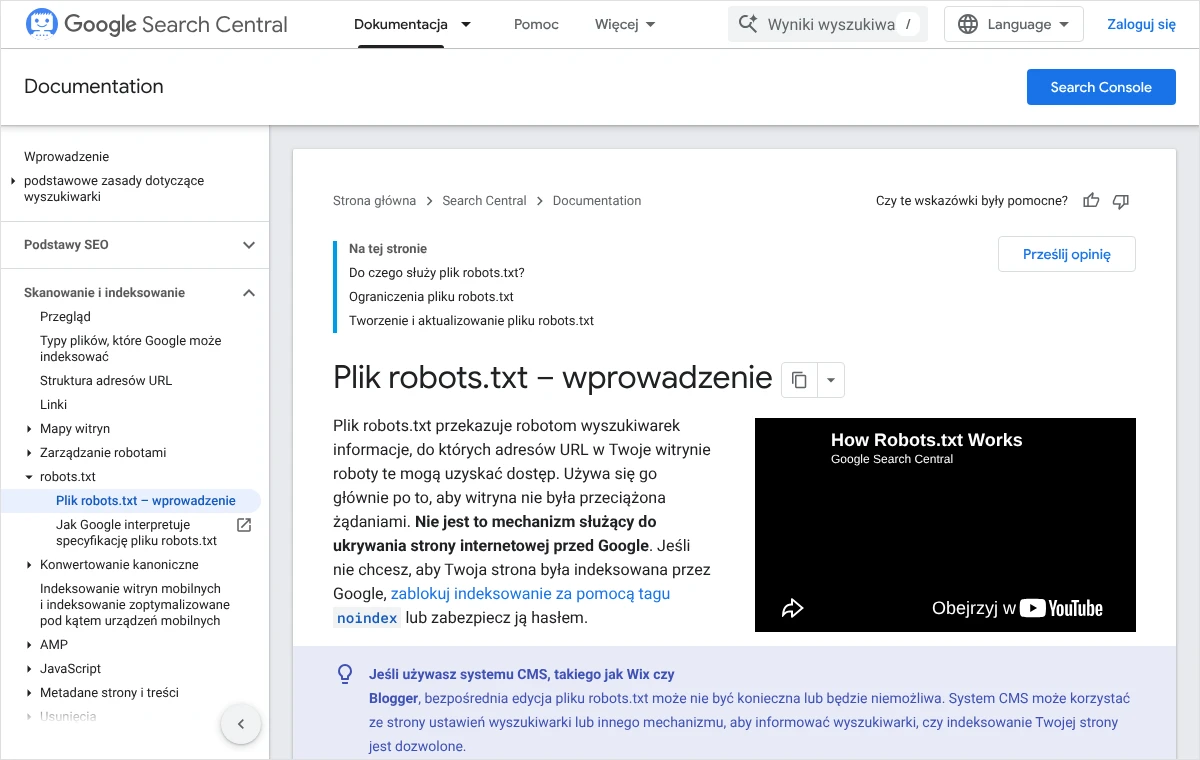
Źródłem całego zamieszania jest przekonanie, że robots.txt służy do ukrywania stron. Google pisze wprost, że nie jest to mechanizm służący do ukrywania strony internetowej przed wyszukiwarką. Plik ten powstał po to, aby kierować ruchem robotów i chronić serwer przed nadmiarem żądań.
Tego ostrzeżenia nie należy mylić z podobnie brzmiącym stanem „Zablokowana przez plik robots.txt”. Tam adres jest zablokowany i nie trafił do indeksu. Jeśli w raporcie widać właśnie ten drugi stan, lepiej sięgnąć po osobną instrukcję: jak znaleźć regułę, która blokuje stronę w pliku robots.txt.
Skąd Google zna adres, którego nie wolno mu skanować?
Robot nie musi wejść na stronę, żeby dowiedzieć się o jej istnieniu. Wystarczy, że adres pojawi się w miejscu, które robot może przeczytać. Najczęściej zachodzi jedna z poniższych sytuacji.
- Do zablokowanej strony prowadzą linki z innych podstron tego samego serwisu, na przykład z menu, stopki, filtrów w sklepie albo wewnętrznej wyszukiwarki.
- Do zablokowanej strony linkuje inna witryna: katalog, forum, portal branżowy, serwis partnera.
- Adres znajduje się w mapie witryny przesłanej do Search Console, choć jednocześnie robots.txt zabrania jego skanowania.
- Strona była kiedyś dostępna i zindeksowana, a blokadę dodano później, licząc na to, że adres zniknie z wyników.
- Blokada jest pozostałością po pracach nad stroną, na przykład po wersji testowej, i obejmuje więcej adresów, niż ktokolwiek planował.
Czwarta sytuacja zdarza się wyjątkowo często. Właściciel chce usunąć podstronę z Google, dopisuje regułę w robots.txt i czeka. Tymczasem adres zostaje w indeksie, bo robot nie może już wejść na stronę i przekonać się, że powinna zniknąć.
Jak znaleźć w Search Console adresy objęte ostrzeżeniem?
Pierwsza czynność to sporządzenie listy adresów. Bez niej każda dalsza decyzja będzie zgadywaniem. Search Console pokazuje przykładowe adresy dla każdego stanu, a listę można pobrać do pliku.
- Po zalogowaniu do Google Search Console należy wybrać właściwą usługę, czyli witrynę, której dotyczy ostrzeżenie.
- W menu po lewej stronie, w części „Indeksowanie”, trzeba otworzyć raport „Strony”. Dokumentacja nazywa go raportem „Indeksowanie stron”.
- Pod wykresem widać tabelę „Dlaczego strony nie są indeksowane”. Ostrzeżenia dotyczące stron zindeksowanych znajdują się w osobnej tabeli poniżej, opisanej w dokumentacji jako „Popraw wygląd i działanie stron”.
- Należy kliknąć wiersz „Strona zindeksowana, ale zablokowana przez plik robots.txt”. Otworzy się strona szczegółów z wykresem i listą przykładowych adresów.
- Listę warto pobrać przyciskiem eksportu w prawym górnym rogu strony szczegółów. Plik w arkuszu ułatwia późniejsze grupowanie adresów.
Trzeba mieć świadomość jednego ograniczenia. Według dokumentacji lista przykładowych adresów w raporcie obejmuje maksymalnie 1000 elementów. Przy dużym sklepie lista nie pokaże więc wszystkiego, ale wystarczy, aby rozpoznać wzorce.
Jak pogrupować adresy, żeby zobaczyć wzorzec?
Adresy z listy rzadko są przypadkowe. Zwykle układają się w kilka grup o wspólnym początku albo wspólnym parametrze: adresy z fragmentem „?sort=”, adresy z katalogu koszyka, adresy wewnętrznej wyszukiwarki, pliki PDF z jednego folderu. Wystarczy posortować kolumnę z adresami alfabetycznie, a grupy staną się widoczne.
Przy każdej grupie należy od razu zapisać odpowiedź na jedno pytanie: czy te strony powinny być widoczne w Google? Dla ofert, wpisów i stron usług odpowiedź brzmi „tak”. Dla koszyka, panelu klienta, wyników filtrowania i wersji testowych najczęściej brzmi „nie”. Ta notatka przesądzi o dalszej drodze.
Jak ustalić, która reguła blokuje dany adres?
Zanim cokolwiek zostanie zmienione, trzeba wiedzieć, który wiersz pliku robots.txt odpowiada za blokadę. Dokumentacja Google wskazuje do tego narzędzie do sprawdzania adresów URL w Search Console.
- W pasku wyszukiwania u góry Search Console wpisuje się pełny adres strony z listy i zatwierdza klawiszem Enter. Można też najechać kursorem na adres w raporcie i skorzystać z ikony sprawdzania przy adresie.
- W wynikach należy rozwinąć sekcję „Indeksowanie stron”. Pole „Czy skanowanie jest dozwolone” pokaże, czy plik robots.txt blokuje Google.
- Następnie trzeba kliknąć „Sprawdź URL wersji opublikowanej”. Test na żywo pokazuje stan obecny, a nie stan z ostatniej wizyty robota, więc pozwala potwierdzić, że blokada nadal działa.
- W osobnej karcie przeglądarki należy otworzyć sam plik, dopisując do adresu domeny końcówkę
/robots.txt, i odszukać w nim regułę pasującą do sprawdzanego adresu.
Jak czytać plik robots.txt?
Plik składa się z grup. Każda grupa zaczyna się od wiersza User-agent, który wskazuje robota, a pod nim znajdują się wiersze Disallow (zakaz) i Allow (zgoda). Gwiazdka w wierszu User-agent: * oznacza wszystkie roboty. Jeśli w pliku istnieje osobna grupa dla robota Googlebot, to właśnie ona obowiązuje Google.
Reguła blokuje wszystkie adresy, których ścieżka zaczyna się od podanego ciągu znaków. Wiersz Disallow: /oferta zablokuje więc nie tylko katalog „/oferta/”, ale także adres „/oferta-specjalna”. Wielkość liter jest rozróżniana, a gwiazdka wewnątrz ścieżki zastępuje dowolny ciąg znaków.
Najgroźniejsza reguła jest zarazem najkrótsza. Poniższe dwa wiersze zamykają przed robotami całą witrynę:
User-agent: *
Disallow: /
Jeśli taki zapis widnieje w pliku działającej strony firmowej, jest to niemal na pewno pozostałość po budowie serwisu. Szersze omówienie składni, razem z przykładami, znajduje się w tekście o tym, jak ustawić plik robots.txt.
Gdzie sprawdzić, jaką wersję pliku widzi Google?
Search Console ma osobny raport dotyczący pliku robots.txt. Znajduje się on w „Ustawieniach” usługi, w części poświęconej skanowaniu. Raport pokazuje kolumny „Ścieżka pliku”, „Stan pobierania”, „Sprawdzono”, „Rozmiar” i „Problemy”.
Stan „Pobrano” oznacza, że Google odczytał plik. Kolumna „Problemy” informuje, czy któryś wiersz zawiera błąd składni. Raport przydaje się szczególnie wtedy, gdy plik był niedawno zmieniany i nie ma pewności, czy Google zna już nową wersję.
Odblokować stronę czy ją ukryć? Jak podjąć decyzję
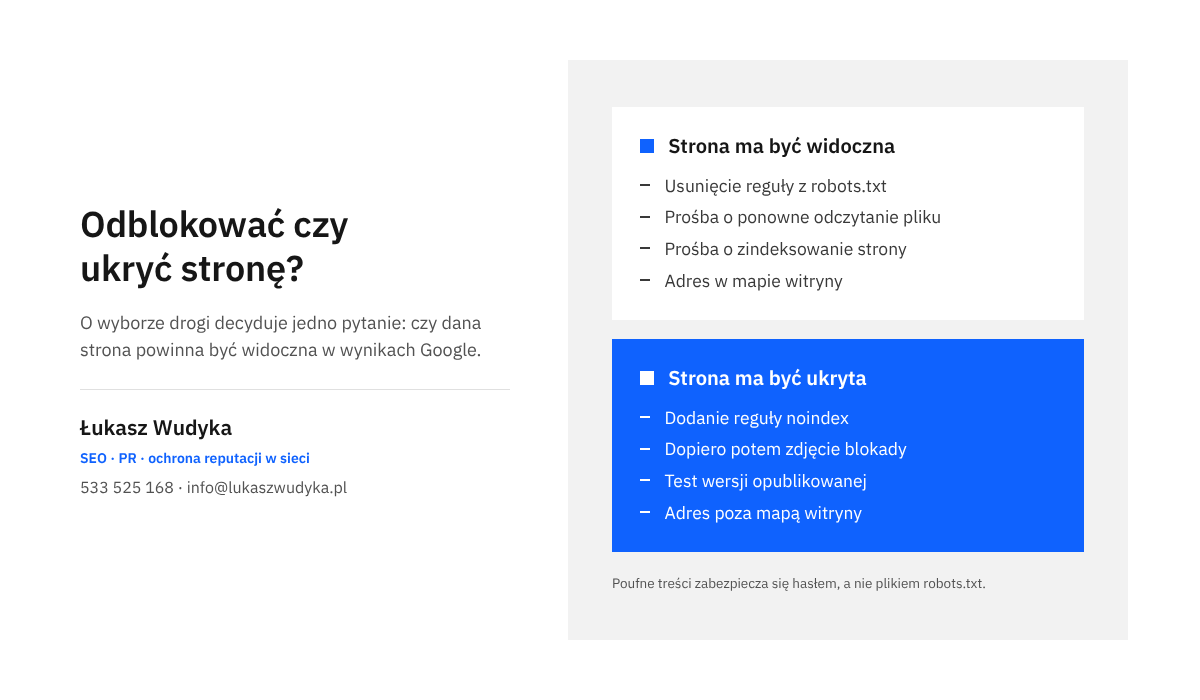
Ostrzeżenie ma dwa rozwiązania, które prowadzą w przeciwnych kierunkach. O wyborze decyduje wyłącznie to, czy strona powinna być widoczna w Google. Nie ma jednej odpowiedzi dla całej listy, dlatego decyzję podejmuje się osobno dla każdej grupy adresów.
Jeśli strona ma być widoczna, trzeba usunąć blokadę. Dopiero wtedy Google przeczyta treść, pokaże właściwy tytuł i opis oraz oceni stronę na podstawie tego, co się na niej znajduje. Dopóki blokada trwa, strona konkuruje w wynikach samym adresem, bez opisu.
Jeśli strona ma być ukryta, blokadę także trzeba usunąć, a jednocześnie dodać regułę noindex albo zabezpieczyć stronę hasłem. Brzmi to przewrotnie, ale wynika wprost z dokumentacji: robot musi móc wejść na stronę, żeby odczytać zakaz indeksowania.
Istnieje jeszcze trzecia możliwość, o której dokumentacja mówi niewiele: świadome pozostawienie stanu bez zmian. Uważam, że jest to rozsądne tylko dla adresów czysto technicznych, których nikt nie wyszukuje i które nie zawierają niczego wrażliwego. Ostrzeżenie pozostanie wtedy w raporcie, ale nie będzie szkodzić reszcie witryny.
Tej trzeciej drogi nie wolno wybierać dla stron z danymi, których nie powinny oglądać osoby postronne. Robots.txt nie chroni treści przed ludźmi, a sam plik jest publiczny, więc każdy może przeczytać listę „zakazanych” katalogów. Takie zasoby zabezpiecza się hasłem.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: przejrzę listę adresów z ostrzeżeniem, ustalę blokujące reguły, wskażę, co odblokować, a co ukryć, i dopilnuję, żeby Google przyjął poprawkę.
Jak odblokować stronę, która powinna być widoczna w Google?
Odblokowanie polega na zmianie albo usunięciu jednego wiersza w pliku robots.txt. Czynność jest prosta, ale wymaga ostrożności, ponieważ błąd w tym pliku wpływa na całą witrynę. Przed zmianą trzeba zachować kopię obecnej wersji.
- Należy otworzyć adres pliku w przeglądarce, skopiować całą zawartość i wkleić ją do zwykłego pliku tekstowego na komputerze. To kopia zapasowa.
- W drugim pliku tekstowym przygotowuje się nową wersję. Edytor powinien być prosty, na przykład Notatnik, ponieważ programy biurowe dodają własne formatowanie. Plik zapisuje się w kodowaniu UTF-8.
- Regułę blokującą usuwa się w całości albo zawęża. Jeśli katalog ma pozostać zamknięty, a tylko jedna strona ma być dostępna, nad regułą blokującą dopisuje się wyjątek w postaci wiersza
Allowz pełną ścieżką tej strony. - Gotowy plik o nazwie
robots.txttrzeba umieścić w katalogu głównym witryny, zastępując poprzedni. Służy do tego menedżer plików w panelu hostingu, program FTP albo edytor pliku w systemie zarządzania treścią. - Po zapisaniu należy ponownie otworzyć adres pliku w przeglądarce i sprawdzić, czy widać nową treść. Jeśli nadal wyświetla się stara, przyczyną bywa pamięć podręczna strony lub sieci CDN, którą trzeba wyczyścić.
- W raporcie dotyczącym pliku robots.txt w Search Console należy kliknąć ikonę „Więcej ustawień” przy pliku i wybrać „Poproś o ponowne zindeksowanie”.
Przykład wyjątku dla jednej strony w zamkniętym katalogu wygląda następująco:
User-agent: *
Allow: /dokumenty/cennik-uslug/
Disallow: /dokumenty/
Ostatni krok z listy nie jest obowiązkowy, ale skraca oczekiwanie. Roboty Google same zauważają zmiany w pliku i według dokumentacji aktualizują wersję w pamięci podręcznej co 24 godziny. Prośba o ponowne zindeksowanie przyspiesza ten proces po ważnej zmianie reguł.
Gdzie znajduje się plik robots.txt w WordPressie?
WordPress potrafi tworzyć plik robots.txt samodzielnie, bez fizycznego pliku na serwerze. Jeśli w katalogu głównym witryny nie ma pliku o tej nazwie, a adres z końcówką /robots.txt mimo to coś wyświetla, treść pochodzi z systemu albo z wtyczki. Wtedy zmian nie szuka się na serwerze, tylko w panelu.
Wtyczki do optymalizacji pod wyszukiwarki mają zwykle własny edytor tego pliku, umieszczony w narzędziach lub ustawieniach zaawansowanych wtyczki. Nazwy pozycji różnią się między wtyczkami i zmieniają się wraz z aktualizacjami, dlatego najpewniej jest wpisać „robots.txt” w wyszukiwarce ustawień danej wtyczki albo w jej dokumentacji.
Należy też zajrzeć do „Ustawienia”, a następnie „Czytanie”. Znajduje się tam pozycja „Widoczność dla wyszukiwarek” z polem „Proś wyszukiwarki o nieindeksowanie tej witryny”. Zaznaczone pole na działającej stronie firmowej to częsta pamiątka po budowie serwisu i trzeba je odznaczyć, a zmianę zapisać przyciskiem „Zapisz zmiany”.
Co zrobić po odblokowaniu?
Po zmianie pliku warto ponownie uruchomić test na żywo w narzędziu do sprawdzania adresów URL dla dwóch lub trzech adresów z listy. Gdy test potwierdzi, że Google ma dostęp do strony, można kliknąć „Poproś o zindeksowanie”. Obowiązuje dzienny limit takich próśb, dlatego wysyła się je tylko dla najważniejszych stron.
Jak trwale ukryć stronę, która nie powinna być w Google?
Dokumentacja Google wymienia trzy pewne sposoby wykluczenia adresu z wyników: regułę noindex, zabezpieczenie hasłem oraz usunięcie treści. Żaden z nich nie zadziała, jeśli robot nie będzie mógł wejść na stronę. Dlatego kolejność czynności jest tu sztywna.
- Najpierw na stronie dodaje się regułę noindex. Blokada w robots.txt na tym etapie jeszcze zostaje.
- Należy otworzyć stronę w przeglądarce, wyświetlić jej źródło i upewnić się, że reguła rzeczywiście znajduje się w kodzie.
- Dopiero teraz usuwa się z pliku robots.txt wiersz, który blokował tę stronę, i zapisuje plik na serwerze.
- W narzędziu do sprawdzania adresów URL trzeba kliknąć „Sprawdź URL wersji opublikowanej”. Pole „Czy indeksowanie jest dozwolone” powinno pokazać wartość „Nie”.
- Na koniec można kliknąć „Poproś o zindeksowanie”, aby robot odwiedził stronę szybciej i odczytał zakaz.
- Reguły w robots.txt nie przywraca się, dopóki adres nie zniknie z wyników. Przywrócona zbyt wcześnie odtworzy problem.
Odwrócenie tej kolejności, czyli zdjęcie blokady przed dodaniem noindex, otwiera okno, w którym Google może przeczytać i zindeksować pełną treść strony. Przy stronach, które miały pozostać poza wyszukiwarką, jest to ryzyko zupełnie zbędne.
Jak dodać regułę noindex?
Dla zwykłych stron HTML regułę umieszcza się w sekcji head kodu strony. Dokumentacja podaje taki zapis:
<meta name="robots" content="noindex">
W systemach zarządzania treścią nie trzeba edytować kodu ręcznie. Wtyczki do optymalizacji w WordPressie mają przy każdym wpisie i każdej stronie ustawienie widoczności w wynikach wyszukiwania, zwykle w zakładce z ustawieniami zaawansowanymi. Podobne ustawienia istnieją dla całych typów treści, na przykład dla tagów albo wyników wewnętrznej wyszukiwarki.
Dla plików, które nie są stronami HTML, takich jak dokumenty PDF czy grafiki, stosuje się nagłówek odpowiedzi serwera X-Robots-Tag: noindex. Jego ustawienie wymaga zmiany w konfiguracji serwera, więc najbezpieczniej zlecić to administratorowi hostingu.
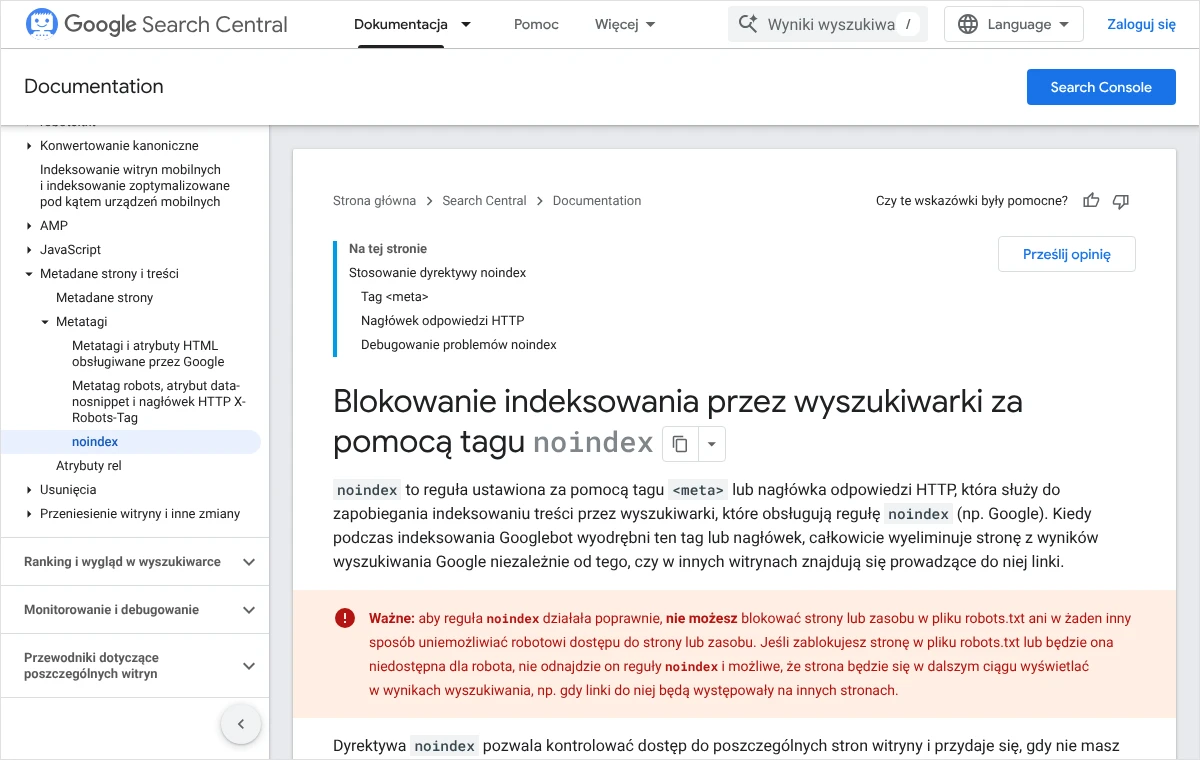
Częstym pomysłem jest dopisanie wiersza z noindex bezpośrednio do pliku robots.txt. Google nie obsługuje takiej reguły, więc zapis nie przyniesie żadnego skutku. Więcej o miejscach, w których ta reguła potrafi się ukrywać, opisuję w tekście o źródłach tagu noindex na stronie.
Kiedy lepsze jest hasło albo usunięcie strony?
Jeżeli pod adresem znajdują się dane, których nie powinna zobaczyć osoba spoza firmy, noindex nie wystarcza. Reguła ukrywa stronę w wyszukiwarce, ale każdy, kto zna adres, nadal ją otworzy. Wersje testowe, panele, cenniki dla partnerów i dokumenty wewnętrzne należy zabezpieczyć hasłem na poziomie serwera.
Jeżeli strona nie jest już nikomu potrzebna, najprostszym rozwiązaniem jest jej usunięcie. Serwer powinien wtedy odpowiadać kodem 404 lub 410. Tu również obowiązuje ta sama zasada: blokadę w robots.txt trzeba zdjąć, bo inaczej robot nie dowie się, że strony już nie ma.
Co zrobić, gdy strona musi zniknąć z wyników natychmiast?
Search Console ma narzędzie „Usunięcia”. Na karcie „Tymczasowe usunięcia” należy kliknąć „Nowa prośba”, wpisać adres i wybrać „Usuń tylko ten URL” albo „Usuń wszystkie URL-e z tym prefiksem”. Adres znika wtedy z wyników szybko, bez czekania na wizytę robota.
Trzeba jednak wiedzieć, że jest to rozwiązanie czasowe. Według dokumentacji blokada trwa około 6 miesięcy, po czym strona może wrócić do wyników. Narzędzie służy do zyskania czasu, a w tym czasie należy wdrożyć trwałe zabezpieczenie: noindex, hasło albo usunięcie strony.
Co zrobić, gdy ostrzeżenie dotyczy setek adresów z filtrami i parametrami?
W sklepach internetowych ostrzeżenie obejmuje zwykle adresy powstające automatycznie: sortowanie, filtrowanie po cenie i kolorze, kolejne strony wyników wyszukiwania w sklepie. Zablokowano je w robots.txt po to, aby robot nie tracił czasu na tysiące niemal identycznych stron, i sam ten zamiar jest rozsądny.
Problem wynika stąd, że sklep nadal linkuje do tych adresów z każdej strony kategorii. Google widzi linki, więc zapisuje adresy, choć nie może ich przeczytać. Rozwiązania są dwa i każde ma swoją cenę.
Pierwsze polega na zdjęciu blokady i oznaczeniu tych stron regułą noindex. Adresy znikną z indeksu, ale robot będzie musiał każdy z nich odwiedzić, co w bardzo dużym sklepie obciąża serwer i odciąga robota od ważniejszych stron. Drugie polega na pozostawieniu blokady i ograniczeniu liczby linków prowadzących do takich adresów.
W małych i średnich serwisach radzę wybrać pierwszą drogę, ponieważ daje czysty i przewidywalny wynik. W dużych sklepach decyzję warto poprzedzić analizą budowy nawigacji. To właśnie linki są źródłem tych adresów.
Niezależnie od wybranej drogi trzeba sprawdzić mapę witryny. Adresy zablokowane w robots.txt nie powinny się w niej znajdować. Mapa ma zawierać wyłącznie strony, które właściciel chce widzieć w Google, a umieszczenie w niej zablokowanego adresu wysyła robotowi dwa sprzeczne komunikaty.
Jak zgłosić poprawkę w Search Console i po czym poznać, że zadziałała?
Search Console nie dowie się o naprawie od razu. Stan adresów zmienia się dopiero po kolejnych wizytach robota. Można jednak poprosić o weryfikację, dzięki czemu Google potraktuje sprawdzenie tych adresów jako pilniejsze i poinformuje o wyniku.
- W raporcie „Strony” należy ponownie otworzyć wiersz „Strona zindeksowana, ale zablokowana przez plik robots.txt”.
- Na stronie szczegółów trzeba kliknąć przycisk „Sprawdź poprawkę”. Google rozpocznie ponowne sprawdzanie adresów z listy.
- Postęp widać w tym samym miejscu po kliknięciu „Sprawdź szczegóły”. Każdy adres otrzymuje jeden ze stanów: „Oczekuje”, „Powodzenie” albo „Niepowodzenie”.
- O zakończeniu weryfikacji Search Console informuje wiadomością e-mail wysyłaną do właścicieli usługi.
Według dokumentacji weryfikacja zajmuje zazwyczaj do 2 tygodni, ale w niektórych przypadkach może potrwać znacznie dłużej. Nie należy w tym czasie ponownie zmieniać pliku robots.txt ani cofać reguły noindex, bo każda zmiana w trakcie sprawdzania zaciemnia wynik.
Jak wygląda prawidłowy wynik?
Wynik zależy od wybranej drogi. Jeśli strona została odblokowana, powinna zniknąć z listy ostrzeżeń i pozostać wśród stron zindeksowanych, tym razem bez zastrzeżeń. W wynikach wyszukiwania pojawi się przy niej właściwy tytuł i opis. Najprościej potwierdzić to w narzędziu do sprawdzania adresów URL albo jedną z metod opisanych w tekście o sprawdzaniu, czy Google zaindeksował stronę.
Jeśli strona została ukryta regułą noindex, przeniesie się z listy ostrzeżeń do tabeli „Dlaczego strony nie są indeksowane”, do wiersza informującego o wykluczeniu strony za pomocą tagu noindex. W tym wypadku jest to stan pożądany, a nie nowy problem. Oznacza, że Google odczytał zakaz i go zastosował.
Co zrobić, gdy weryfikacja kończy się niepowodzeniem?
Stan „Niepowodzenie” oznacza, że Google znalazł co najmniej jeden adres, który nadal jest zablokowany. Należy otworzyć szczegóły weryfikacji, odszukać adresy z tym stanem i sprawdzić każdy z nich narzędziem do sprawdzania adresów URL. Najczęstsze przyczyny są cztery.
- Na serwerze zapisano nowy plik, ale Google nadal korzysta ze starej wersji. Rozwiązaniem jest prośba o ponowne zindeksowanie pliku w raporcie dotyczącym robots.txt i odczekanie doby.
- Adres pasuje do innej reguły niż ta, którą usunięto. W pliku bywa kilka wierszy obejmujących ten sam adres, na przykład jeden dla katalogu i drugi dla parametru.
- W pliku istnieje osobna grupa dla robota Googlebot, a poprawiono tylko grupę ogólną z gwiazdką. Google stosuje wtedy grupę przeznaczoną dla siebie.
- Witryna działa pod kilkoma adresami, na przykład z przedrostkiem „www” i bez niego, a każdy z nich ma własny plik robots.txt. Reguły obowiązują tylko dla tego hosta i protokołu, pod którym plik został opublikowany.
Po usunięciu przyczyny należy kliknąć „Rozpocznij nową weryfikację”. Wcześniej opłaca się sprawdzić wszystkie cztery przyczyny, bo każda kolejna weryfikacja wymaga cierpliwości.
Jakich błędów unikać przy usuwaniu tego ostrzeżenia?
Większość kłopotów z tym stanem nie wynika z braku wiedzy technicznej, tylko z pośpiechu. Poniższa lista zbiera pomyłki, które widuję najczęściej.
- Dodanie reguły noindex bez zdjęcia blokady w robots.txt. Robot nie odczyta zakazu, więc adres pozostanie w indeksie.
- Usunięcie całego pliku robots.txt zamiast jednego wiersza. Znikają wtedy także reguły, które były potrzebne, oraz wskazanie mapy witryny.
- Dopisywanie kolejnych zakazów w nadziei, że adres wreszcie zniknie. Każdy dodatkowy zakaz utrwala problem.
- Traktowanie narzędzia „Usunięcia” jako rozwiązania docelowego. Po upływie okresu blokady adres może wrócić do wyników.
- Ochrona poufnych treści samym plikiem robots.txt. Plik jest publiczny i nie zatrzymuje ludzi, tylko uprzejme roboty.
- Edycja pliku w programie biurowym. Cudzysłowy typograficzne i ukryte formatowanie potrafią unieważnić reguły.
Najczęstsze pytania
Czy to ostrzeżenie obniża pozycję całej witryny?
Dokumentacja nie opisuje takiego skutku i samo ostrzeżenie nie jest karą. Szkoda jest pośrednia: jeśli zablokowana strona miała zdobywać klientów, to w wynikach pojawia się bez opisu albo wcale, a Google nie zna jej treści. Jeśli ostrzeżenie dotyczy wyłącznie adresów technicznych, wpływ na resztę serwisu jest zwykle niezauważalny.
Jak długo trzeba czekać, aż ostrzeżenie zniknie z raportu?
Google aktualizuje zapamiętaną wersję pliku robots.txt co 24 godziny, ale poszczególne strony odwiedza we własnym tempie. Weryfikacja poprawki zajmuje zazwyczaj do 2 tygodni, a przy rzadko odwiedzanych adresach dłużej. Proces można przyspieszyć prośbą o zindeksowanie najważniejszych stron, ale nie da się go wymusić.
Czy można po prostu zignorować to ostrzeżenie?
Można, pod warunkiem że decyzja jest świadoma. Jeśli wszystkie adresy z listy są techniczne, nie zawierają poufnych danych i nikt ich nie wyszukuje, pozostawienie stanu bez zmian nie zaszkodzi. Listę trzeba jednak przejrzeć w całości, ponieważ wśród adresów technicznych często ukrywa się kilka ważnych podstron zablokowanych przez zbyt szeroką regułę.
Dlaczego strona wyświetla się w Google bez opisu?
Opis w wynikach powstaje na podstawie treści strony, a Google tej treści nie mógł przeczytać z powodu blokady. Wyszukiwarka zna tylko adres i teksty linków, które do niego prowadzą. Po zdjęciu blokady i kolejnej wizycie robota wynik otrzyma zwykły tytuł i opis.
Czy do ukrycia strony wystarczy tag kanoniczny albo przekierowanie?
Oba rozwiązania mają ten sam warunek co noindex: robot musi wejść na stronę, żeby je odczytać. Dopóki adres jest zablokowany w robots.txt, Google nie zobaczy ani tagu kanonicznego, ani przekierowania. Najpierw trzeba więc zdjąć blokadę, a dopiero potem liczyć na działanie tych sygnałów.
Czy plik robots.txt trzeba mieć, skoro sprawia tyle kłopotów?
Brak pliku nie jest błędem. Dokumentacja raportu dotyczącego robots.txt traktuje odpowiedź 404 dla tego adresu jako sytuację prawidłową, a Google skanuje wtedy witrynę bez ograniczeń. W małej stronie firmowej plik może ograniczać się do wskazania mapy witryny. Rozbudowane reguły mają sens dopiero w dużych serwisach.
Co zrobić, gdy nie ma dostępu do pliku robots.txt?
W gotowych kreatorach stron i części platform sklepowych bezpośrednia edycja pliku bywa niemożliwa. Indeksowaniem steruje się tam w ustawieniach platformy, zwykle w części poświęconej wyszukiwarkom. Jeśli takie ustawienia nie pozwalają zdjąć blokady, pozostaje kontakt z pomocą techniczną dostawcy i przekazanie jej dokładnego adresu oraz nazwy ostrzeżenia z Search Console.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zupełnie zrozumiałe. Ostrzeżenie brzmi technicznie, a decyzja, co odblokować, a co ukryć, wymaga spokojnego przejrzenia całej listy adresów. Chętnie zrobię to od początku do końca: pobiorę listę z Search Console, ustalę, które reguły blokują poszczególne strony, przygotuję poprawiony plik robots.txt, dodam zakaz indeksowania tam, gdzie jest potrzebny, zgłoszę poprawkę i będę pilnować wyniku weryfikacji. Na koniec przekażę krótką notatkę o tym, co zostało zmienione i dlaczego.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Odpowiem, od czego należy zacząć i ile czasu zajmie uporządkowanie sprawy.