W raporcie Google Search Console część adresów trafia do grupy niezindeksowanych z opisem „Duplikat, użytkownik nie oznaczył strony kanonicznej”. Komunikat brzmi groźnie, a liczba przy nim potrafi rosnąć z tygodnia na tydzień. Właściciel strony widzi kilkaset adresów, których nie rozpoznaje, i nie wie, czy jego serwis właśnie traci widoczność, czy nic się nie dzieje.
Ta instrukcja jest dla osób, które prowadzą firmową stronę albo sklep i same zaglądają do Search Console. Wyjaśniam w niej, co ten stan znaczy według dokumentacji Google, kiedy wolno go zostawić w spokoju, a kiedy jest sygnałem bałaganu w adresach, który warto uporządkować.
Po lekturze czytelnik będzie umiał znaleźć listę adresów z tym stanem, ustalić, którą stronę Google uznał za właściwą, dobrać sposób naprawy do przyczyny, zgłosić poprawkę do weryfikacji i ocenić, czy zadziałała. Będzie też wiedział, których popularnych sposobów lepiej nie stosować, bo pogarszają sytuację.
Co oznacza stan „Duplikat, użytkownik nie oznaczył strony kanonicznej”?
Ta sama treść bardzo często jest dostępna pod kilkoma adresami. Wystarczy, że strona otwiera się z przedrostkiem www i bez niego, z ukośnikiem na końcu i bez niego albo z dopisanym parametrem sortowania. Dla człowieka to jedna strona. Dla robota są to osobne adresy, które trzeba pobrać i porównać.
Google grupuje strony o takiej samej lub bardzo podobnej treści głównej i z każdej grupy wybiera jeden adres, który ją reprezentuje. Ten adres nazywa się stroną kanoniczną. To on trafia do indeksu i to on jest zwykle pokazywany w wynikach. Pozostałe adresy z grupy są traktowane jako duplikaty i odwiedzane rzadziej.
Pomoc Search Console opisuje omawiany stan dwoma zdaniami. Strona jest duplikatem innej strony, ale nie wskazuje preferowanej strony kanonicznej. Robot Google wybrał inną stronę jako kanoniczną, więc ta strona nie będzie wyświetlana w wyszukiwarce.
W komunikacie mieszczą się więc dwie informacje. Pierwsza: Google uznał, że pod danym adresem jest treść, którą zna już z innego adresu. Druga: właściciel serwisu nie podpowiedział, który adres jest tym właściwym, więc wyszukiwarka zdecydowała sama.
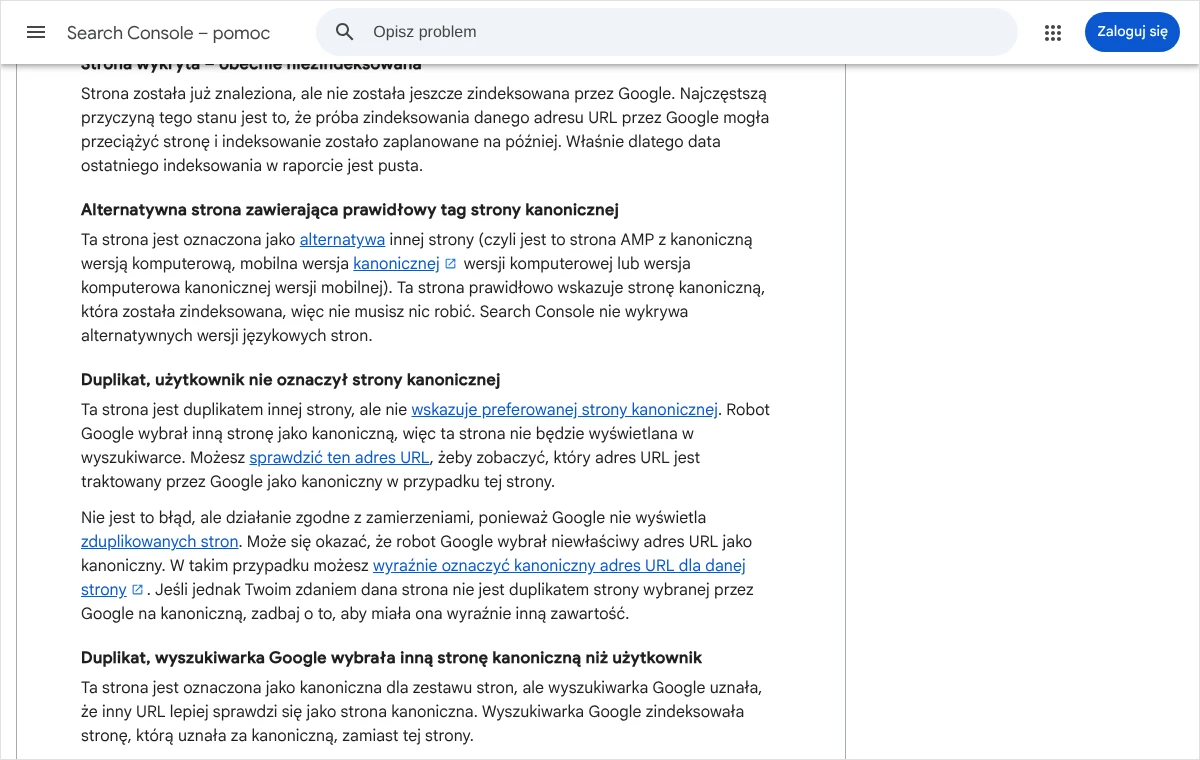
W tym samym raporcie występują dwa podobne stany i łatwo je pomylić. „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” oznacza, że strona poprawnie wskazuje adres kanoniczny, a ten został zindeksowany. Tu nie trzeba nic robić. „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” oznacza, że wskazówka była, ale Google się z nią nie zgodził. To inny problem i wymaga innego podejścia niż opisane w tym tekście.
Czy ten stan szkodzi stronie i kiedy trzeba się nim zająć?
Pomoc Search Console mówi wprost, że nie jest to błąd, tylko działanie zgodne z zamierzeniami, ponieważ Google nie wyświetla zduplikowanych stron. Dokumentacja dla twórców witryn dodaje, że powielanie treści w obrębie serwisu jest zjawiskiem zwyczajnym i nie narusza zasad dotyczących spamu. Za sam ten stan nie grozi więc żadna kara.
Wskazywanie strony kanonicznej nie jest też obowiązkowe. Google zachęca do tego, ale zaznacza, że witryna prawdopodobnie będzie działać dobrze także bez takich oznaczeń, bo wyszukiwarka sama ustali najlepszą wersję adresu.
Nie znaczy to, że sprawę zawsze wolno pominąć. Z mojej praktyki wynikają cztery sytuacje, w których trzeba zareagować:
- na liście znajduje się adres, który powinien być widoczny w wynikach, na przykład strona usługi, kategoria sklepu albo ważny wpis,
- Google wybrał jako kanoniczny adres gorszy od zamierzonego, na przykład z parametrem, bez szyfrowania albo w wersji testowej,
- za duplikaty zostały uznane strony, które w zamyśle są różne, na przykład podstrony usług dla kilku miast,
- liczba adresów z tym stanem szybko rośnie, co zwykle oznacza, że serwis sam wytwarza nowe warianty adresów.
Jeśli na liście są wyłącznie warianty techniczne, a w indeksie znajdują się właściwe adresy, stan jest informacją, a nie usterką. Porządek w adresach nadal się opłaca: robot nie traci czasu na kopie, a statystyki w Search Console zbierają się pod jednym adresem zamiast pod kilkoma.
Gdzie znaleźć listę adresów z tym stanem w Search Console?
Lista znajduje się w raporcie „Indeksowanie stron”. Do jej otwarcia potrzebny jest dostęp do usługi w Search Console dla danej witryny. Kolejność czynności jest następująca:
- Po zalogowaniu do Search Console należy wskazać właściwą usługę, czyli witrynę, której dotyczy sprawa.
- W menu po lewej stronie, w części „Indeksowanie”, trzeba otworzyć pozycję „Strony”. Wyświetli się raport „Indeksowanie stron”.
- Pod wykresem znajduje się tabela „Dlaczego strony nie są indeksowane”. Należy odszukać w niej wiersz „Duplikat, użytkownik nie oznaczył strony kanonicznej” i go kliknąć.
- Otworzy się strona szczegółów z wykresem liczby adresów w czasie i z tabelą przykładowych adresów. Tabelę da się pobrać do pliku przyciskiem eksportu w prawym górnym rogu.
- U góry raportu działa filtr mapy witryny. Ustawienie „Wszystkie przesłane strony” pokazuje tylko adresy zgłoszone w mapie, a „Tylko strony nieprzesłane” pozostałe.
Filtr z ostatniego punktu jest bardzo przydatny. Jeśli adres z mapy witryny ma stan duplikatu, to znaczy, że serwis sam zgłasza Google stronę, której Google nie uważa za właściwą wersję. Takie adresy należy sprawdzić w pierwszej kolejności.
Trzeba też znać ograniczenie tej tabeli. Według pomocy Google lista przykładów nie musi zawierać wszystkich adresów z danym stanem i jest ograniczona do 1000 wierszy. W dużym serwisie tabela pokazuje więc próbkę. Dlatego naprawia się przyczynę, czyli cały typ adresów, a nie pojedyncze pozycje z listy.
Skąd biorą się duplikaty na zwykłej stronie firmowej?
Zanim zacznie się naprawę, trzeba rozpoznać, jakiego rodzaju adresy trafiły na listę. Po pobraniu tabeli najwygodniej posortować ją alfabetycznie. Adresy tego samego typu ułożą się obok siebie i wzór zwykle widać od razu. W praktyce powtarza się kilka źródeł:
- warianty protokołu i domeny: ten sam adres z http i z https, z www i bez www,
- drobne różnice w zapisie: ukośnik na końcu lub jego brak, wielkie i małe litery, dopisek index.php albo index.html,
- parametry w adresie: sortowanie, filtrowanie i stronicowanie w sklepie, znaczniki kampanii reklamowych, identyfikatory sesji, wyniki wewnętrznej wyszukiwarki,
- wersje do druku, wersje mobilne pod osobnym adresem i strony AMP,
- ten sam produkt lub wpis dostępny w kilku kategoriach pod różnymi ścieżkami,
- kopia serwisu dostępna dla robotów, na przykład wersja testowa albo stara domena, która nadal działa,
- strony o prawie identycznej treści, w których różni się tylko nazwa miasta, koloru lub rozmiaru.
Dokumentacja Google wymienia podobne powody: warianty regionalne, warianty urządzeń, warianty protokołu, funkcje witryny takie jak sortowanie i filtrowanie oraz przypadkowo dostępne kopie, w tym wersję demonstracyjną serwisu.
Ostatnia pozycja z mojej listy jest inna niż pozostałe. W sześciu pierwszych przypadkach treść naprawdę jest ta sama i wystarczy wskazać właściwy adres. W siódmym właściciel uważa strony za różne, a Google za takie same. Tam samo oznaczenie adresu niczego nie załatwi i potrzebna jest praca nad treścią. Opisuję ją w osobnej sekcji.
Jak sprawdzić, którą stronę Google uznał za kanoniczną?
Raport mówi tylko tyle, że adres jest duplikatem. Nie mówi, czego duplikatem. Tę informację podaje narzędzie do sprawdzania adresów URL, wbudowane w Search Console. Sprawdzenie jednego adresu wygląda tak:
- W tabeli przykładów należy najechać kursorem na wybrany adres i kliknąć przycisk sprawdzania adresu, który pojawia się obok niego. Drugi sposób to wklejenie pełnego adresu w pasku wyszukiwania u góry dowolnego ekranu Search Console.
- Po chwili wyświetli się wynik sprawdzenia. Trzeba rozwinąć w nim sekcję „Indeksowanie stron”.
- W polu „Adres kanoniczny określony przez użytkownika” widać, czy strona wskazuje jakiś adres. Przy omawianym stanie pole informuje o braku takiej wskazówki.
- W polu „Adres kanoniczny wybrany przez Google” widać adres, który wyszukiwarka uznała za właściwy. Należy go zanotować.
- Wybrany przez Google adres trzeba otworzyć w przeglądarce i porównać z adresem sprawdzanym: czy treść jest ta sama, czy tylko podobna.
- Czynności warto powtórzyć dla kilku adresów z każdego typu rozpoznanego wcześniej, a wyniki zapisywać w dwóch kolumnach: adres z listy i adres wybrany przez Google.
Wynik w narzędziu pokazuje stan z ostatniej wizyty robota, a nie stan bieżący. Jeśli na stronie wprowadzono już zmiany, przycisk „Sprawdź URL wersji opublikowanej” pobiera stronę na nowo i pokazuje, co robot zobaczyłby w tej chwili. Test wersji opublikowanej pozwala ocenić, czy wskazówka o adresie kanonicznym jest widoczna, ale nie przesądza, jaką decyzję Google ostatecznie podejmie.
Po kilku sprawdzeniach powstaje jasny obraz. Albo Google wybiera dokładnie te adresy, które właściciel sam by wskazał, albo wybiera inne, albo łączy w pary strony, które miały być osobne. Od tego zależy dalsze postępowanie. Osobom, które chcą najpierw upewnić się, czy konkretna podstrona w ogóle jest w indeksie, przyda się tekst jak sprawdzić, czy Google zaindeksował stronę.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl, a ja przejmę sprawę: przejrzę listę adresów z raportu, ustalę, skąd biorą się duplikaty, i wprowadzę oznaczenia stron kanonicznych tam, gdzie są potrzebne.
Jak zdecydować, co zrobić z daną grupą adresów?
Dla każdego typu adresów z listy trzeba odpowiedzieć na dwa pytania. Czy duplikat jest komukolwiek potrzebny? Czy Google wybrał ten adres, który powinien być widoczny? Odpowiedzi prowadzą do jednego z czterech rozwiązań.
Jeśli duplikat nie jest nikomu potrzebny, najlepszym wyjściem jest przekierowanie go na adres właściwy. Dotyczy to wariantów z http, z www lub bez www, adresów z dopiskiem index.php, starej domeny i podobnych przypadków. Odwiedzający i robot trafiają wtedy zawsze w jedno miejsce.
Jeśli duplikat musi dalej działać, bo korzystają z niego ludzie, zostaje on na miejscu, ale otrzymuje oznaczenie strony kanonicznej. Tak postępuje się z adresami z sortowaniem i filtrami, z wersją do druku oraz z adresami, do których dopisywane są znaczniki kampanii.
Jeśli Google wybrał dobrze i jedyną niedogodnością jest pozycja w raporcie, wolno nie robić nic. Dodanie oznaczenia jest wtedy porządkowaniem na przyszłość, a nie naprawą. Jeśli natomiast strony w ogóle nie powinny być duplikatami, oznaczenia nie stosuje się wcale, tylko zmienia treść.
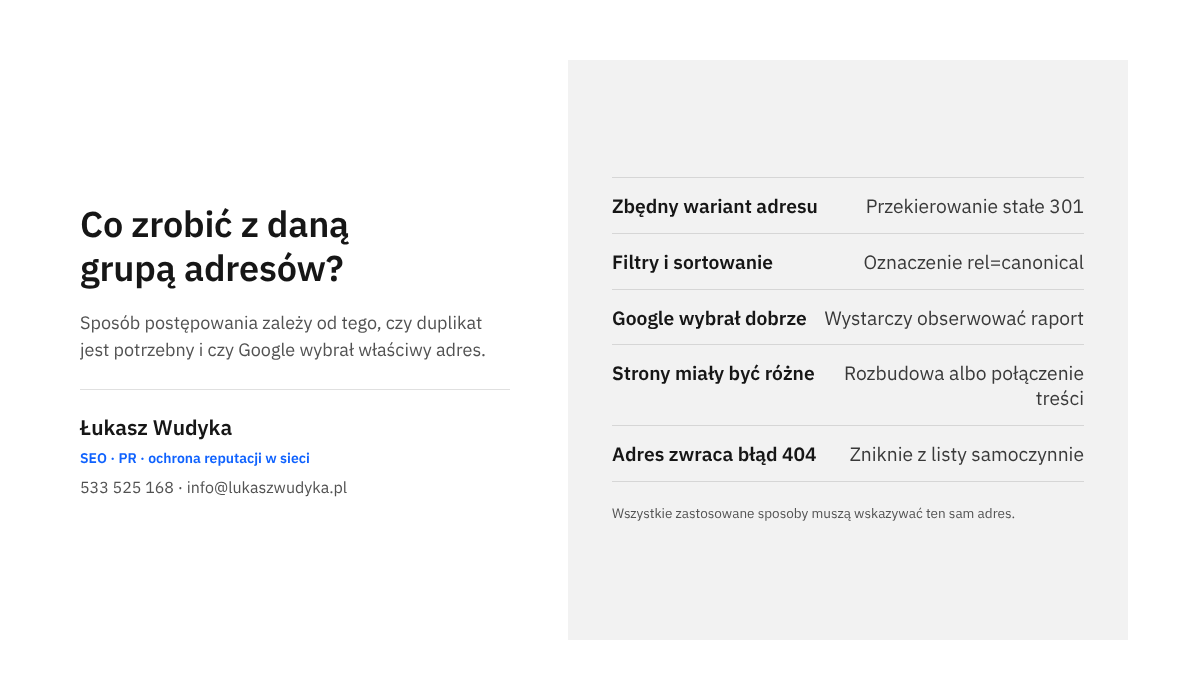
Zdarza się jeszcze piąty przypadek: adres z listy od dawna nie istnieje i zwraca błąd 404. Wtedy raport pokazuje po prostu stan z ostatniej wizyty robota. Taki adres sam zniknie z listy po kolejnym pobraniu i nie wymaga żadnej czynności, o ile nie prowadzą do niego linki z własnego serwisu.
Jak wskazać Google właściwy adres?
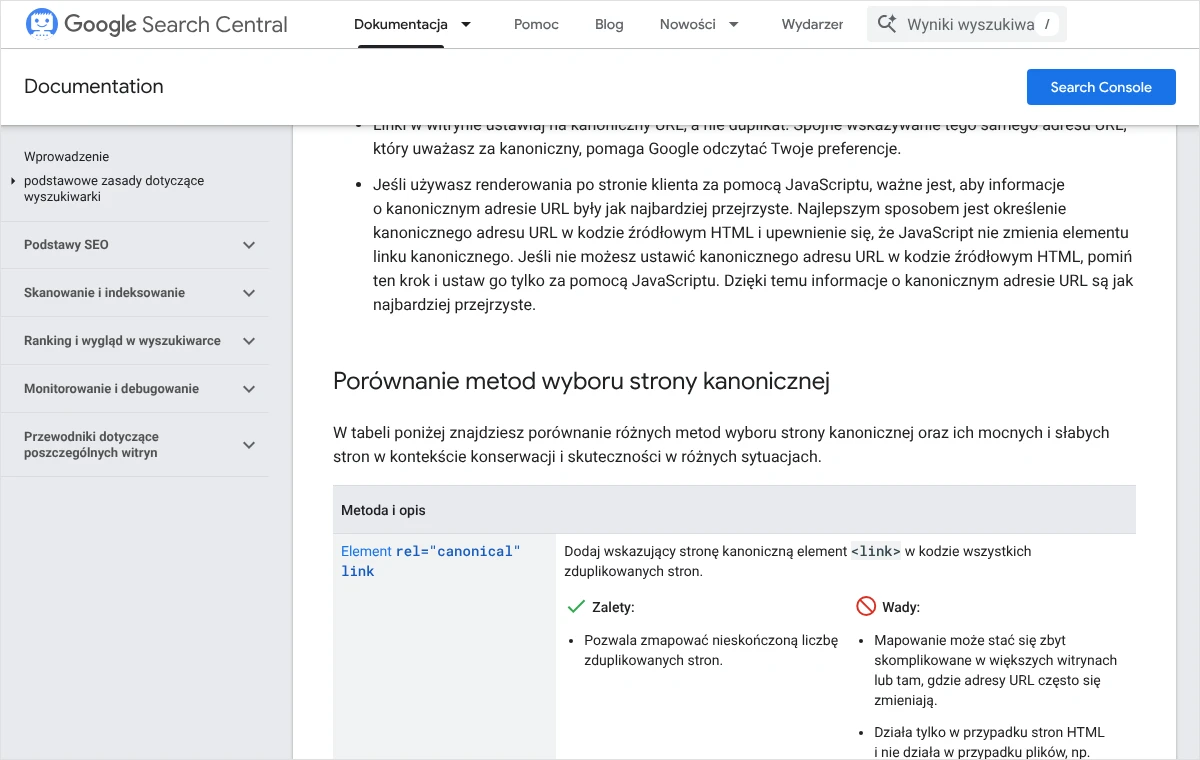
Dokumentacja Google wymienia kilka sposobów i porządkuje je według siły. Najmocniej działają przekierowania. Mocnym sygnałem jest też oznaczenie rel="canonical" w kodzie strony lub w nagłówku odpowiedzi serwera. Mapa witryny jest sygnałem słabym. Sposoby się sumują, więc wolno je łączyć, pod warunkiem że wszystkie wskazują ten sam adres.
Oznaczenie w kodzie strony
Najczęściej stosowany sposób to jeden wiersz umieszczony w sekcji <head> strony będącej duplikatem. Wiersz zawiera pełny adres strony, która ma być uznana za właściwą:
<link rel="canonical" href="https://www.example.com/oferta/naprawa-dachow/" />
Adres example.com należy oczywiście zastąpić własnym. Google zaleca podawanie adresów bezwzględnych, czyli pełnych, razem z protokołem i domeną, a nie samej ścieżki. Element działa tylko wtedy, gdy znajduje się w sekcji nagłówkowej i występuje na stronie raz.
Dobrą praktyką jest też umieszczenie takiego samego wiersza na stronie właściwej, ze wskazaniem na nią samą. Dzięki temu każdy wariant jej adresu, także z dopisanym parametrem, niesie tę samą wskazówkę. Jest to zalecenie zapisane w dokumentacji, a jednocześnie najprostszy sposób, by problem nie wracał.
Ustawienie w WordPressie i w sklepie
W serwisach opartych na systemie zarządzania treścią nie wpisuje się tego wiersza ręcznie w szablonie. WordPress sam dodaje oznaczenie do pojedynczych wpisów i stron, a wtyczki do optymalizacji pod wyszukiwarki rozszerzają je na kategorie, tagi i archiwa oraz udostępniają pole, w którym adres kanoniczny da się zmienić dla wybranej podstrony.
Nazwa i położenie tego pola zależą od wtyczki, zwykle znajduje się ono w zaawansowanej części ustawień pod treścią wpisu. Puste pole oznacza, że wtyczka sama wstawi adres danej strony, i w większości przypadków jest to ustawienie prawidłowe. Wpisywać cokolwiek trzeba tylko tam, gdzie strona ma wskazywać inny adres niż własny.
Ważne jest co innego: w serwisie powinno działać jedno narzędzie, które wstawia oznaczenie. Dwie wtyczki albo wtyczka i szablon jednocześnie potrafią dodać dwa różne wiersze, a sprzeczne wskazówki są gorsze niż brak wskazówki. Po każdej zmianie należy otworzyć źródło strony w przeglądarce i wyszukać w nim słowo canonical. Powinno wystąpić jeden raz.
Przekierowanie zamiast oznaczenia
Przekierowanie stosuje się wtedy, gdy duplikat ma zostać wycofany. Google podkreśla, że to najsilniejszy sygnał i że najszybciej działają przekierowania ustawione po stronie serwera. W praktyce chodzi o przekierowanie stałe, o kodzie 301, z każdego zbędnego wariantu na adres właściwy.
Typowe zastosowania to wymuszenie https, ujednolicenie wersji z www i bez www oraz ujednolicenie ukośnika na końcu adresu. W wielu serwisach wystarczy jedna reguła na serwerze, żeby z listy zniknęła duża grupa adresów. Sposób zapisu takich reguł i błędy, które potrafią wyłączyć stronę, opisałem w tekście przekierowanie 301 w pliku .htaccess.
Zmiany w plikach serwera są ryzykowne. Jeden błędny znak potrafi sprawić, że cały serwis przestaje się otwierać. Przed edycją należy zachować kopię pliku w poprzednim brzmieniu, a po zapisaniu od razu sprawdzić kilka adresów. Bezpieczniejszą drogą jest ustawienie przekierowań w panelu hostingu lub we wtyczce, jeśli dają taką możliwość.
Mapa witryny i linki wewnętrzne
Mapa witryny powinna zawierać wyłącznie adresy właściwe, bez wariantów. Jest to słaby sygnał, ale Google bierze go pod uwagę, a mapa z duplikatami wysyła komunikat sprzeczny z resztą ustawień. Po zmianach trzeba więc pobrać mapę i sprawdzić, czy nie ma w niej adresów z listy. Sam sposób przesyłania mapy opisuje tekst zgłoszenie mapy witryny w Google Search Console.
To samo dotyczy linków w serwisie. Dokumentacja zaleca, by linki wewnętrzne prowadziły do adresu kanonicznego, a nie do duplikatu. Jeśli menu, stopka albo treści kierują do wersji bez ukośnika, a właściwa jest wersja z ukośnikiem, serwis sam podsuwa robotowi zbędne adresy. Zasady porządkowania odnośników zebrałem w tekście linkowanie wewnętrzne w serwisie.
Pliki inne niż strony
Elementu w kodzie nie da się umieścić w pliku PDF ani w innym dokumencie. Dla takich plików Google przewiduje nagłówek odpowiedzi serwera o nazwie Link z tym samym oznaczeniem. Jego ustawienie wymaga dostępu do konfiguracji serwera, więc w małej firmie jest to zadanie dla administratora lub firmy hostingowej. Przykład z dokumentacji wygląda tak:
Link: <https://www.example.com/downloads/white-paper.pdf>; rel="canonical"
Co zrobić, gdy strony nie są duplikatami, a Google tak je potraktował?
Pomoc Search Console podaje na tę okoliczność jedno zalecenie: jeśli strona nie jest duplikatem adresu wybranego przez Google, trzeba zadbać o to, aby miała wyraźnie inną zawartość. Oznaczenie kanoniczne w niczym tu nie pomoże, bo spór nie dotyczy adresu, tylko treści.
Najczęściej dotyczy to podstron tworzonych z jednego wzoru: oferty dla kolejnych miast, opisów produktów różniących się jednym parametrem, kategorii z tym samym tekstem wstępnym. Jeśli po zamianie jednego słowa dwie strony są nie do odróżnienia, wyszukiwarka ma prawo uznać je za jedną.
Rozwiązania są dwa. Pierwsze to rozbudowa: każda strona dostaje własny, konkretny tekst, własny tytuł i opis, własne przykłady, pytania i dane, których nie ma na pozostałych. Drugie to połączenie: zamiast pięciu słabych kopii powstaje jedna pełna strona, a pozostałe adresy są na nią przekierowane.
Uważam, że uczciwa ocena jest tu ważniejsza niż ambicja. Jeśli firma nie ma nic odrębnego do napisania o danym wariancie, lepsza jest jedna dobra strona niż kilka podobnych. Podobne zjawisko, w którym kilka podstron zabiega o tę samą frazę, wymaga zresztą tych samych decyzji.
Jak zgłosić poprawkę i po czym poznać, że zadziałała?
Po wprowadzeniu zmian Google musi ponownie pobrać adresy, żeby je zauważyć. Dzieje się to samoczynnie, ale w raporcie da się uruchomić weryfikację, która przyspiesza ponowne sprawdzenie i informuje o wyniku. Kolejność jest następująca:
- Kontrola własna: należy otworzyć kilka poprawionych adresów i upewnić się, że przekierowanie działa albo że w źródle strony jest jeden wiersz z adresem kanonicznym.
- Kontrola w Search Console: dla dwóch lub trzech adresów trzeba użyć przycisku „Sprawdź URL wersji opublikowanej” i zobaczyć, czy narzędzie odczytuje wskazany adres kanoniczny.
- Powrót do raportu „Indeksowanie stron” i otwarcie wiersza „Duplikat, użytkownik nie oznaczył strony kanonicznej”.
- Na stronie szczegółów należy kliknąć „Sprawdź poprawkę”. Od tej chwili Google zaczyna ponownie sprawdzać adresy z listy.
- Postęp widać po kliknięciu „Sprawdź szczegóły”. Poszczególne adresy mają tam stany „Oczekuje”, „Powodzenie” albo „Niepowodzenie”.
Według pomocy Google weryfikacja zajmuje zazwyczaj do 2 tygodni, a w niektórych przypadkach znacznie dłużej. W jej trakcie nie należy klikać przycisku ponownie. Jeśli weryfikacja zakończy się niepowodzeniem, po usunięciu przyczyny uruchamia się ją od nowa przyciskiem „Rozpocznij nową weryfikację”.
Poprawny wynik nie zawsze oznacza, że adres znika z grupy niezindeksowanych. Duplikat, który dostał oznaczenie kanoniczne, przechodzi zwykle do stanu „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”. Duplikat przekierowany trafia do stanu opisującego stronę z przekierowaniem. Oba wyniki są prawidłowe. Celem nie jest indeksowanie duplikatów, tylko to, by w indeksie znalazł się adres właściwy.
Najpewniejszym sprawdzianem jest więc ponowne użycie narzędzia do sprawdzania adresów na stronie właściwej. Jeśli pole „Adres kanoniczny wybrany przez Google” pokazuje zamierzony adres, a strona ma status zindeksowanej, naprawa się powiodła. Wykres w raporcie będzie opadał stopniowo, bo robot wraca do duplikatów rzadko.
Co zrobić, gdy stan się nie zmienia?
Jeśli po kilku tygodniach nic się nie zmieniło, przyczyną jest zwykle sprzeczność sygnałów. Należy wtedy sprawdzić po kolei: czy oznaczenie znajduje się w źródle strony, a nie jest dopisywane później przez skrypt, czy występuje raz, czy wskazany adres otwiera się poprawnie i nie przekierowuje dalej, czy mapa witryny i linki wewnętrzne prowadzą do tego samego adresu.
Trzeba też sprawdzić, czy robot ma dostęp do duplikatu. Strona zablokowana w pliku robots.txt nie zostanie pobrana, więc Google nie odczyta z niej żadnego oznaczenia. Jeśli wszystkie sygnały są spójne, a Google nadal wybiera inny adres, pozostaje ocenić treść: być może strona wskazana jako właściwa jest uboższa od tej, którą wybrała wyszukiwarka.
Jakich błędów unikać przy porządkowaniu duplikatów?
Większość kłopotów, które widzę przy tym stanie, nie wynika z samych duplikatów, tylko z prób ich usunięcia nieodpowiednim narzędziem. Dokumentacja Google wymienia kilka rzeczy, których robić nie należy, a praktyka dopisuje kolejne:
- blokowanie duplikatów w pliku robots.txt – robot nie zobaczy wtedy oznaczenia ani przekierowania, a adres i tak może pozostać znany wyszukiwarce,
- stosowanie znacznika noindex do wyboru strony kanonicznej – Google odradza to rozwiązanie i zaleca w tym miejscu oznaczenie kanoniczne,
- korzystanie z narzędzia do usuwania adresów w Search Console – ukrywa ono w wynikach wszystkie wersje adresu, także tę właściwą,
- wskazywanie różnych adresów różnymi metodami, na przykład jednego w mapie witryny, a innego w kodzie strony,
- wskazywanie adresu z fragmentem po znaku #, którego Google zasadniczo nie obsługuje,
- ustawienie na wszystkich podstronach oznaczenia prowadzącego do strony głównej – to częsty skutek błędnej konfiguracji szablonu i prosta droga do utraty widoczności podstron,
- wskazywanie adresu, który nie działa, przekierowuje dalej albo sam jest zablokowany przed indeksowaniem.
Osobną uwagę kieruję do właścicieli sklepów. Usuwanie stron z filtrami i sortowaniem tylko po to, żeby raport wyglądał czyściej, szkodzi klientom, a wyszukiwarce niczego nie ułatwia. Te strony mają działać, tylko powinny wskazywać właściwy adres kategorii.
Nie należy też oczekiwać, że liczba w raporcie spadnie do zera. W żywym serwisie zawsze istnieją jakieś warianty adresów i jest to stan normalny. Miarą powodzenia jest to, czy właściwe strony są w indeksie, a nie to, czy lista duplikatów jest pusta.
Najczęstsze pytania
Czy za duplikaty grozi kara od Google?
Nie. Dokumentacja Google stwierdza, że powielona treść w obrębie witryny nie narusza zasad dotyczących spamu, a sam stan w raporcie jest opisany jako działanie zgodne z zamierzeniami. Skutki są praktyczne, a nie karne: w wynikach może pojawić się inny adres niż zamierzony, a statystyki rozkładają się na kilka wersji tej samej strony.
Czy każdy adres z tej listy trzeba naprawiać?
Nie ma takiej potrzeby. Jeśli Google wybrał jako kanoniczny adres, który i tak miał być widoczny, pozycja w raporcie jest tylko informacją. Naprawy wymagają te grupy adresów, przy których wybór wyszukiwarki jest inny niż zamierzony, oraz te, które serwis wytwarza w dużej liczbie.
Czym ten stan różni się od stanu „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”?
W omawianym stanie strona nie zawiera żadnej wskazówki i Google decyduje samodzielnie. W drugim wskazówka istnieje, ale wyszukiwarka uznała, że inny adres lepiej reprezentuje treść. W pierwszym przypadku zwykle wystarcza dodanie oznaczenia, w drugim trzeba szukać sprzecznych sygnałów albo różnic w jakości treści.
Czy oznaczenie kanoniczne gwarantuje, że Google wybierze wskazany adres?
Nie gwarantuje. Google traktuje je jako mocną wskazówkę, a nie jako polecenie, i bierze pod uwagę także przekierowania, protokół, mapę witryny i linki. Im bardziej spójne są wszystkie te sygnały, tym większa szansa, że wybór wyszukiwarki pokryje się z zamiarem właściciela.
Ile trwa znikanie adresów z raportu po naprawie?
Weryfikacja poprawki trwa według pomocy Google zazwyczaj do 2 tygodni, czasem znacznie dłużej. Sam wykres opada wolniej, ponieważ robot odwiedza duplikaty rzadko. Pomoc podaje ponadto, że problem pozostaje w tabeli jeszcze do 90 dni po zniknięciu jego ostatniego wystąpienia, więc pusty wiersz przez pewien czas nadal będzie widoczny.
Czy wystarczy poprosić o zindeksowanie duplikatu?
To nie pomoże. Przycisk „Poproś o zindeksowanie” zgłasza adres do ponownego pobrania, ale nie zmienia oceny, że treść jest kopią innej strony. Prośba ma sens dopiero po wprowadzeniu zmian i najlepiej kierować ją do adresu właściwego. Trzeba też wiedzieć, że liczba takich próśb w ciągu doby jest ograniczona.
Co zrobić, gdy na liście są adresy, których w serwisie nie ma?
Najpierw należy otworzyć taki adres w przeglądarce. Jeśli wyświetla zwykłą treść strony, serwis odpowiada poprawnie na dowolny dopisek w adresie i tu przyda się oznaczenie kanoniczne wskazujące na samą siebie. Jeśli zwraca błąd 404, adres sam zniknie z listy. W obu przypadkach warto ustalić, skąd robot go zna, bo często prowadzi do niego błędny link w szablonie.
Czy wersje językowe strony są traktowane jako duplikaty?
Według dokumentacji Google różne wersje językowe są uznawane za duplikaty tylko wtedy, gdy ich treść główna jest w tym samym języku, na przykład gdy przetłumaczono samo menu i stopkę. Strony w pełni przetłumaczone są osobnymi stronami. Do ich powiązania służy oznaczenie hreflang, a nie oznaczenie kanoniczne.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Rozumiem to dobrze. Lista kilkuset adresów w raporcie nie jest czymś, nad czym właściciel firmy chce spędzać wieczory, zwłaszcza gdy każda zmiana na serwerze budzi obawę, że strona przestanie działać. Chętnie zajmę się tym od początku do końca: przejrzę raport, podzielę adresy na grupy, sprawdzę, co Google uznał za właściwe wersje, ustawię oznaczenia kanoniczne i przekierowania, uporządkuję mapę witryny oraz linki, a potem zgłoszę poprawkę i dopilnuję jej wyniku.
Na koniec przekażę krótki, zrozumiały opis tego, co zostało zmienione i dlaczego. Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl.