Właściciel strony chce ukryć podstronę przed Google, więc dla pewności stosuje dwa zabezpieczenia naraz: dopisuje znacznik noindex i dodatkowo blokuje adres w pliku robots.txt. Logika wydaje się rozsądna, bo dwie blokady powinny działać mocniej niż jedna. W praktyce jest odwrotnie: druga blokada wyłącza pierwszą, a adres potrafi miesiącami pozostawać w wynikach wyszukiwania.
Ten tekst jest instrukcją dla osób, które prowadzą firmową stronę albo sklep i widzą w Google adresy, których tam być nie powinno: koszyk, panel logowania, wyniki wewnętrznej wyszukiwarki, wersję testową czy stare pliki. Przyda się również wtedy, gdy Google Search Console pokazuje ostrzeżenie o stronach zindeksowanych mimo blokady.
Po lekturze będzie wiadomo, dlaczego ten zestaw nie działa, jak ustalić, która z blokad faktycznie obowiązuje na danym adresie, w jakiej kolejności je uporządkować i po czym poznać, że Google przyjęło zmianę. Opisuję wyłącznie to, co wynika z dokumentacji Google, bez obchodzenia zasad.
Po czym rozpoznać, że podstrona ma dwie blokady naraz?
Pierwszy sygnał widać w samych wynikach wyszukiwania. Adres, który miał zniknąć, nadal się pojawia, ale wygląda inaczej niż pozostałe: zamiast zwykłego opisu ma komunikat o braku informacji o stronie albo sam adres bez sensownego tytułu. Dokumentacja Google mówi wprost, że adres zablokowany w pliku robots.txt nadal może pojawiać się w wynikach, tyle że bez opisu.
Drugi sygnał znajduje się w Google Search Console. W raporcie „Indeksowanie stron” pojawia się ostrzeżenie „Strona zindeksowana, ale zablokowana przez plik robots.txt”. Oznacza ono dokładnie to, co mówi nazwa: Google nie pobrało treści podstrony, ale i tak umieściło jej adres w indeksie, zwykle dlatego, że prowadzą do niego linki.
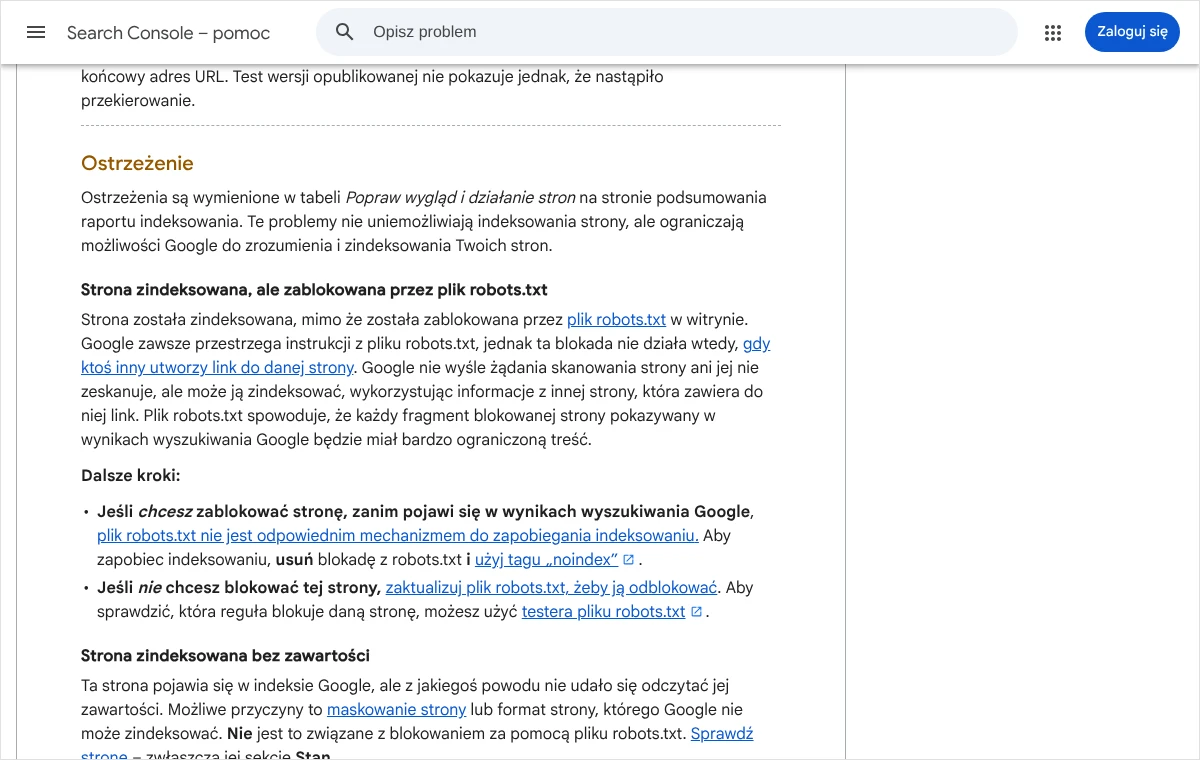
Trzeci sygnał to niezgodność między tym, co ustawiono w serwisie, a tym, co pokazuje Google. W kodzie podstrony znacznik noindex jest od dawna, wtyczka do SEO potwierdza, że adres jest wyłączony z wyników, a mimo to nic się nie zmienia. Jeżeli w tym samym czasie adres jest objęty regułą Disallow w pliku robots.txt, przyczyna jest niemal pewna.
Jest też wariant mniej widoczny. W raporcie „Indeksowanie stron”, w tabeli „Dlaczego strony nie są indeksowane”, adres figuruje jako „URL zablokowany przez plik robots.txt”. Na razie nie ma go w wynikach, ale Google zastrzega, że taka blokada nie gwarantuje pozostania poza indeksem. Wystarczy, że ktoś umieści link do tej podstrony, i sytuacja może się zmienić.
Czym różni się zakaz skanowania od zakazu indeksowania?
Cały problem bierze się z pomylenia dwóch czynności, które robot Google wykonuje po kolei. Najpierw jest skanowanie, czyli pobranie podstrony i przeczytanie jej kodu. Dopiero potem następuje indeksowanie, czyli decyzja, czy adres trafi do bazy, z której powstają wyniki wyszukiwania.
Plik robots.txt steruje wyłącznie pierwszą czynnością. Reguła Disallow mówi robotowi: tego adresu nie wolno pobierać. Nie mówi nic o tym, czy adres może znaleźć się w wynikach. Google opisuje ten plik jako sposób na ograniczenie liczby żądań wysyłanych do serwera i zaznacza, że nie jest to mechanizm służący do ukrywania strony przed wyszukiwarką.
Znacznik noindex steruje drugą czynnością. Jest zapisany w kodzie podstrony albo w nagłówku odpowiedzi serwera i mówi: tę podstronę wolno pobrać, ale nie wolno pokazywać jej w wynikach. Żeby robot mógł się do niego zastosować, musi go najpierw przeczytać, a do tego potrzebuje dostępu do podstrony.
Wynika z tego prosta zasada. Zakaz skanowania nie usuwa adresu z Google, a zakaz indeksowania działa tylko wtedy, gdy skanowanie jest dozwolone. To dwa różne narzędzia do dwóch różnych celów, a nie dwa stopnie tej samej ochrony.
Dlaczego Google nie widzi znacznika noindex na zablokowanej podstronie?
Robot Google, zanim pobierze jakikolwiek adres, sprawdza plik robots.txt. Jeżeli adres jest objęty regułą Disallow, robot w ogóle nie wysyła żądania o tę podstronę. Nie pobiera jej kodu, więc nie ma jak dowiedzieć się, że w sekcji head czeka na niego znacznik noindex.
Z punktu widzenia Google taka podstrona nie ma żadnego zakazu indeksowania. Ma tylko zakaz pobierania. Jeśli więc adres był w indeksie wcześniej albo prowadzą do niego linki z innych miejsc, Google może go tam trzymać dalej, opierając się na tym, co wie z zewnątrz: na treści linków i starszych danych.
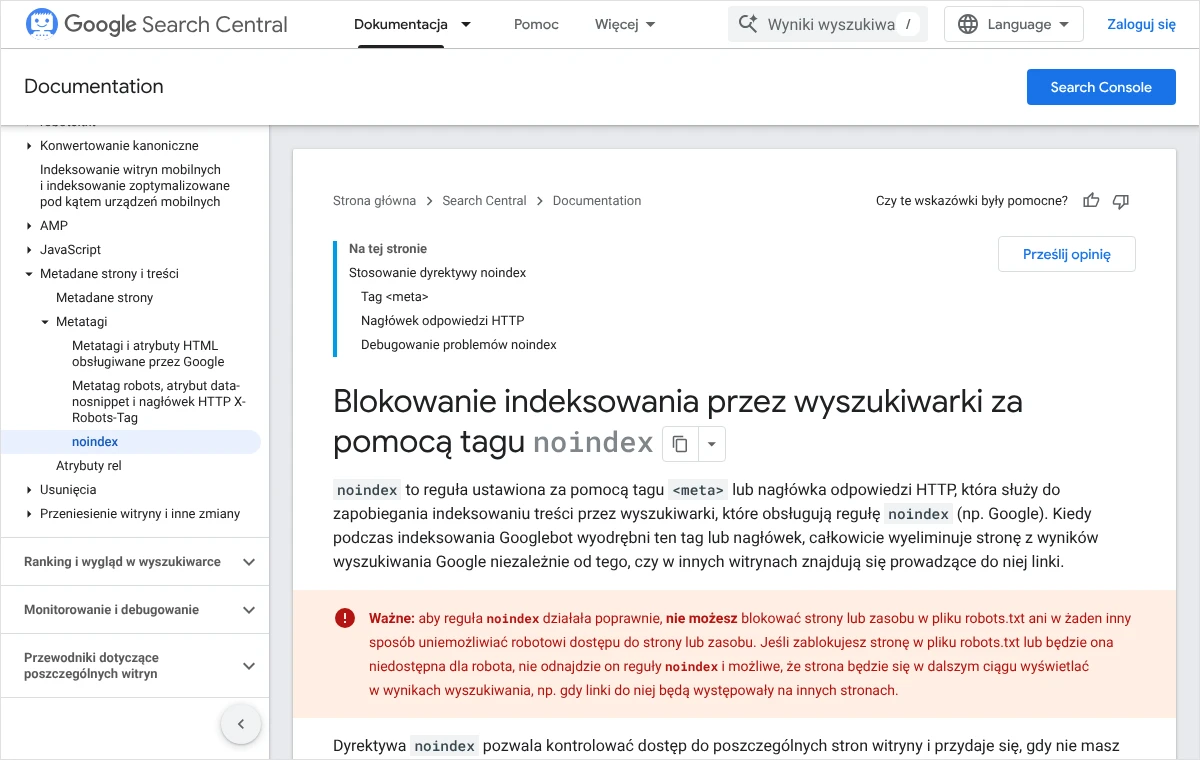
Dokumentacja Google ujmuje to jako warunek działania reguły noindex: podstrona ani zasób nie mogą być zablokowane w pliku robots.txt ani w żaden inny sposób niedostępne dla robota. W przeciwnym razie robot nie odnajdzie reguły i adres może nadal wyświetlać się w wynikach, na przykład wtedy, gdy linki do niego występują na innych stronach.
To samo dotyczy każdej innej wskazówki zapisanej w kodzie podstrony. Zablokowany robot nie przeczyta także tagu kanonicznego ani przekierowania wykonywanego przez skrypt. Blokada w robots.txt odcina Google od wszystkiego, co właściciel chciał mu na tej podstronie przekazać.
Nie pomoże też wpisanie zakazu indeksowania do samego pliku robots.txt. W sieci wciąż krążą przykłady z wierszem Noindex: w tym pliku, ale Google wprost podaje, że taka reguła nie jest obsługiwana. Obsługiwane pola to user-agent, allow, disallow i sitemap.
Skąd bierze się podwójna blokada na stronie?
Rzadko jest to świadoma decyzja jednej osoby. Zwykle blokady powstają w różnym czasie i w różnych miejscach, a nikt nie zestawia ich ze sobą. Z mojej praktyki wynika, że przyczyny powtarzają się w kilku odmianach.
- Ustawienie „na wszelki wypadek”. Ktoś dodał znacznik noindex, nie zobaczył szybkiego efektu i dopisał regułę w robots.txt, sądząc, że wzmocni ochronę.
- Pozostałość po wersji testowej. Serwis w budowie miał zablokowane skanowanie całej witryny i dodatkowo noindex, a po uruchomieniu część tych ustawień została w katalogach lub szablonach.
- Dwa narzędzia, dwie osoby. Plik robots.txt edytuje administrator serwera lub jedna wtyczka, a noindex ustawia redaktor w innej wtyczce, przy konkretnym wpisie albo typie treści.
- Zbyt szeroka reguła. Wiersz taki jak
Disallow: /*?alboDisallow: /produktobejmuje więcej adresów, niż planowano, w tym te, które mają własny noindex. - Gotowy szablon sklepu. Oprogramowanie sklepu lub motyw dostarcza plik robots.txt z blokadą koszyka, konta i wyszukiwarki, a te same podstrony mają jednocześnie noindex w kodzie.
W WordPressie osobnym źródłem zamieszania jest pole „Proś wyszukiwarki o nieindeksowanie tej witryny” w menu „Ustawienia” i dalej „Czytanie”. Dotyczy ono całej witryny, a nie pojedynczej podstrony, i bywa zaznaczone od czasu budowy serwisu. Przed dalszymi krokami trzeba ustalić, czy jest włączone, bo wpływa na wszystkie adresy naraz.
Warto też wiedzieć, że plik robots.txt nie zawsze jest fizycznym plikiem na serwerze. W wielu systemach jest generowany przez oprogramowanie lub wtyczkę, a fizyczny plik w katalogu głównym, jeśli istnieje, zastępuje wersję generowaną. Zdarza się więc, że zmiana w panelu nie daje efektu, bo robot czyta inny plik niż ten, który jest edytowany.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl, a przejmę sprawę: ustalę, które adresy mają jednocześnie noindex i blokadę w robots.txt, poprawię oba ustawienia we właściwej kolejności i dopilnuję, żeby Google przyjęło zmianę.
Jak sprawdzić, która blokada działa na danym adresie?
Zanim cokolwiek zostanie zmienione, trzeba mieć pewność, że na adresie rzeczywiście są obie blokady, a nie tylko jedna. Najpewniejszym źródłem jest Google Search Console, bo pokazuje stan widziany przez samego robota, a nie przez wtyczkę czy przeglądarkę. Osobom, które dopiero zaczynają pracę z tym narzędziem, pomoże tekst o tym, jak sprawdzić, czy Google zaindeksował stronę.
Sprawdzenie w narzędziu do sprawdzania adresów URL
- Po zalogowaniu do Google Search Console należy wybrać właściwą usługę, czyli stronę, której dotyczy problem.
- W polu wyszukiwania na górze ekranu wpisuje się pełny adres podstrony, razem z
https://, i zatwierdza klawiszem Enter. - Po wczytaniu wyniku trzeba rozwinąć sekcję „Indeksowanie stron”.
- W części „Skanowanie” należy odczytać wiersz „Czy skanowanie jest dozwolone”. Wartość „Nie” oznacza, że adres blokuje reguła w pliku robots.txt.
- Następnie należy odczytać wiersz „Pobranie strony”. Przy zablokowanym skanowaniu Google nie pobiera podstrony, więc nie ma tu informacji o udanym pobraniu.
- W części „Indeksowanie” znajduje się wiersz „Czy indeksowanie jest dozwolone”. Wartość „Nie” oznacza, że Google odczytało znacznik lub nagłówek noindex.
Kluczem do diagnozy jest zestawienie dwóch wierszy. Jeżeli skanowanie jest niedozwolone, Google nie mogło odczytać noindex, więc narzędzie nie potwierdzi zakazu indeksowania, nawet gdy znacznik jest w kodzie. To właśnie obraz podwójnej blokady: właściciel wie o noindex, a Google nie.
Sprawdzenie pliku robots.txt i kodu podstrony
Drugim krokiem jest obejrzenie obu blokad własnymi oczami. Plik robots.txt jest zawsze dostępny pod adresem domeny z dopisanym /robots.txt, na przykład https://nazwafirmy.pl/robots.txt. Wystarczy wpisać ten adres w przeglądarce.
- Po otwarciu pliku robots.txt należy odszukać grupę zaczynającą się od
User-agent: *oraz ewentualną grupęUser-agent: Googlebot. - W tych grupach trzeba przejrzeć wszystkie wiersze
Disallowi porównać je z początkiem ścieżki sprawdzanej podstrony. RegułaDisallow: /koszykobejmuje każdy adres, którego ścieżka zaczyna się od tych znaków. - Należy zwrócić uwagę na znaki specjalne. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu, więc
Disallow: /*.pdf$blokuje wszystkie adresy kończące się na „.pdf”. - Potem trzeba otworzyć samą podstronę, wyświetlić jej źródło (w większości przeglądarek skrót Ctrl+U) i wyszukać słowo „noindex”.
- Jeżeli w źródle nie ma znacznika, pozostaje sprawdzenie nagłówków odpowiedzi serwera w narzędziach deweloperskich przeglądarki, w karcie sieci, pod kątem wiersza
X-Robots-Tag.
Stan samego pliku widziany przez Google pokazuje raport dotyczący pliku robots.txt, dostępny w ustawieniach usługi w Search Console. Znajdują się w nim kolumny „Ścieżka pliku”, „Stan pobierania”, „Sprawdzono”, „Rozmiar” i „Problemy”. Stan „Pobrano” potwierdza, że Google czyta plik, a data w kolumnie „Sprawdzono” mówi, jak świeża jest wersja, z której korzysta robot.
Szczegółowe zasady pisania reguł, wraz z przykładami, omawiam w osobnym tekście o tym, jak ustawić plik robots.txt. Tutaj wystarczy ustalić jedno: który konkretnie wiersz obejmuje sprawdzany adres.
Jak naprawić ustawienia, gdy podstrona ma zniknąć z Google?
To najczęstszy cel. Podstrona ma pozostać dostępna dla ludzi, na przykład koszyk, podziękowanie po wysłaniu formularza czy wyniki wewnętrznej wyszukiwarki, ale nie powinna pojawiać się w wynikach. Rozwiązanie brzmi nieintuicyjnie: trzeba Google wpuścić, żeby mogło przeczytać zakaz.
Liczy się kolejność. Najpierw noindex musi być na miejscu, potem znika blokada skanowania. Odwrotna kolejność otwiera podstronę bez żadnego zakazu, a to ryzyko pełnego zindeksowania treści.
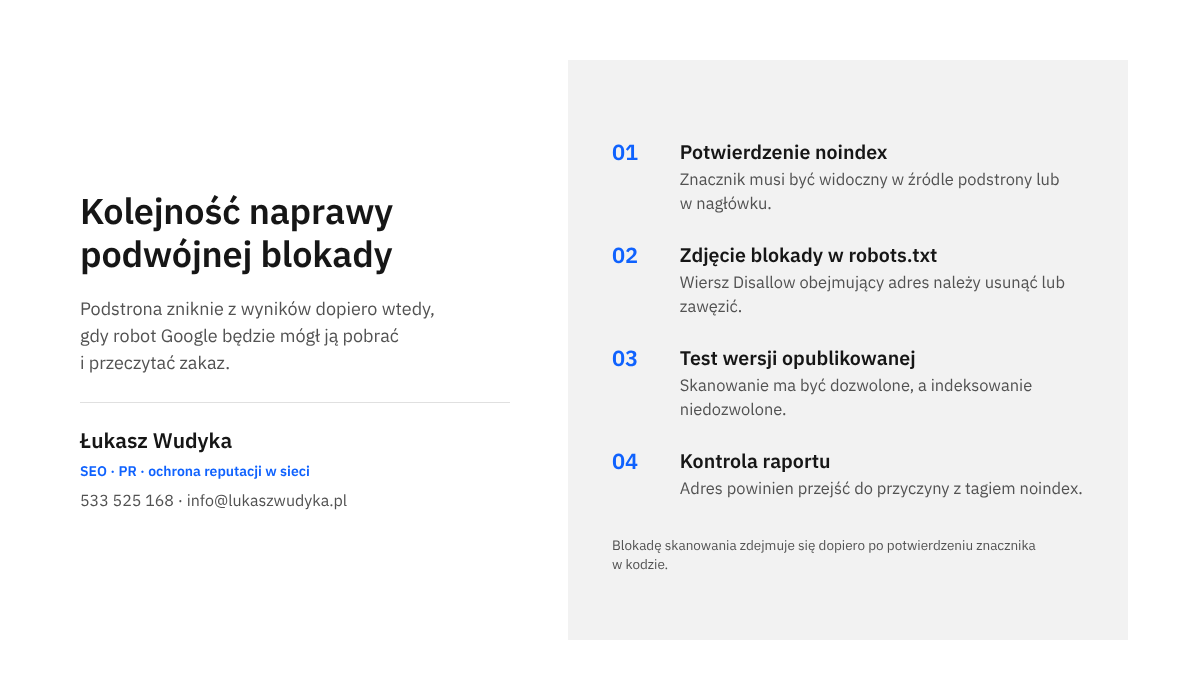
- Należy potwierdzić, że w sekcji
headpodstrony znajduje się znacznik<meta name="robots" content="noindex">. Jeśli go nie ma, trzeba go dodać w ustawieniach wpisu, we wtyczce do SEO albo w szablonie. - Następnie należy otworzyć plik robots.txt do edycji: przez menedżer plików lub FTP w katalogu głównym domeny albo w edytorze wtyczki, jeśli to ona generuje plik.
- Trzeba odszukać wiersz
Disallow, który obejmuje naprawiany adres, i usunąć go albo zawęzić tak, żeby przestał obejmować ten adres. - Po zapisaniu pliku należy otworzyć w przeglądarce adres
/robots.txti upewnić się, że widoczna jest nowa wersja. Jeśli widać starą, zwykle trzeba wyczyścić pamięć podręczną strony lub serwera. - W Search Console, w raporcie dotyczącym pliku robots.txt, obok pliku na liście należy kliknąć ikonę „Więcej ustawień” i wybrać „Poproś o ponowne zindeksowanie”. Bez tego Google i tak odświeży plik, zwykle w ciągu doby.
- W narzędziu do sprawdzania adresów URL należy wpisać adres podstrony i kliknąć „Sprawdź URL wersji opublikowanej”. Prawidłowy wynik to skanowanie dozwolone i indeksowanie niedozwolone.
- Na koniec można kliknąć „Poproś o zindeksowanie”, żeby Google szybciej odwiedziło podstronę i odczytało zakaz.
Jak dodać sam znacznik w różnych systemach, opisuję osobno w tekście o tym, jak wyłączyć pojedynczą podstronę z wyników Google metatagiem noindex. Tu skupiam się na tym, żeby robot mógł go przeczytać.
Jak zawęzić regułę, zamiast usuwać ją w całości?
Czasem blokada katalogu ma sens, a problem dotyczy jednego adresu w środku. Wtedy nie trzeba usuwać całego wiersza. Google stosuje regułę najbardziej szczegółową, czyli tę z najdłuższą pasującą ścieżką, więc dłuższa reguła Allow wygrywa z krótszą regułą Disallow.
User-agent: *
Disallow: /archiwum/
Allow: /archiwum/stary-regulamin/
W tym przykładzie cały katalog pozostaje zamknięty dla robota, ale jedna podstrona jest otwarta, dzięki czemu Google może odczytać jej znacznik noindex. Przy regułach o tej samej długości, które sobie przeczą, Google wybiera regułę mniej restrykcyjną.
Co z plikami PDF, grafikami i innymi zasobami bez kodu HTML?
W pliku PDF nie da się umieścić znacznika meta. Zakaz indeksowania przekazuje się wtedy w nagłówku odpowiedzi serwera X-Robots-Tag. Zasada jest identyczna jak przy zwykłych podstronach: nagłówek zadziała tylko wtedy, gdy plik nie jest zablokowany w robots.txt.
Na serwerze Apache dokumentacja Google podaje taki zapis dla wszystkich plików PDF w witrynie, umieszczany w pliku .htaccess lub w konfiguracji serwera:
<Files ~ "\.pdf$">
  Header set X-Robots-Tag "noindex, nofollow"
</Files>
Błąd w pliku .htaccess potrafi wyłączyć całą stronę, dlatego przed zmianą trzeba zachować kopię pliku, a po zmianie od razu otworzyć witrynę i sprawdzić, czy działa. Szerzej opisuję to w tekście o tym, jak zablokować indeksowanie plików PDF i grafik nagłówkiem X-Robots-Tag. Jeżeli w robots.txt jest wiersz typu Disallow: /*.pdf$, należy go usunąć dopiero po potwierdzeniu, że nagłówek jest wysyłany.
Jak naprawić ustawienia, gdy podstrona ma być widoczna w Google?
Bywa odwrotnie: podwójna blokada została po wersji testowej albo objęła podstrony, które powinny zdobywać ruch, na przykład kategorie sklepu czy wpisy na blogu. Wtedy trzeba zdjąć obie blokady, a kolejność ma mniejsze znaczenie, bo celem jest pełny dostęp.
- Należy usunąć znacznik noindex z podstrony: w ustawieniach wpisu, we wtyczce do SEO lub w szablonie. Jeśli zakaz dotyczył całej witryny w WordPressie, trzeba odznaczyć pole „Proś wyszukiwarki o nieindeksowanie tej witryny” i zapisać zmiany.
- Trzeba sprawdzić, czy noindex nie jest wysyłany dodatkowo w nagłówku
X-Robots-Tag, bo usunięcie samego znacznika z kodu wtedy nie wystarczy. - W pliku robots.txt należy usunąć lub zawęzić wiersz
Disallowobejmujący podstronę. - W narzędziu do sprawdzania adresów URL należy kliknąć „Sprawdź URL wersji opublikowanej” i potwierdzić, że skanowanie i indeksowanie są dozwolone.
- Następnie należy kliknąć „Poproś o zindeksowanie”. Liczba takich próśb w ciągu doby jest ograniczona, więc przy wielu adresach lepiej zgłosić najważniejsze, a resztę pozostawić mapie witryny.
Podstrona, która ma być w Google, powinna też znajdować się w mapie witryny i mieć linki wewnętrzne z innych części serwisu. Samo zdjęcie blokad pozwala na indeksowanie, ale go nie gwarantuje. O tym, czy adres trafi do wyników, decyduje Google na podstawie treści i jakości podstrony.
Co zrobić, gdy treść musi zniknąć szybko albo jest poufna?
Noindex działa dopiero po ponownej wizycie robota, a Google uprzedza, że ponowne zeskanowanie może potrwać nawet miesiące. Gdy liczy się czas, Search Console udostępnia narzędzie „Usunięcia”. Ukrywa ono adres w wynikach na około 6 miesięcy, co daje czas na trwałe uporządkowanie ustawień.
Zgłoszenie składa się w karcie „Tymczasowe usunięcia” przyciskiem „Nowa prośba”. Wybiera się „Tymczasowe usunięcie adresu URL”, wpisuje adres, zaznacza „Usuń tylko ten URL” albo „Usuń wszystkie URL-e z tym prefiksem” i klika „Dalej”. Druga opcja obejmuje wszystkie adresy zaczynające się od podanego ciągu, więc wymaga ostrożności.
To rozwiązanie tymczasowe. Po upływie tego okresu adres może wrócić do wyników, jeżeli w międzyczasie nie zostanie trwale zabezpieczony. Google wymienia trzy trwałe metody: usunięcie treści tak, żeby serwer zwracał kod 404 lub 410, ograniczenie dostępu hasłem albo znacznik noindex. W tej samej dokumentacji znajduje się ostrzeżenie, żeby do blokowania nie używać pliku robots.txt.
Przy treściach naprawdę poufnych, takich jak dokumenty z danymi klientów, faktury czy wersja testowa serwisu, ani noindex, ani robots.txt nie są ochroną. Oba są jedynie prośbą skierowaną do robotów wyszukiwarek, a plik robots.txt jest publiczny, więc każdy może przeczytać, jakie katalogi właściciel chciał ukryć. Takie zasoby trzeba zabezpieczyć hasłem albo usunąć z serwera.
Po czym poznać, że naprawa zadziałała, i co zrobić, gdy nie zadziałała?
Efekt nie jest natychmiastowy. Google przechowuje plik robots.txt w pamięci podręcznej zwykle do 24 godzin, potem musi jeszcze odwiedzić samą podstronę. Przy rzadko odwiedzanych adresach trwa to dłużej, dlatego ocena po jednym dniu bywa myląca.
Poprawny przebieg wygląda następująco. W narzędziu do sprawdzania adresów URL wiersz „Czy skanowanie jest dozwolone” pokazuje „Tak”, a „Czy indeksowanie jest dozwolone” pokazuje „Nie”. W raporcie „Indeksowanie stron” adres znika z ostrzeżenia o stronach zindeksowanych mimo blokady i pojawia się w tabeli „Dlaczego strony nie są indeksowane” z przyczyną „URL zawiera tag „noindex””. To stan docelowy, a nie błąd wymagający naprawy.
Po uporządkowaniu wszystkich adresów z danej grupy można otworzyć w raporcie szczegóły problemu i kliknąć „Sprawdź poprawkę”. Google zacznie ponownie sprawdzać zgłoszone adresy. Według dokumentacji taka weryfikacja trwa zwykle do dwóch tygodni, czasem dłużej, i nie należy uruchamiać jej ponownie przed zakończeniem.
Gdy mimo zmian nic się nie dzieje
Jeżeli po kilku tygodniach adres nadal figuruje jako zablokowany, przyczyna leży najczęściej w jednym z poniższych miejsc.
- Google czyta inny plik. Każda subdomena i każdy protokół mają własny robots.txt. Plik pod adresem z „www” nie obowiązuje dla adresu bez „www” ani dla subdomeny sklepu.
- Zmiana nie została opublikowana. Pamięć podręczna serwera lub usługi CDN nadal podaje starą wersję pliku. Potwierdza to data w kolumnie „Sprawdzono” i treść pliku w raporcie.
- Adres blokuje inna reguła. Po usunięciu jednego wiersza adres wciąż pasuje do innego, zwykle z gwiazdką.
- Serwer odmawia robotowi dostępu. Zapora, wtyczka bezpieczeństwa lub logowanie zwracają robotowi błąd, więc mimo otwartego robots.txt znacznik pozostaje nieodczytany.
- Znacznik jest dodawany skryptem. Noindex wstawiany dopiero przez JavaScript może zostać odczytany później albo wcale. Pewniejszy jest znacznik obecny w źródle strony od razu.
W każdym z tych przypadków rozstrzyga wynik testu „Sprawdź URL wersji opublikowanej”, a po nim „Wyświetl przetestowaną stronę”. Pokazuje on kod, który robot faktycznie otrzymał, więc od razu widać, czy znacznik noindex do niego dotarł.
Jakich błędów unikać przy porządkowaniu blokad?
Najpoważniejszy błąd to zdjęcie blokady w robots.txt bez upewnienia się, że noindex naprawdę jest w kodzie. Wtyczka może pokazywać włączoną opcję, a szablon lub inna wtyczka może ją nadpisywać. Zawsze trzeba sprawdzić źródło strony, a nie ustawienie w panelu.
Drugi błąd to masowe zmiany bez kopii. Przed edycją pliku robots.txt należy zachować jego dotychczasową treść w osobnym pliku. Jeden nieuważnie usunięty lub dopisany wiersz, zwłaszcza Disallow: /, zamyka przed robotem całą witrynę.
Trzeci błąd to zbyt wczesne przywrócenie blokady. Część osób po kilku dniach dopisuje regułę Disallow z powrotem, żeby robot nie tracił czasu na te adresy. Jeżeli Google nie zdążyło jeszcze odczytać noindex, cała praca wraca do punktu wyjścia. Przywrócenie blokady ma sens dopiero wtedy, gdy adresy zniknęły z indeksu, i tylko przy dużych grupach adresów, które obciążają serwer. Trzeba przy tym liczyć się z tym, że linki z zewnątrz mogą z czasem ponownie wprowadzić sam adres do wyników.
Czwarty błąd to pozostawienie w mapie witryny adresów z noindex. Mapa mówi Google, które adresy są ważne, a znacznik mówi coś przeciwnego. Sprzeczne sygnały wydłużają porządkowanie i zaciemniają raporty.
Piąty błąd to blokowanie w robots.txt plików stylów i skryptów potrzebnych do wyświetlenia strony. Google zaleca, żeby nie blokować zasobów, bez których robot nie zrozumie podstrony. Przy okazji przeglądu pliku warto usunąć takie reguły, jeśli pozostały po dawnych zaleceniach.
Uważam też, że nie należy stosować noindex i tagu kanonicznego wskazującego na inny adres jako dwóch zabezpieczeń jednocześnie. To kolejny zestaw sprzecznych informacji. Dla każdej podstrony powinna istnieć jedna, czytelna decyzja: ma być w Google, ma być poza Google albo ma ustąpić miejsca innej wersji.
Najczęstsze pytania
Czy sam plik robots.txt wystarczy, żeby podstrona nie pojawiała się w Google?
Nie. Plik robots.txt zakazuje pobierania treści, ale nie zakazuje umieszczenia adresu w indeksie. Google może pokazać taki adres w wynikach bez opisu, jeśli prowadzą do niego linki. Do wyłączenia podstrony z wyników służy znacznik noindex, ograniczenie dostępu hasłem albo usunięcie treści.
Ile trwa zniknięcie adresu z wyników po zdjęciu blokady w robots.txt?
Nie ma stałego terminu. Google odświeża plik robots.txt zwykle w ciągu doby, a potem musi ponownie odwiedzić podstronę i odczytać noindex. Przy często odwiedzanych serwisach trwa to dni, przy rzadko odwiedzanych adresach tygodnie, a dokumentacja dopuszcza nawet miesiące. Prośba o zindeksowanie w narzędziu do sprawdzania adresów URL przyspiesza wizytę robota.
Czy po zniknięciu adresu z Google można ponownie zablokować go w robots.txt?
Można, ale rzadko jest to potrzebne. Podstrona z noindex jest odwiedzana przez robota coraz rzadziej i nie obciąża znacząco serwera. Ponowna blokada sprawia, że Google przestaje widzieć znacznik, więc po pojawieniu się nowych linków sam adres może wrócić do wyników. Zalecam pozostawienie noindex bez blokady, chyba że chodzi o bardzo duże grupy adresów.
Czy wiersz „Noindex:” wpisany w pliku robots.txt działa?
Nie. Google wprost podaje, że określenie reguły noindex w pliku robots.txt nie jest obsługiwane. Zakaz indeksowania trzeba umieścić w kodzie podstrony jako znacznik meta albo w nagłówku odpowiedzi serwera X-Robots-Tag.
Search Console pokazuje „URL zablokowany przez plik robots.txt”. Czy to błąd?
Niekoniecznie. Jeżeli adresy mają tylko nie obciążać serwera i nie ma ich w wynikach, taki stan bywa zamierzony, na przykład przy adresach z filtrami. Problemem staje się wtedy, gdy te same adresy pojawiają się w wynikach albo gdy powinny być indeksowane. Wtedy trzeba zdecydować, czy mają być widoczne, i ustawić jedną, właściwą metodę.
Czy noindex na podstronie szkodzi reszcie serwisu?
Nie. Znacznik dotyczy wyłącznie adresu, na którym się znajduje. Wyłączenie z wyników koszyka, wyników wyszukiwarki wewnętrznej czy podstron z podziękowaniem jest zwykłą praktyką porządkową. Szkodzi dopiero noindex ustawiony przez pomyłkę na podstronach, które mają zdobywać ruch.
Czy inne wyszukiwarki traktują ten zestaw tak samo jak Google?
Zasada jest wspólna: robot, który nie może pobrać podstrony, nie przeczyta zapisanego w niej znacznika. Szczegóły obsługi poszczególnych reguł mogą się jednak różnić między wyszukiwarkami, o czym Google samo uprzedza w dokumentacji. Opisane tu nazwy raportów i przycisków dotyczą wyłącznie Google Search Console.
Kiedy blokada w robots.txt jest właściwym wyborem?
Wtedy, gdy celem jest ograniczenie ruchu robota, a nie ukrycie adresu. Dotyczy to dużych grup adresów bez wartości dla wyszukiwarki, które powstają automatycznie, takich jak kombinacje filtrów czy sortowania, i obciążają serwer. Google wskazuje też ten plik jako sposób na wyłączenie z wyników plików graficznych, wideo i dźwiękowych.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zrozumiałe. Blokady skanowania i indeksowania są rozproszone po kilku miejscach, a pomyłka w jednym wierszu potrafi ukryć przed Google całą stronę. Chętnie zajmę się tym od początku do końca: sprawdzę plik robots.txt, znaczniki i nagłówki na wszystkich typach podstron, wskażę adresy z podwójną blokadą, ustawię dla każdej grupy jedną właściwą metodę, a potem będę obserwować raporty w Search Console, aż Google potwierdzi zmianę.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Odpowiem, co widzę, co wymaga poprawy i ile to potrwa.