W raporcie indeksowania w Google Search Console pojawia się pozycja „Błąd przekierowania”, a obok niej liczba adresów, których Google nie dodał do wyników wyszukiwania. Właściciel firmy otwiera te adresy w przeglądarce i najczęściej widzi normalnie działającą stronę. Trudno wtedy zrozumieć, co właściwie jest zepsute i czy trzeba się tym zajmować.
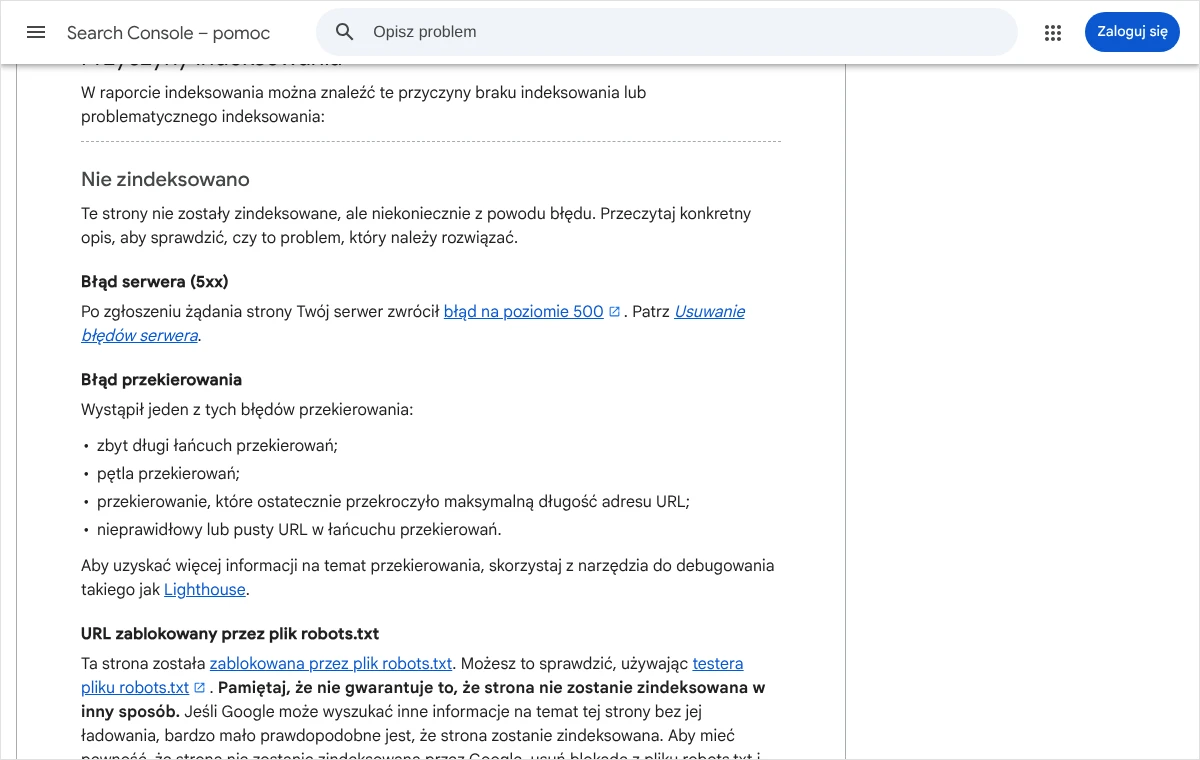
Trzeba, ponieważ ten komunikat oznacza, że robot Google ruszył spod danego adresu w drogę do strony docelowej i do niej nie dotarł. Dokumentacja Google wymienia dokładnie cztery powody takiej sytuacji: zbyt długi łańcuch przekierowań, pętlę, adres, który po drodze stał się za długi, oraz nieprawidłowy lub pusty adres w łańcuchu. Każdy z nich ma inne źródło i inaczej się go usuwa.
Ten wpis jest instrukcją dla osób, które same opiekują się stroną firmy albo chcą dokładnie wiedzieć, czego wymagać od wykonawcy. Po lekturze będzie wiadomo, jak odczytać raport, jak zobaczyć pełną drogę przekierowania, jak ustalić, która z czterech przyczyn zachodzi, jak ją usunąć i jak potwierdzić w Search Console, że problem zniknął.
Gdzie w Search Console widać „Błąd przekierowania” i co oznacza?
Komunikat znajduje się w raporcie „Indeksowanie stron”. W menu po lewej stronie należy rozwinąć grupę „Indeksowanie” i wybrać pozycję „Strony”. Pod wykresem znajduje się tabela „Dlaczego strony nie są indeksowane”, a w niej wiersze z nazwami przyczyn. Jednym z nich jest „Błąd przekierowania”.
Po kliknięciu tego wiersza otwiera się strona szczegółów: wykres pokazujący, jak zmieniała się liczba adresów z tym problemem, oraz lista przykładowych adresów z datą ostatniego skanowania. Ta data jest ważna. Jeżeli robot był pod adresem dawno, a w tym czasie na stronie coś zmieniano, wpis w raporcie może opisywać stan, którego już nie ma.
Sam komunikat mówi tylko tyle, że pod adresem ustawiono przekierowanie, którego robot nie zdołał przejść do końca. Search Console nie podaje, na którym odcinku droga się urwała ani która z czterech przyczyn wystąpiła. To trzeba ustalić samodzielnie i właśnie od tego zależy sposób naprawy.
Skutek dla widoczności jest prosty: adres z tym błędem nie trafia do indeksu, a strona, do której miał prowadzić, nie otrzymuje od niego żadnego wsparcia. Jeżeli błąd dotyczy starych adresów po przebudowie serwisu, przepadają linki, które przez lata do nich prowadziły. Jeżeli dotyczy adresów aktualnej oferty, te podstrony po prostu nie pojawiają się w Google.
Czym ten błąd różni się od stanu „Strona zawiera przekierowanie”?
W tej samej tabeli często widać drugi, podobnie brzmiący wiersz: „Strona zawiera przekierowanie”. Te dwa stany łatwo pomylić, a oznaczają coś zupełnie innego. „Strona zawiera przekierowanie” to informacja, że adres poprawnie odsyła w inne miejsce, więc Google indeksuje stronę docelową zamiast niego. W większości przypadków jest to stan prawidłowy i nie wymaga żadnych działań.
„Błąd przekierowania” oznacza natomiast, że przekierowanie istnieje, ale nie działa do końca. Robot nie doszedł do żadnej strony, którą mógłby zindeksować. Szerzej o tym pierwszym stanie piszę w osobnym tekście: kiedy „Strona zawiera przekierowanie” jest problemem, a kiedy nie.
Praktyczna wskazówka: jeżeli adresy widnieją w wierszu „Strona zawiera przekierowanie”, zwykle wystarczy je przejrzeć i upewnić się, że odsyłają tam, gdzie powinny. Jeżeli widnieją w wierszu „Błąd przekierowania”, każdy z nich wymaga sprawdzenia i poprawki.
Jak zobaczyć całą drogę przekierowania, adres po adresie?
Zwykłe otwarcie adresu w przeglądarce niewiele mówi. Przeglądarka pokazuje tylko punkt końcowy, pamięta wcześniejsze przekierowania i często przechodzi drogę, na której robot się zatrzymał. Potrzebny jest podgląd wszystkich przystanków po kolei, razem z kodami odpowiedzi serwera.
Warto też wiedzieć, czego nie pokaże samo Search Console. Narzędzie do sprawdzania adresów URL ma test wersji opublikowanej, ale według dokumentacji test ten najpierw przechodzi przez przekierowania, a potem bada stronę, i nie informuje, że przekierowanie nastąpiło, ani nie wyświetla końcowego adresu. Do odtworzenia łańcucha trzeba więc użyć innego narzędzia.
Podgląd w przeglądarce Chrome
- Należy otworzyć nowe okno w trybie incognito, aby przeglądarka nie korzystała z zapamiętanych wcześniej przekierowań ani plików cookie.
- Trzeba otworzyć narzędzia dla deweloperów klawiszem F12 i przejść do karty „Sieć” (w angielskiej wersji „Network”).
- Na pasku tej karty zaznacza się opcję „Zachowaj dziennik” (w angielskiej wersji „Preserve log”). Bez niej lista czyści się przy każdym przejściu na kolejny adres.
- W pasku adresu wkleja się adres skopiowany z raportu Search Console, dokładnie w tej postaci, w jakiej tam widnieje, i zatwierdza klawiszem Enter.
- Na liście żądań trzeba odszukać pierwsze wiersze typu dokument. Każdy wiersz z kodem 301, 302, 307 lub 308 to jeden przeskok.
- Po kliknięciu wiersza, w części z nagłówkami odpowiedzi, widać pole „Location”. To adres, pod który serwer odsyła dalej. Należy przepisać kolejno wszystkie adresy aż do tego, który odpowiada kodem 200 albo błędem.
Podgląd w wierszu poleceń
Osoby, które mają dostęp do terminala, zobaczą to samo jednym poleceniem. Narzędzie curl wypisuje nagłówki każdej odpowiedzi po kolei:
curl -I -L https://www.example.com/stary-adres/
W wyniku należy czytać wiersze zaczynające się od „HTTP” (kod odpowiedzi) oraz „location” (następny adres). Jeżeli polecenie kończy się komunikatem o przekroczeniu dopuszczalnej liczby przekierowań, sprawa dotyczy pętli albo bardzo długiego łańcucha.
Lighthouse i narzędzia do skanowania serwisu
Dokumentacja Google przy opisie tego błędu odsyła do narzędzi diagnostycznych takich jak Lighthouse, dostępnych między innymi w narzędziach dla deweloperów Chrome. Raport Lighthouse wskazuje przekierowania, przez które przeglądarka przeszła przed wczytaniem strony. Przy dużej liczbie adresów wygodniejszy bywa program, który skanuje cały serwis i tworzy zestawienie łańcuchów przekierowań, ale do naprawy kilkunastu adresów w zupełności wystarcza przeglądarka.
Wynik tego etapu powinien mieć postać prostej notatki dla każdego sprawdzanego adresu: adres początkowy, kolejne przystanki, kod odpowiedzi przy każdym z nich i miejsce, w którym droga się kończy. Z taką notatką rozpoznanie przyczyny zajmuje chwilę.
Jak rozpoznać, która z czterech przyczyn zachodzi?
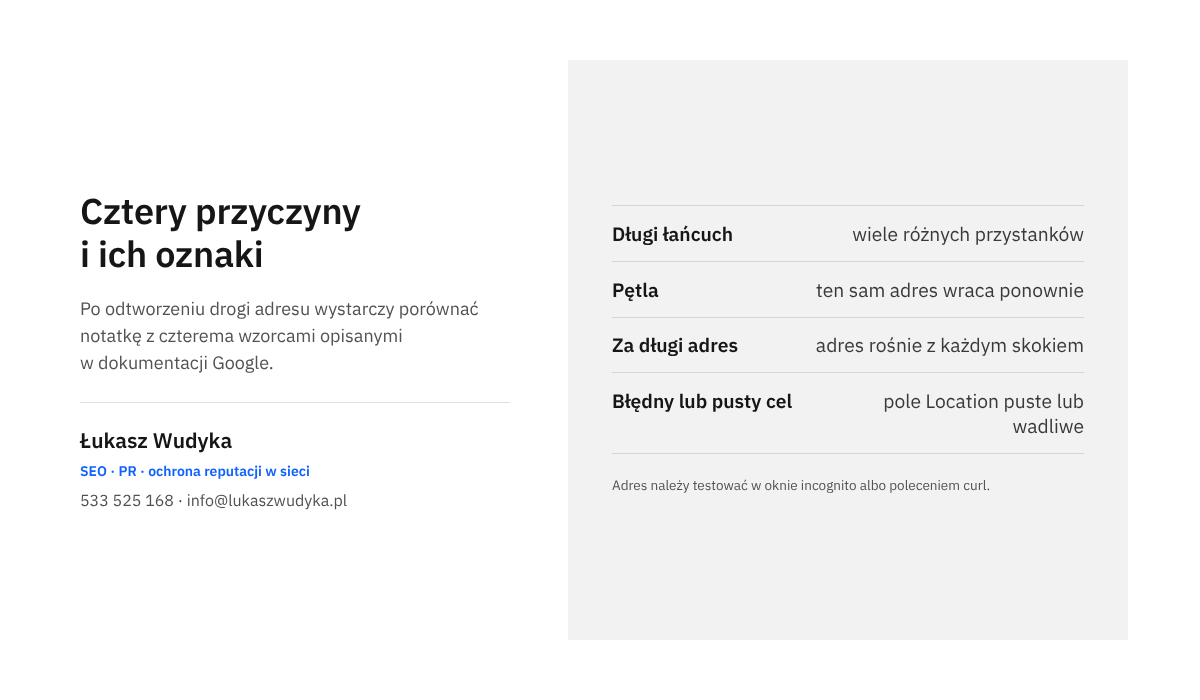
Notatkę z poprzedniego etapu wystarczy porównać z czterema wzorcami. Zwykle już na pierwszy rzut oka widać, z którym z nich ma się do czynienia.
- Zbyt długi łańcuch: adresy się nie powtarzają, droga w końcu prowadzi do działającej strony, ale przystanków jest bardzo dużo.
- Pętla: ten sam adres pojawia się w notatce po raz drugi, a przeglądarka wyświetla komunikat z kodem
ERR_TOO_MANY_REDIRECTS. - Za długi adres: każdy kolejny przystanek jest dłuższy od poprzedniego, bo do adresu dokleja się ten sam fragment albo kolejne parametry.
- Nieprawidłowy lub pusty adres: w polu „Location” jest pusto albo widnieje tam coś, co nie jest poprawnym adresem, na przykład podwójny przedrostek, spacja lub niezamieniony znacznik szablonu.
Zdarza się, że pod każdym adresem z raportu wszystko działa: jeden przeskok i strona docelowa z kodem 200. Najczęściej oznacza to, że błąd został już usunięty przy okazji innych prac, a raport pokazuje stan z dnia ostatniego skanowania. Wtedy wystarczy przejść do części o zgłaszaniu poprawki. Druga możliwość jest mniej wygodna: serwer inaczej odpowiada robotowi niż zwykłemu odwiedzającemu, o czym piszę dalej.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę wtedy sprawę: odtworzę drogę każdego adresu z raportu, wskażę regułę, która powoduje błąd, i przygotuję poprawkę razem ze zgłoszeniem do ponownej weryfikacji w Search Console.
Zbyt długi łańcuch przekierowań. Jak go skrócić do jednego przeskoku?
Łańcuch powstaje wtedy, gdy adres nie odsyła od razu do celu, tylko do kolejnego adresu, który również odsyła dalej. Według dokumentacji Google roboty domyślnie śledzą do 10 przeskoków. To górna granica, a nie wartość, do której wolno się zbliżać. Każdy przeskok wydłuża czas wczytywania i zwiększa ryzyko, że któryś odcinek przestanie kiedyś działać.
Skąd biorą się długie łańcuchy?
Rzadko ktoś ustawia je celowo. Narastają latami: serwis zmienia domenę, potem układ adresów, potem przechodzi na https, a każda zmiana dokłada nową warstwę reguł na stare. Typowa droga wygląda wtedy tak: wersja http odsyła do https, wersja bez www do wersji z www, adres bez ukośnika na końcu do adresu z ukośnikiem, a stary adres podstrony do nowego. Cztery reguły, każda z osobna poprawna, razem dają cztery przeskoki, zanim w ogóle zacznie działać przekierowanie właściwej treści.
Jak naprawić łańcuch?
- Dla każdego adresu z notatki należy ustalić adres końcowy, czyli ten, który odpowiada kodem 200 i ma pozostać w serwisie.
- Regułę dla adresu początkowego trzeba zmienić tak, aby wskazywała bezpośrednio adres końcowy, w pełnej postaci: z właściwym protokołem, z www lub bez, z ukośnikiem na końcu lub bez, zgodnie z tym, jak serwis faktycznie działa.
- To samo należy zrobić dla każdego pośredniego przystanku. Stare adresy nadal mogą mieć linki z innych stron, więc każdy z nich powinien prowadzić prosto do celu.
- Reguły ogólne (https, www, ukośnik) warto połączyć w jedną, która od razu ustawia ostateczną postać adresu, zamiast poprawiać ją w trzech osobnych podejściach.
- Na koniec trzeba powtórzyć test z podglądem drogi i potwierdzić, że został jeden przeskok.
Na serwerze Apache połączenie reguł dla https i www w pliku .htaccess może wyglądać tak (w miejsce przykładowej domeny wstawia się własną):
RewriteEngine On
RewriteCond %{HTTPS} off [OR]
RewriteCond %{HTTP_HOST} !^www\. [NC]
RewriteRule ^ https://www.example.com%{REQUEST_URI} [L,R=301]
Przed jakąkolwiek zmianą w tym pliku należy pobrać jego kopię na dysk. Jeden błędny znak potrafi wyłączyć cały serwis, a przywrócenie kopii trwa kilkanaście sekund. Składnię i zasady bezpiecznej edycji opisuję we wpisie o tym, jak ustawić przekierowanie 301 w pliku .htaccess.
Trzeba też poprawić to, co prowadzi do starych adresów od środka: linki w menu, w treści i w stopce oraz adresy w mapie witryny. Powinny wskazywać adres końcowy, a nie taki, który dopiero do niego odsyła. Przekierowanie jest zabezpieczeniem dla linków z zewnątrz, nie sposobem na nawigację we własnym serwisie.
Pętla przekierowań. Jak znaleźć dwie reguły, które sobie przeczą?
Pętla oznacza, że adres A odsyła do B, a B z powrotem do A, czasem przez kilka dodatkowych przystanków. Robot krąży, aż wyczerpie dopuszczalną liczbę przeskoków, i rezygnuje. Przyczyną są prawie zawsze dwie reguły ustawione w dwóch różnych miejscach, z których każda uważa inną postać adresu za właściwą.
Protokół https wymuszany w dwóch miejscach
To najczęstszy przypadek w serwisach korzystających z sieci pośredniczącej, na przykład Cloudflare. Jeżeli pośrednik łączy się z serwerem zwykłym protokołem http, a serwer ma regułę odsyłającą każde takie połączenie do https, powstaje koło bez wyjścia: odwiedzający prosi o https, pośrednik pyta serwer po http, serwer odsyła do https i tak bez końca.
Naprawa polega na tym, aby połączenie między pośrednikiem a serwerem również było szyfrowane. W panelu pośrednika ustawia się tryb pełnego szyfrowania, co wymaga ważnego certyfikatu na serwerze.
Spór o www i o ukośnik na końcu adresu
Drugi częsty przypadek to niezgodność między ustawieniami systemu a regułami serwera. W WordPressie adres serwisu zapisany jest w „Ustawienia”, „Ogólne”, w polach „Adres WordPressa (URL)” i „Adres witryny (URL)”. Jeżeli widnieje tam wersja z www, a plik .htaccess albo panel hostingu odsyła do wersji bez www, system i serwer będą odsyłać odwiedzającego jeden do drugiego.
Uwaga na te dwa pola: wpisanie w nich błędnego adresu odcina dostęp do panelu administracyjnego. Bezpieczniej najpierw odczytać, co w nich jest, i dostosować do tego regułę serwera, niż zmieniać je bez sprawdzenia. Podobny spór dotyczy ukośnika: system dodaje go na końcu adresu, a reguła serwera go usuwa.
Dwie wtyczki albo wtyczka i serwer
Trzecie źródło to przekierowania ustawione równolegle w kilku narzędziach: we wtyczce do przekierowań, w module wtyczki SEO, we wtyczce do tłumaczeń i w pliku .htaccess. Wystarczy, że jedno z nich odsyła ze starego adresu do nowego, a drugie, ustawione kiedyś w odwrotnym kierunku, odsyła z powrotem.
Skuteczna metoda szukania to wyłączanie po jednym źródle i ponowny test po każdej zmianie. Kolejność, którą stosuję: najpierw lista reguł we wtyczce do przekierowań, potem plik .htaccess, potem ustawienia przekierowań w panelu hostingu, na końcu sieć pośrednicząca. Po każdym kroku należy wyczyścić pamięć podręczną serwisu, bo zapisana w niej stara odpowiedź potrafi udawać, że błąd nadal istnieje.
Za długi albo nieprawidłowy adres w łańcuchu. Jak znaleźć źródło?
Dwie pozostałe przyczyny występują rzadziej, ale trudniej je zauważyć, bo powstają zwykle w regułach tworzonych automatycznie.
Adres, który wydłuża się przy każdym przeskoku
Trzecia przyczyna z dokumentacji to przekierowanie, które ostatecznie przekroczyło maksymalną długość adresu URL. W praktyce jest to odmiana pętli, w której adres nie wraca do tej samej postaci, tylko rośnie. W notatce widać to wyraźnie: każdy kolejny przystanek ma na końcu ten sam dopisany fragment.
Źródłem bywa reguła, która dokleja coś do adresu bez sprawdzenia, czy ten fragment już w nim jest. Typowe przykłady to oznaczenie języka dopisywane wielokrotnie (adres z jednym „/pl/” zamienia się w adres z dwoma, potem z trzema), parametr powrotu, w którym zapisywany jest cały poprzedni adres razem z poprzednim parametrem, albo identyfikator sesji dodawany przy każdym przejściu.
Naprawa wymaga odnalezienia reguły, która dopisuje fragment, i uzupełnienia jej o warunek: przekierowanie ma zadziałać tylko wtedy, gdy adres jeszcze tego fragmentu nie zawiera. W regułach serwera Apache służy do tego wiersz z warunkiem umieszczony przed regułą. We wtyczkach językowych zwykle wystarcza poprawienie ustawienia, w którym wybiera się sposób zapisu języka w adresie, tak aby tylko jedno narzędzie za to odpowiadało.
Jeżeli wydłużanie dotyczy stron logowania, koszyka lub konta klienta, przyczyną bywa przekierowanie niezalogowanych odwiedzających na stronę logowania z zapisanym adresem powrotu. Robot Google nie loguje się, więc trafia w ten mechanizm za każdym razem. Takie adresy nie powinny w ogóle znajdować się w mapie witryny ani w linkach dostępnych dla robota.
Nieprawidłowy lub pusty adres docelowy
Czwarta przyczyna oznacza, że serwer odpowiedział kodem przekierowania, ale nie podał poprawnego celu. W podglądzie drogi widać wiersz z kodem 301 lub 302, a w polu „Location” jest pusto albo znajduje się tam tekst, którego nie da się otworzyć jako adresu.
Najczęstsze postaci błędnego celu, które spotykam przy przeglądach serwisów:
- podwójny przedrostek, czyli adres zaczynający się od „https://https://”,
- brak dwukropka lub ukośnika w przedrostku, na przykład „https//” albo „https:/”,
- spacja, znak nowego wiersza albo polskie znaki wklejone bez zakodowania,
- niezamieniony znacznik szablonu, na przykład nazwa zmiennej w nawiasach zamiast gotowego adresu,
- puste pole celu w regule dodanej masowo z arkusza, w którym część wierszy nie miała drugiej kolumny.
Źródła szuka się tam, gdzie reguły powstają masowo: w imporcie przekierowań z pliku, w ustawieniach wtyczki po zmianie adresu serwisu, w kodzie motywu, który sam buduje adres docelowy. Listę reguł we wtyczce należy przejrzeć pod kątem pustych i podejrzanie wyglądających celów. Jeżeli wtyczka pozwala wyeksportować reguły do pliku, w arkuszu takie wiersze widać od razu po posortowaniu kolumny z adresem docelowym.
Przekierowanie zapisane w kodzie strony zamiast w odpowiedzi serwera, czyli znacznik odświeżenia albo skrypt, również może wskazywać błędny cel. Google zaleca przekierowania po stronie serwera jako najlepszy sposób kierowania robota i odwiedzających, a pozostałe metody dopuszcza tam, gdzie serwerowych nie da się ustawić. Przy okazji naprawy warto więc zamienić takie rozwiązania na zwykłe przekierowanie 301.
Co zrobić, gdy w przeglądarce wszystko działa, a raport nadal pokazuje błąd?
Najpierw trzeba wykluczyć najprostsze wyjaśnienie, czyli nieaktualny wpis. Data ostatniego skanowania przy adresie na liście przykładów pokazuje, kiedy robot widział błąd. Jeżeli od tego dnia w serwisie zmieniano przekierowania, raport po prostu jeszcze nie nadążył.
Jeżeli data jest świeża, serwer prawdopodobnie odpowiada robotowi inaczej niż zwykłemu odwiedzającemu. Przyczyną bywa zapora lub ochrona przed botami, która odsyła nieznany ruch na stronę weryfikacji, przekierowanie zależne od kraju lub języka przeglądarki albo osobna wersja dla telefonów. Google skanuje serwisy przede wszystkim robotem przedstawiającym się jako telefon, więc test należy powtórzyć w trybie urządzenia mobilnego w narzędziach przeglądarki.
Pomaga także narzędzie do sprawdzania adresów URL w Search Console. Adres wkleja się w pasek na górze ekranu, a po wyświetleniu wyniku należy kliknąć „Sprawdź URL wersji opublikowanej”. Test nie pokaże drogi przekierowania, ale pokaże, czy robot dociera dziś do strony. Wynik pozytywny oznacza, że przeszkoda zniknęła. Wynik negatywny potwierdza, że serwer traktuje robota inaczej, i wtedy trzeba przejrzeć ustawienia zapory oraz reguły zależne od urządzenia i położenia.
Przekierowania zależne od położenia odwiedzającego radzę ograniczać do minimum. Robot Google łączy się zwykle z jednego kraju, więc może nigdy nie zobaczyć pozostałych wersji, a źle ustawiona reguła tego rodzaju jest częstym źródłem pętli między wersjami językowymi.
Jak zgłosić poprawkę i sprawdzić, czy Google ją przyjął?
Zgłoszenie ma sens dopiero wtedy, gdy poprawione są wszystkie adresy z danej grupy, a nie tylko te z listy przykładów. Lista pokazuje wybrane adresy, a weryfikacja obejmuje wszystkie, które Google zna. Jeżeli część pozostanie zepsuta, weryfikacja zakończy się niepowodzeniem.
- Każdy poprawiony adres należy jeszcze raz sprawdzić podglądem drogi: jeden przeskok i strona docelowa z kodem 200.
- W Search Console trzeba otworzyć raport „Indeksowanie stron” i kliknąć wiersz „Błąd przekierowania”.
- Na stronie szczegółów należy kliknąć przycisk „Sprawdź poprawkę”. Search Console sprawdza najpierw kilka stron, a jeżeli błąd na nich zniknął, przechodzi do pozostałych znanych adresów.
- Postęp widać po kliknięciu „Sprawdź szczegóły”. Poszczególne adresy otrzymują stan „Oczekuje”, „Powodzenie” lub „Niepowodzenie”.
- Dla kilku najważniejszych adresów można dodatkowo użyć narzędzia do sprawdzania adresów URL i kliknąć „Poproś o zindeksowanie”. Liczba takich próśb w ciągu doby jest ograniczona, więc nie warto zużywać ich na adresy mało istotne.
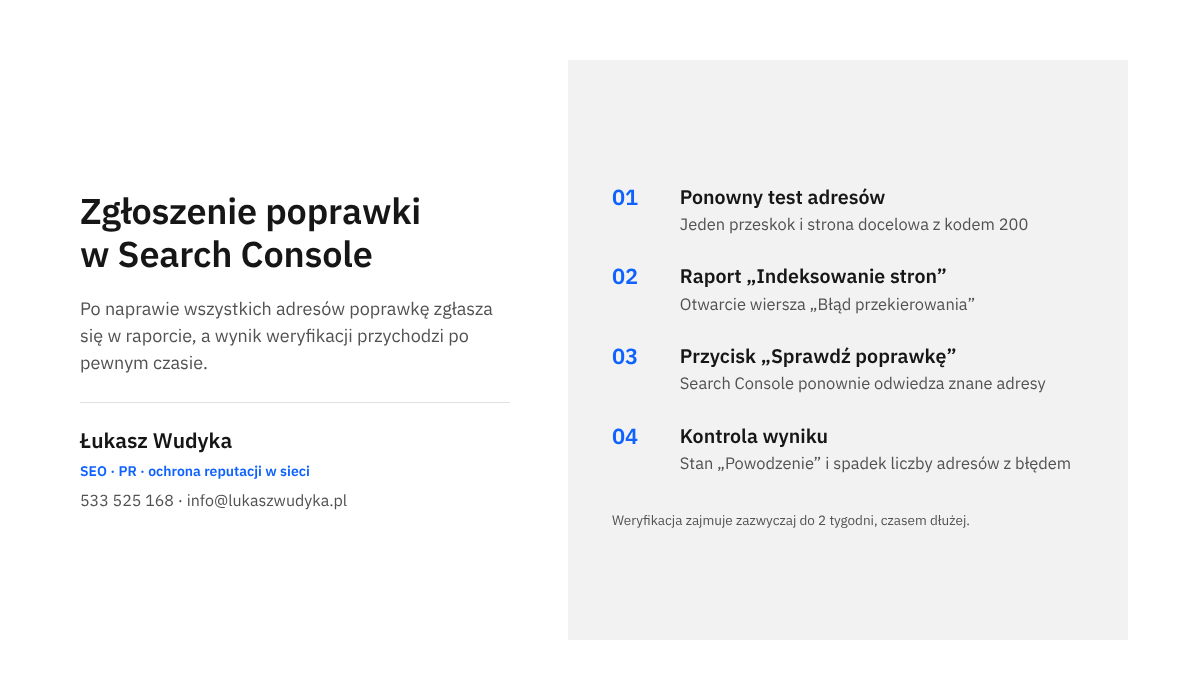
Według dokumentacji weryfikacja zajmuje zazwyczaj do 2 tygodni, a w niektórych przypadkach znacznie dłużej. W tym czasie nie trzeba niczego klikać ponownie. Search Console wysyła wiadomość o wyniku na adres właściciela usługi.
Po czym poznać, że naprawa zadziałała?
Weryfikacja kończy się stanem „Powodzenie”, a liczba adresów w wierszu „Błąd przekierowania” spada. Poprawione stare adresy nie znikają z raportu całkowicie, tylko przenoszą się do wiersza „Strona zawiera przekierowanie”, co jest stanem prawidłowym. Adresy docelowe powinny z czasem pojawić się wśród stron zindeksowanych. Samą obecność strony w wynikach można sprawdzić sposobami, które opisuję w tekście o tym, jak sprawdzić, czy Google zaindeksował stronę.
Wiersz z nazwą problemu może pozostać w tabeli jeszcze długo po naprawie, z liczbą zero. Dokumentacja wyjaśnia, że problem jest usuwany z tabeli dopiero po 90 dniach bez żadnych powtórzeń. Nie jest to sygnał, że coś nadal nie działa.
Co zrobić, gdy weryfikacja zakończyła się niepowodzeniem?
Stan „Niepowodzenie” oznacza, że robot znalazł co najmniej jeden adres, pod którym błąd nadal występuje. Po kliknięciu „Sprawdź szczegóły” widać, które to adresy. Trzeba je sprawdzić podglądem drogi tak samo jak na początku, usunąć przyczynę, a następnie kliknąć „Rozpocznij nową weryfikację”.
Najczęstsze powody niepowodzenia to adresy spoza listy przykładów, które pominięto przy naprawie, pamięć podręczna serwująca starą odpowiedź oraz reguła poprawiona tylko dla jednej postaci adresu, na przykład z ukośnikiem na końcu, ale już nie bez niego.
Jakich błędów unikać przy naprawie przekierowań?
Pierwszy błąd to usuwanie przekierowań zamiast ich poprawiania. Skasowanie reguły usuwa pętlę, ale stary adres zaczyna zwracać błąd 404 i linki, które do niego prowadzą, tracą wartość. Reguła ma zostać i wskazywać właściwy cel.
Drugi błąd to dokładanie nowej reguły na wierzch bez przejrzenia istniejących. Tak właśnie powstają łańcuchy i pętle. Przed dodaniem przekierowania należy sprawdzić, czy adres docelowy sam dokądś nie odsyła i czy w innym miejscu nie ma reguły działającej w przeciwną stronę.
Trzeci błąd to praca bez kopii. Plik .htaccess, lista reguł we wtyczce i ustawienia adresu w systemie powinny mieć zapisaną wersję sprzed zmian. Czwarty to testowanie w zwykłym oknie przeglądarki, która zapamiętuje przekierowania 301 i potrafi pokazywać stary stan długo po poprawce. Test zawsze wykonuje się w oknie incognito albo poleceniem curl.
Piąty błąd to kierowanie wszystkich starych adresów zbiorczo na stronę główną. Robot dochodzi wtedy do celu, więc błąd przekierowania znika, ale Google może uznać takie adresy za pozorne błędy 404, bo treść strony docelowej nie odpowiada temu, co było pod starym adresem. Każdy stary adres powinien prowadzić do swojego najbliższego odpowiednika. Przy większych przebudowach warto wcześniej przygotować pełną listę par adresów, co opisuję w tekście o migracji strony bez utraty pozycji w Google.
Ostatnia rzecz to przekierowania tymczasowe użyte tam, gdzie zmiana jest trwała. Google traktuje kody 301 i 308 jako mocny sygnał, że stroną właściwą jest adres docelowy, a kody 302 i 307 jako sygnał słaby. Przy trwałej zmianie adresu należy stosować przekierowanie 301.
Najczęstsze pytania
Czy „Błąd przekierowania” obniża pozycje całego serwisu?
Komunikat dotyczy konkretnych adresów, a nie serwisu jako całości. Adresy z błędem nie są indeksowane, a strony, do których miały prowadzić, nie korzystają z linków kierujących na stare adresy. Jeżeli błąd obejmuje pojedyncze, dawno nieużywane adresy, skutek jest niewielki. Jeżeli obejmuje stronę główną, kategorie lub ofertę, strata widoczności bywa wyraźna i naprawy nie należy odkładać.
Ile przekierowań z rzędu jest dopuszczalnych?
Dokumentacja Google podaje, że roboty domyślnie śledzą do 10 przeskoków. W praktyce zalecam jeden przeskok, a dwa traktuję jako sytuację do poprawienia przy najbliższej okazji. Każdy dodatkowy przystanek spowalnia wczytywanie strony u odwiedzających i zwiększa ryzyko, że po kolejnej zmianie w serwisie łańcuch przerodzi się w pętlę.
Strona otwiera się normalnie. Dlaczego Google widzi błąd?
Są trzy typowe wyjaśnienia. Raport pokazuje stan z dnia ostatniego skanowania, więc błąd mógł już zostać usunięty. Przeglądarka pamięta wcześniejsze przekierowania i pliki cookie, dzięki czemu omija drogę, na której zatrzymuje się robot. Serwer może też odpowiadać robotowi inaczej niż odwiedzającemu, na przykład z powodu zapory albo reguły zależnej od urządzenia.
Czy trzeba poprawiać adresy, których w serwisie już nie ma?
Jeżeli pod starym adresem była treść, która ma dziś odpowiednik w serwisie, przekierowanie należy naprawić, aby prowadziło prosto do tego odpowiednika. Jeżeli treść usunięto bez następcy, lepiej zdjąć wadliwe przekierowanie i pozwolić, by adres zwracał kod 404 lub 410. To uczciwa informacja dla robota i z czasem taki adres przestanie być odwiedzany.
Jak długo trwa weryfikacja poprawki w Search Console?
Według dokumentacji zazwyczaj do 2 tygodni, a czasem znacznie dłużej, ponieważ robot musi ponownie odwiedzić wszystkie adresy objęte problemem. Postęp widać po kliknięciu „Sprawdź szczegóły” w raporcie. Ponowne klikanie przycisku weryfikacji w trakcie jej trwania niczego nie przyspiesza.
Czy adresy z błędem przekierowania powinny być w mapie witryny?
Nie. Mapa witryny powinna zawierać wyłącznie adresy końcowe, które odpowiadają kodem 200 i mają być indeksowane. Adres, który dokądś odsyła, a tym bardziej taki, który odsyła błędnie, jest w mapie sprzecznym sygnałem. Po naprawie przekierowań mapę należy wygenerować ponownie i sprawdzić, czy nie zostały w niej stare adresy.
Czy wtyczka do przekierowań wystarczy, czy lepiej edytować plik serwera?
Dla większości firmowych serwisów wtyczka jest wygodna i wystarczająca, pod warunkiem że jest jedynym miejscem, w którym ustawia się przekierowania poszczególnych podstron. Reguły ogólne, takie jak wymuszenie https i jednej wersji domeny, lepiej trzymać po stronie serwera. Kłopoty zaczynają się wtedy, gdy te same adresy obsługuje kilka narzędzi jednocześnie i nikt nie pamięta, które z nich decyduje.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zrozumiałe. Szukanie reguły, która odsyła robota w kółko, wymaga cierpliwości i dostępu do kilku paneli naraz, a prowadzenie firmy rzadko zostawia na to wolne popołudnie. Mogę przejść tę drogę od początku do końca: pobrać listę adresów z raportu, odtworzyć drogę każdego z nich, wskazać przyczynę, poprawić reguły w uzgodnionym miejscu z zachowaniem kopii, uporządkować linki wewnętrzne i mapę witryny, a potem zgłosić poprawkę w Search Console i dopilnować wyniku weryfikacji.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Po pierwszym przejrzeniu raportu powiem wprost, co jest do zrobienia i w jakiej kolejności.