Kategoria w sklepie internetowym rzadko mieści się na jednym ekranie. Sto, trzysta albo kilka tysięcy produktów trzeba podzielić na części, więc pod listą pojawiają się numery stron i przycisk „Następna”. Dla klienta to drobiazg. Dla Google to kilkadziesiąt osobnych adresów, z którymi wyszukiwarka musi coś zrobić: przejść po nich, zrozumieć, że tworzą jeden ciąg, i dotrzeć tą drogą do produktów leżących głęboko w ofercie.
Właśnie w tym miejscu sklepy tracą widoczność w sposób, którego nie widać na pierwszy rzut oka. Kolejne strony kategorii bywają wyłączone z indeksu, wskazują stronę pierwszą jako adres kanoniczny, ładują się wyłącznie po kliknięciu przycisku albo mnożą się przez sortowanie i filtry. Skutek jest ten sam: część produktów trafia do Google z opóźnieniem lub wcale, a robot zużywa czas na adresy, które niczego nie wnoszą.
Ta instrukcja jest przeznaczona dla właścicieli sklepów i osób, które same opiekują się swoim serwisem. Po lekturze będzie wiadomo, jak sprawdzić stan stronicowania w kilka minut, jak ustawić adresy, linki i znaczniki zgodnie z dokumentacją Google, co zrobić z sortowaniem i filtrami oraz po czym poznać w Google Search Console, że zmiany przyniosły efekt.
Czym jest stronicowanie kategorii i jak rozumie je Google?
Stronicowanie, w dokumentacji Google nazywane podziałem na strony, polega na pokazaniu długiej listy w porcjach. Pierwsza strona kategorii ma adres podstawowy, na przykład adres-sklepu.pl/buty-damskie/, a kolejne dostają numer: adres-sklepu.pl/buty-damskie/page/2/ albo adres-sklepu.pl/buty-damskie/?page=2. Obie formy są poprawne. Ważne jest tylko to, żeby każda porcja listy miała własny, stały adres.
Google opisuje trzy sposoby pokazywania długich list: klasyczny podział na strony, przycisk wczytujący kolejną porcję produktów oraz przewijanie nieskończone. Z punktu widzenia klienta każdy ma zalety. Z punktu widzenia robota różnica jest zasadnicza, ponieważ robot Google odkrywa nowe adresy przede wszystkim przez zwykłe linki, czyli znaczniki <a href>. Nie klika przycisków i zwykle nie uruchamia skryptów, które wymagają działania użytkownika.
Z tego wynikają trzy zalecenia, na których opiera się cała dalsza część tekstu. Strony kategorii powinny być połączone zwykłymi linkami prowadzącymi do następnych stron. Każda strona powinna mieć unikalny adres i własny adres kanoniczny. Odmiany tej samej listy, które powstają przez sortowanie i filtry, nie powinny trafiać do indeksu.
Warto od razu wyjaśnić jedną rzecz, która budzi najwięcej nieporozumień. Druga i dalsze strony kategorii nie mają zdobywać pozycji na ważne frazy. Ich zadaniem jest doprowadzić robota do produktów. Na frazę „buty damskie” ma się wyświetlać strona pierwsza, a pozostałe pełnią rolę korytarza. Korytarz, który jest zamknięty, odcina wszystko, co leży za nim.
Po czym rozpoznać, że stronicowanie w sklepie jest ustawione błędnie?
Błędy w stronicowaniu nie powodują komunikatu na stronie ani ostrzeżenia w panelu sklepu. Widać je dopiero po skutkach, i to zwykle po kilku tygodniach. Najczęściej spotykam następujące sygnały:
- produkty z dalszych stron kategorii długo nie pojawiają się w Google, mimo że te z pierwszej strony są zindeksowane od dawna,
- w raporcie „Indeksowanie stron” w Google Search Console rośnie liczba adresów ze statusem „Strona wykryta – obecnie niezindeksowana” i są to głównie karty produktów,
- w tym samym raporcie pod pozycją „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” widnieją adresy z numerami stron, takie jak
/page/2/czy/page/3/, - w wynikach wyszukiwania na nazwę kategorii pokazuje się strona trzecia albo piąta zamiast pierwszej,
- Google ma w indeksie setki adresów z dopiskami w rodzaju
?orderby=pricelub?filter_kolor=czarny, - po wyłączeniu obsługi JavaScript w przeglądarce pod listą produktów nie ma żadnych numerów stron ani linku do kolejnej strony.
Żaden z tych sygnałów nie przesądza sprawy samodzielnie. Produkt może nie być zindeksowany z innych powodów, a status w raporcie bywa całkowicie prawidłowy. Dlatego przed jakąkolwiek zmianą trzeba wykonać krótki test i ustalić, która przyczyna rzeczywiście występuje.
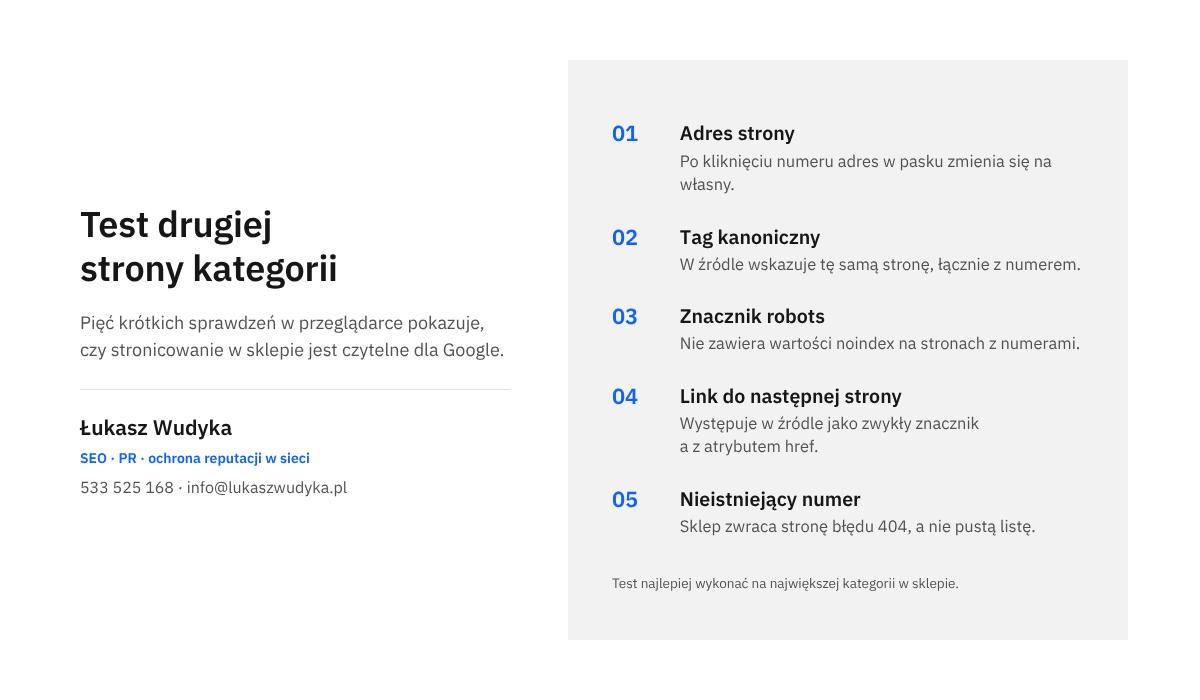
Jak w kilka minut sprawdzić, co naprawdę dzieje się na drugiej stronie kategorii?
Do testu wystarczy przeglądarka. Najlepiej wybrać największą kategorię w sklepie, bo tam błędy mają największe skutki. Kolejność czynności jest następująca:
- Należy otworzyć kategorię i przejść na drugą stronę listy, klikając numer „2” pod produktami. W pasku adresu powinien pojawić się nowy adres z numerem strony. Jeżeli adres się nie zmienia albo zmienia się tylko część po znaku
#, sklep nie nadaje stronom osobnych adresów. - Na drugiej stronie trzeba otworzyć źródło strony skrótem Ctrl+U (w systemie macOS: Cmd+Option+U) i wyszukać skrótem Ctrl+F słowo canonical. Poprawny wynik to adres identyczny z adresem w pasku przeglądarki, łącznie z numerem strony.
- W tym samym źródle wyszukuje się słowo robots. Jeżeli w znaczniku meta widnieje wartość
noindex, druga strona jest wyłączona z indeksu. - Następnie wyszukuje się fragment page/3 albo page=3. Link do trzeciej strony powinien występować w źródle jako zwykły znacznik
<a href>. Brak takiego linku oznacza, że numery stron dokłada dopiero skrypt. - W pasku adresu należy ręcznie wpisać numer strony, która nie istnieje, na przykład 999. Sklep powinien zwrócić stronę błędu 404, a nie pustą listę ani stronę pierwszą.
- Na koniec zmienia się sortowanie listy i sprawdza, czy adres dostał dopisek. Jeżeli tak, w źródle tej odmiany trzeba ponownie odszukać słowa canonical i robots oraz zanotować wynik.
Wyniki dobrze jest spisać w kilku wierszach: adres drugiej strony, adres kanoniczny, zawartość znacznika robots, obecność linku do strony następnej, zachowanie przy nieistniejącym numerze i przy sortowaniu. Ta krótka notatka pokazuje, które z dalszych sekcji dotyczą danego sklepu, a które można pominąć.
Jaki adres kanoniczny powinna mieć druga i każda kolejna strona kategorii?
To najczęstszy błąd, z jakim się spotykam. Ktoś uznał, że strony z numerami są kopiami strony pierwszej, i ustawił na nich adres kanoniczny prowadzący do początku kategorii. Brzmi to rozsądnie, ale jest sprzeczne z zaleceniem Google. Dokumentacja mówi wprost, żeby nie używać pierwszej strony sekwencji jako strony kanonicznej i żeby każdej stronie przypisać własny kanoniczny adres.
Powód jest prosty. Tag kanoniczny oznacza: ta strona jest kopią tamtej, proszę brać pod uwagę tamtą. Tymczasem strona druga nie jest kopią pierwszej, bo zawiera inne produkty. Jeżeli Google posłucha takiego wskazania, przestaje traktować dalsze strony jako odrębne dokumenty, a linki do produktów, które się na nich znajdują, tracą na znaczeniu. Jeżeli nie posłucha, w raporcie pojawia się status „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” i trudno przewidzieć, co się stanie z poszczególnymi adresami.
Poprawne ustawienie dla drugiej strony kategorii wygląda tak:
<link rel="canonical" href="https://adres-sklepu.pl/buty-damskie/page/2/">Dla strony trzeciej adres kończy się na /page/3/ i tak dalej. Strona pierwsza wskazuje adres podstawowy kategorii, bez numeru. Adres kanoniczny powinien być pełny, czyli zaczynać się od https://, i powinien znajdować się w kodzie źródłowym strony, a nie być dopisywany lub zmieniany przez skrypt po załadowaniu.
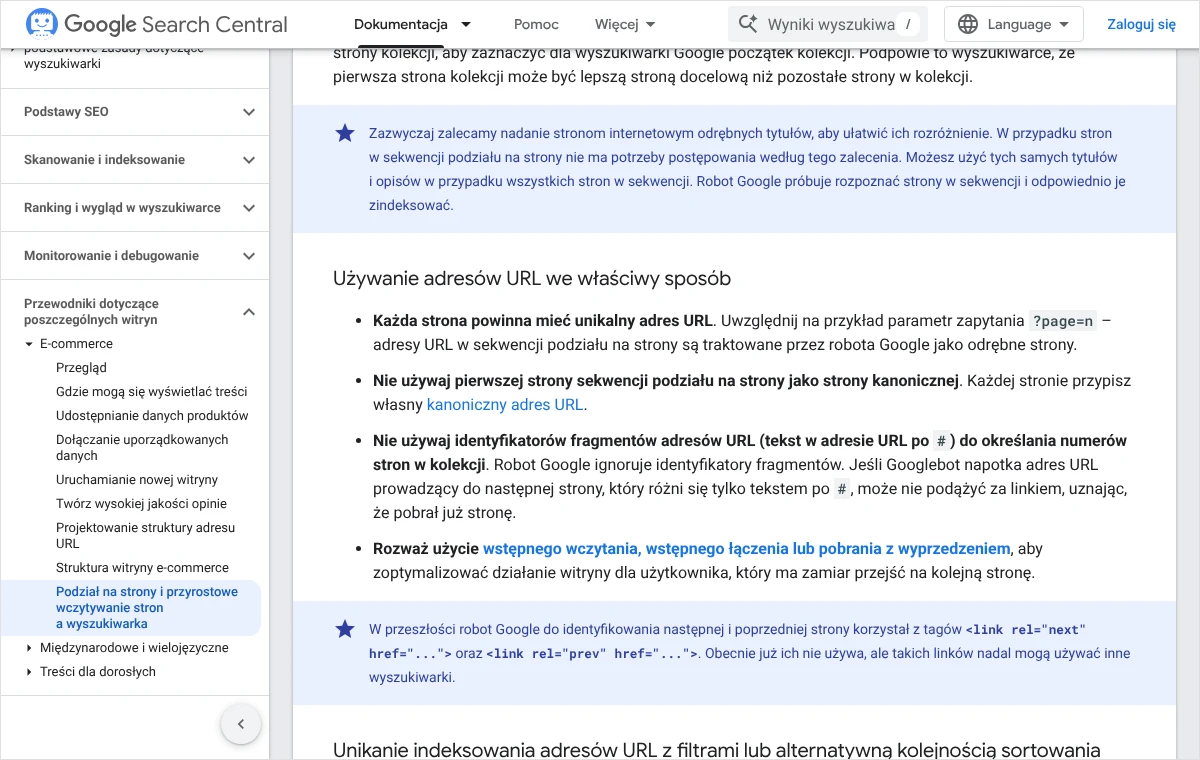
Przy okazji trzeba sprawdzić dwie drobne rzeczy. Po pierwsze, czy strona pierwsza nie jest dostępna pod dwoma adresami, na przykład /buty-damskie/ oraz /buty-damskie/page/1/. Druga forma powinna przekierowywać na pierwszą. Po drugie, czy linki z numerami stron prowadzą dokładnie do tych adresów, które są wskazane jako kanoniczne, z takim samym ukośnikiem na końcu i taką samą wielkością liter. Szerzej opisałem te zasady w tekście o tym, jak wskazać Google właściwą wersję podstrony tagiem kanonicznym.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl, a ja przejmę sprawę: sprawdzę adresy kanoniczne, linki i znaczniki na stronach kategorii, wskażę błędy i dopilnuję ich poprawienia w sklepie.
Jak powinny wyglądać linki między stronami kategorii?
Google zaleca sekwencyjne linkowanie stron: z każdej strony kategorii ma prowadzić zwykły link do strony następnej. Dzięki temu robot przechodzi przez całą kategorię krok po kroku i znajduje wszystkie produkty. Dokumentacja dodaje drugą wskazówkę: ze wszystkich stron ciągu dobrze jest linkować z powrotem do strony pierwszej. To sygnał, gdzie kategoria się zaczyna i która strona jest najlepszym miejscem docelowym dla osoby szukającej.
W praktyce oznacza to, że pod listą produktów powinny znajdować się linki do strony następnej, poprzedniej i pierwszej. W dużych kategoriach radzę pokazywać także kilka numerów sąsiednich oraz numer ostatni. Robot nie musi wtedy pokonywać czterdziestu kroków, żeby dotrzeć do końca listy, a produkty z dalszych stron leżą bliżej strony głównej.
Każdy z tych linków musi być znacznikiem <a> z atrybutem href zawierającym pełny adres strony. Numer strony zbudowany jako przycisk, element reagujący wyłącznie na kliknięcie albo link z adresem w postaci #strona-2 nie spełnia tego warunku. Google ignoruje część adresu po znaku #, więc taki link może zostać uznany za prowadzący do strony już pobranej.
Linki do kolejnych stron nie powinny mieć atrybutu nofollow. Zdarza się, że ktoś dodaje go z myślą o oszczędzaniu zasobów robota, a w efekcie utrudnia mu dojście do produktów. Stronicowanie jest częścią nawigacji sklepu, a ogólne zasady, według których warto ją układać, zebrałem w tekście o tym, jak ułożyć linkowanie wewnętrzne w serwisie.
Co ze znacznikami rel=”next” i rel=”prev”?
Przez lata zalecano umieszczanie w nagłówku strony znaczników wskazujących stronę następną i poprzednią. Google podaje obecnie, że już z nich nie korzysta, zaznacza jednak, że mogą ich używać inne wyszukiwarki. Jeżeli sklep je generuje, nie ma powodu ich usuwać. Jeżeli ich nie ma, nie jest to błąd. W żadnym wypadku nie zastępują one zwykłych linków widocznych na stronie.
Przycisk „Pokaż więcej” i przewijanie nieskończone
Wiele sklepów zastępuje numery stron przyciskiem wczytującym kolejne produkty albo listą, która wydłuża się podczas przewijania. Dla klienta bywa to wygodne, ale robot nie kliknie przycisku i nie przewinie strony tak jak człowiek. Jeżeli za takim rozwiązaniem nie stoją prawdziwe adresy kolejnych stron, Google widzi wyłącznie pierwszą porcję produktów.
Bezpieczne wdrożenie łączy oba podejścia. Przycisk jest zwykłym linkiem do adresu następnej strony, a skrypt jedynie przejmuje kliknięcie i dokleja produkty do listy. Użytkownik widzi wygodne doładowanie, a robot, który skryptu nie uruchomi, trafia na działający adres /page/2/ z kolejną porcją oferty. Każdy z tych adresów, wpisany ręcznie w przeglądarce, musi pokazywać właściwą część listy.
Sprawdzenie jest proste: w źródle pierwszej strony kategorii powinien znajdować się link do strony drugiej, a strona druga otwarta bezpośrednio powinna wyświetlić inne produkty niż pierwsza. Jeżeli jeden z tych warunków nie jest spełniony, poprawka wymaga pracy programisty lub zmiany motywu sklepu.
Czy kolejne strony kategorii powinny mieć znacznik noindex?
Część sklepów oznacza strony od drugiej wzwyż wartością noindex, żeby w wynikach wyszukiwania nie pojawiały się mało wartościowe listy. Dokumentacja Google dotycząca podziału na strony tego nie zaleca. Wartość noindex pojawia się w niej wyłącznie przy odmianach listy powstających przez filtry i sortowanie, a nie przy samych numerach stron.
Uważam, że w typowym sklepie kolejne strony kategorii należy pozostawić dostępne dla indeksu, z własnym adresem kanonicznym. Strona, którą trwale wyłączono z indeksu, jest przez robota odwiedzana coraz rzadziej, więc słabiej spełnia rolę drogi do produktów. Im większa kategoria, tym dotkliwszy skutek.
Obawa, że strona piąta wyprze w wynikach stronę pierwszą, jest w większości przypadków nieuzasadniona. Google próbuje rozpoznać strony w sekwencji i odpowiednio je traktować, a linki prowadzące z każdej strony do początku kategorii dodatkowo wskazują właściwy adres docelowy. Jeżeli mimo to na nazwę kategorii pokazuje się dalsza strona, przyczyną bywa brak tych linków albo to, że opis kategorii jest powielony na wszystkich stronach.
Jeżeli sklep ma obecnie noindex na dalszych stronach, zmianę trzeba wprowadzić świadomie: usunąć znacznik, upewnić się, że adres kanoniczny wskazuje daną stronę, i obserwować raport w Google Search Console. Sposób działania samego znacznika opisałem osobno w tekście o tym, jak metatagiem noindex wyłączyć podstronę z wyników Google.
Co zrobić z sortowaniem i filtrami, które mnożą adresy kategorii?
Stronicowanie rzadko występuje samo. Obok niego działają sortowanie według ceny lub popularności oraz filtry koloru, rozmiaru i producenta. Każda taka opcja dopisuje do adresu parametr, a parametry łączą się ze sobą i z numerami stron. Z jednej kategorii mogą w ten sposób powstać tysiące adresów pokazujących te same produkty w innej kolejności lub w innym wycinku.
Tu zalecenie Google jest odwrotne niż przy numerach stron. Odmiany tej samej listy nie powinny trafiać do indeksu. Dokumentacja wskazuje dwa sposoby: wartość noindex w znaczniku meta robots albo wyłączenie skanowania określonych wzorców adresów w pliku robots.txt. Przy nawigacji z filtrami Google wymienia też tag kanoniczny prowadzący do wersji bez filtrów, zastrzegając, że działa on słabiej niż blokada skanowania.
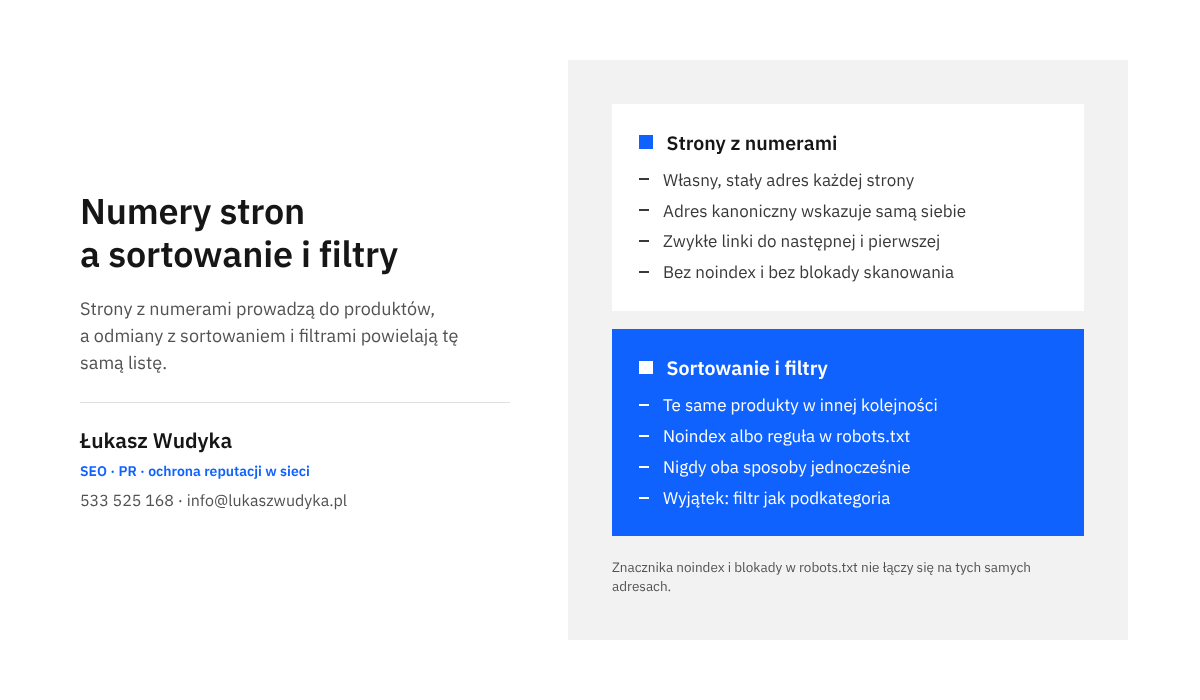
Który sposób wybrać w konkretnym sklepie?
Wybór zależy od tego, czy niepożądane adresy są już w indeksie. Jeżeli Google zdążyło je zindeksować, blokada w robots.txt ich nie usunie, ponieważ robot przestanie je odwiedzać i nie odczyta żadnego znacznika. W takiej sytuacji najpierw stosuje się noindex na odmianach z sortowaniem i filtrami i czeka, aż adresy znikną z indeksu.
Jeżeli odmian w indeksie nie ma, a sklep jest duży i robot traci na nie czas, właściwszym rozwiązaniem jest blokada skanowania. W pliku robots.txt umieszcza się wtedy reguły dla parametrów, których sklep używa. Dla sortowania w WooCommerce wyglądają one następująco:
User-agent: *
Disallow: /*?orderby=
Disallow: /*&orderby=
Analogiczne wiersze tworzy się dla parametrów filtrów. Ich nazwy należy odczytać z paska adresu po użyciu filtra we własnym sklepie, ponieważ zależą od platformy, motywu i wtyczek. Przed zapisaniem pliku trzeba upewnić się, że reguła nie obejmuje adresów ze zwykłym numerem strony. Blokada parametru page albo ścieżki /page/ zamknęłaby robotowi drogę do produktów.
Obu sposobów nie wolno stosować jednocześnie na tych samych adresach. Robot, któremu zabroniono wejścia, nie zobaczy znacznika noindex, więc adres może pozostać w wynikach bez opisu. Mechanizm ten wyjaśniam w tekście o tym, dlaczego noindex i blokada w robots.txt jednocześnie nie działają. Błąd w pliku robots.txt potrafi też ukryć cały sklep, dlatego każdą zmianę radzę wprowadzać po wykonaniu kopii poprzedniej wersji pliku.
Osobną sprawą są filtry, które odpowiadają na realne zapytania klientów, na przykład „buty damskie czarne”. Taką odmianę można świadomie udostępnić wyszukiwarce, ale wtedy powinna mieć stały, czytelny adres, własny tytuł i opis, czyli działać jak zwykła podkategoria. Pozostałe kombinacje nadal powinny być wyłączone.
Jak ustawić stronicowanie w sklepie na WordPressie i WooCommerce?
WooCommerce tworzy dla kolejnych stron kategorii adresy w postaci /page/2/ i wyświetla pod listą zwykłe linki z numerami, więc podstawowe warunki są spełnione od początku. Kłopoty biorą się zwykle z trzech miejsc: z ustawień wtyczki SEO, z motywu, który zastępuje numery stron własnym doładowaniem, oraz z wtyczek filtrujących produkty. Kolejność porządków, którą stosuję, wygląda tak:
- Wykonanie kopii zapasowej sklepu i zapisanie obecnej treści pliku robots.txt. Każdą z dalszych zmian da się wtedy cofnąć.
- Otwarcie ustawień używanej wtyczki SEO i odszukanie opcji dotyczących archiwów oraz stron z numerami. Jeżeli wtyczka ma przełącznik dodający
noindexdo stronicowanych archiwów, należy go wyłączyć. Nazwy i położenie tych opcji różnią się między wtyczkami i wersjami, dlatego wynik zawsze potwierdza się w źródle strony. - Sprawdzenie w źródle drugiej strony kategorii, czy adres kanoniczny wskazuje tę stronę. Jeżeli wskazuje stronę pierwszą, przyczyną bywa dodatkowy fragment kodu w motywie, druga wtyczka SEO działająca równolegle albo ręcznie wpisany adres kanoniczny w ustawieniach danej kategorii. Pole z własnym adresem kanonicznym w edycji kategorii powinno pozostać puste.
- Ustalenie, w jaki sposób motyw pokazuje kolejne produkty. Jeżeli w ustawieniach motywu włączone jest przewijanie nieskończone lub przycisk doładowania, trzeba sprawdzić opisanym wcześniej testem, czy w źródle pozostaje link do następnej strony. Gdy go nie ma, bezpieczniej jest wrócić do klasycznych numerów stron.
- Dobranie liczby produktów na stronie. W wielu motywach klasycznych ustawia się ją w panelu „Wygląd”, w części „Dostosuj”, w sekcji „WooCommerce” i zakładce „Katalog produktów”, gdzie określa się liczbę produktów w wierszu i liczbę wierszy na stronę. W motywach blokowych odpowiada za to ustawienie bloku z listą produktów w edytorze witryny.
- Uporządkowanie odmian z sortowaniem i filtrami według zasad z poprzedniej sekcji:
noindexalbo reguły w robots.txt, nigdy oba naraz. - Wyczyszczenie pamięci podręcznej sklepu i ponowne wykonanie testu w przeglądarce na dwóch lub trzech kategoriach.
W sklepach działających na innych platformach zasady pozostają te same, zmienia się tylko miejsce ustawień. Jeżeli panel nie pozwala wpłynąć na adres kanoniczny lub znacznik robots na stronach z numerami, zgłoszenie do obsługi technicznej platformy powinno zawierać konkretne żądanie, na przykład: Proszę o ustawienie na stronach kategorii z numerem strony adresu kanonicznego wskazującego tę samą stronę oraz o usunięcie z nich wartości noindex.
Jak ułożyć tytuły, opisy i tekst kategorii na kolejnych stronach?
Zazwyczaj każda podstrona powinna mieć odrębny tytuł. Strony w ciągu stronicowania są wyjątkiem: Google podaje, że można na nich użyć tych samych tytułów i opisów, bo robot próbuje rozpoznać sekwencję i odpowiednio ją zindeksować. Powtarzające się tytuły na stronach z numerami nie są więc błędem wymagającym naprawy.
Mimo to radzę dopisywać do tytułu numer strony, na przykład „Buty damskie – strona 2”. Nie jest to wymóg wyszukiwarki, tylko ułatwienie pracy: w raportach Google Search Console i w narzędziach do przeglądu serwisu od razu widać, o którą stronę chodzi. Większość wtyczek SEO pozwala dodać numer strony do szablonu tytułu jedną zmienną.
Inaczej jest z tekstem opisującym kategorię. Jeżeli ten sam długi opis wyświetla się nad lub pod produktami na każdej stronie ciągu, wszystkie strony stają się do siebie bardzo podobne, a strona pierwsza traci przewagę nad pozostałymi. Opis kategorii powinien być widoczny wyłącznie na stronie pierwszej. WooCommerce w standardowym szablonie postępuje właśnie w ten sposób, natomiast część motywów i kreatorów stron zmienia to zachowanie, więc trzeba to sprawdzić na stronie drugiej.
Ostatni element to mapa witryny. Stron z numerami nie trzeba do niej dodawać. Powinny się w niej natomiast znaleźć adresy kategorii i wszystkich produktów, ponieważ Google wprost zaleca rozważenie mapy witryny lub pliku danych Google Merchant Center jako pomocy w odnalezieniu całej oferty. Mapa uzupełnia stronicowanie, ale go nie zastępuje.
Po czym poznać w Google Search Console, że naprawa zadziałała?
Test w przeglądarce pokazuje, co sklep wysyła. Google Search Console pokazuje, co z tego odczytał robot. Pełny obraz dają dopiero oba sprawdzenia, przy czym na zmiany w raportach trzeba poczekać, bo robot wraca na poszczególne adresy w różnym tempie.
- W Google Search Console należy wkleić adres drugiej strony kategorii w pole wyszukiwania u góry ekranu, czyli w narzędzie „Sprawdzanie adresu URL”.
- Następnie trzeba kliknąć „Test wersji opublikowanej”, a po zakończeniu testu „Wyświetl przetestowaną stronę”. W pobranym kodzie wyszukuje się słowa canonical i robots oraz link do następnej strony. To potwierdzenie, że robot widzi to samo co przeglądarka.
- W wynikach dla wersji zindeksowanej, w sekcji „Indeksowanie stron”, odczytuje się pola „Adres kanoniczny określony przez użytkownika” i „Adres kanoniczny wybrany przez Google”. Po poprawnej naprawie oba powinny z czasem wskazywać adres drugiej strony.
- Jeżeli strona była wcześniej wyłączona z indeksu, można kliknąć „Poproś o zindeksowanie”. Wystarczy zrobić to dla kilku najważniejszych kategorii, pozostałe adresy robot odwiedzi sam.
- W raporcie „Indeksowanie stron” należy otworzyć przyczynę, która dotyczyła stronicowania, na przykład „URL zawiera tag „noindex””, i po wprowadzeniu zmian kliknąć „Sprawdź poprawkę”. Według pomocy Google weryfikacja zajmuje zazwyczaj do 2 tygodni, a w niektórych przypadkach znacznie dłużej.
O powodzeniu świadczą trzy zmiany widoczne w kolejnych tygodniach. Adresy z numerami stron przechodzą do grupy stron zindeksowanych albo przestają figurować jako alternatywne wobec strony pierwszej. Maleje liczba kart produktów ze statusem „Strona wykryta – obecnie niezindeksowana”. Z raportu stopniowo znikają adresy z parametrami sortowania i filtrów, a jeżeli zastosowano blokadę skanowania, pojawiają się pod pozycją „URL zablokowany przez plik robots.txt”, co w tym wypadku jest zamierzone.
Co zrobić, gdy mimo poprawek problem nie znika, i jakich błędów unikać?
Jeżeli po kilku tygodniach raport się nie zmienia, w pierwszej kolejności trzeba wrócić do źródła strony i do testu wersji opublikowanej. Często okazuje się, że poprawka działa tylko w części kategorii, że pamięć podręczna nadal podaje starą wersję albo że dwa mechanizmy wysyłają sprzeczne sygnały, na przykład wtyczka ustawia jeden adres kanoniczny, a motyw dopisuje drugi.
Gdy pole „Adres kanoniczny wybrany przez Google” uparcie wskazuje stronę pierwszą, mimo poprawnej deklaracji, warto porównać zawartość stron. Jeżeli różnią się kilkoma produktami, a resztę ekranu zajmuje ten sam opis, baner i lista polecanych pozycji, wyszukiwarka może uznać je za zbyt podobne. Pomaga usunięcie powielonego opisu z dalszych stron i pokazanie na stronie większej liczby produktów.
Gdy produkty z końca dużej kategorii nadal nie są indeksowane, przyczyna leży zwykle poza stronicowaniem. Trzeba sprawdzić, czy są w mapie witryny, czy prowadzą do nich linki z innych miejsc sklepu, na przykład z podkategorii i sekcji produktów powiązanych, oraz czy same karty produktów mają wystarczająco własnej treści. Podział dużej kategorii na węższe podkategorie często daje więcej niż dalsze poprawianie numerów stron.
Na koniec lista pomyłek, które widuję najczęściej i które łatwo popełnić w dobrej wierze:
- ustawienie strony pierwszej jako adresu kanonicznego dla wszystkich stron z numerami,
- zablokowanie w robots.txt ścieżki
/page/lub parametru numeru strony razem z parametrami sortowania, - przekierowanie wszystkich dalszych stron na stronę pierwszą, co odcina klientów i robota od reszty oferty,
- włączenie przewijania nieskończonego bez sprawdzenia, czy pod spodem działają zwykłe adresy stron,
- zgłaszanie stron z numerami do usunięcia w narzędziu „Usunięcia”, które ukrywa adresy tylko czasowo i nie służy do porządkowania duplikatów,
- wprowadzanie kilku zmian jednocześnie we wszystkich kategoriach bez kopii zapasowej i bez testu na jednej z nich.
Najczęstsze pytania
Czy druga strona kategorii to duplikat pierwszej?
Nie. Druga strona pokazuje inne produkty, więc jest osobnym dokumentem, nawet jeśli ma ten sam tytuł i układ. Google zaleca, żeby każda strona w ciągu miała unikalny adres i własny adres kanoniczny. Duplikatami są natomiast odmiany tej samej listy powstające przez zmianę sortowania.
Czy lepiej używać adresu z /page/2/, czy z parametrem ?page=2?
Obie formy są poprawne i Google nie wskazuje, że któraś działa lepiej. Dokumentacja podaje parametr zapytania jako przykład, a WordPress z WooCommerce stosuje domyślnie ścieżkę z numerem. Ważne, żeby sklep używał jednej formy konsekwentnie i żeby linki, adresy kanoniczne oraz przekierowania były z nią zgodne.
Czy trzeba dodać rel=”next” i rel=”prev”, jeśli sklep ich nie ma?
Nie ma takiej potrzeby ze względu na Google, które podaje, że już z tych znaczników nie korzysta. Mogą je odczytywać inne wyszukiwarki, więc ich obecność nie szkodzi. Znacznie ważniejsze są zwykłe linki do następnej strony widoczne w treści strony.
Ile produktów powinno być na jednej stronie kategorii?
Google nie podaje żadnej zalecanej liczby. Większa liczba produktów skraca ciąg stron i ułatwia robotowi dotarcie do końca kategorii, ale wydłuża ładowanie. Właściwą wartość najlepiej dobrać doświadczalnie, sprawdzając szybkość strony kategorii na telefonie po każdej zmianie.
Czy strona „Pokaż wszystkie produkty” rozwiązuje problem?
Tylko w małych kategoriach. Lista kilkuset produktów na jednej stronie ładuje się długo i może powodować błędy, co dokumentacja Google wymienia jako wadę rozwiązań umieszczających całą treść na jednej stronie. W dużym sklepie pewniejsze jest poprawne stronicowanie połączone z podziałem oferty na podkategorie.
Czy strony z numerami powinny być w mapie witryny?
Nie jest to potrzebne. Mapa witryny powinna zawierać adresy, które mają być miejscem docelowym dla osób szukających, czyli kategorie, produkty i ważne strony informacyjne. Strony z numerami robot znajduje przez linki pod listą produktów, a same produkty dodatkowo przez mapę.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Stronicowanie to jeden z tych tematów, w których wiele drobnych ustawień musi do siebie pasować, a skutki pomyłki widać dopiero po czasie. Jeżeli sklep ma dużo kategorii, filtry i kilka wtyczek, które wzajemnie na siebie wpływają, chętnie zajmę się tym od początku do końca. Sprawdzę adresy, linki, adresy kanoniczne i znaczniki na stronach kategorii, uporządkuję sortowanie i filtry, przygotuję zmiany do wdrożenia lub wprowadzę je w sklepie, a potem będę obserwować raporty w Google Search Console, aż wszystko zacznie działać tak, jak powinno.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres sklepu. Odpowiem, co widzę po pierwszym przeglądzie i co moim zdaniem trzeba zrobić w pierwszej kolejności.