W raporcie Search Console pojawia się wiersz „Strona wykryta – obecnie niezindeksowana”, a obok niego liczba adresów, czasem kilka, czasem kilka tysięcy. Właściciel firmy widzi, że nowa oferta, wpis albo karta produktu nie ma szans pojawić się w wynikach, i nie wie, czy to usterka, kara, czy zwykła kolejka. W rozmowach i na forach ten sam stan bywa zapisywany jako „niezaindeksowana”. Chodzi o to samo, a w tym tekście trzymam się brzmienia z polskiej pomocy Google.
Komunikat brzmi groźnie, a mówi tylko jedno: Google wie, że adres istnieje, ale jeszcze go nie odwiedził. Powodów może być kilka i każdy naprawia się inaczej. Jedne leżą po stronie serwera, inne po stronie budowy serwisu, jeszcze inne po stronie samej treści.
Po lekturze tej instrukcji będzie wiadomo, gdzie dokładnie szukać listy takich adresów, czym ten stan różni się od podobnie brzmiącego „Strona zeskanowana, ale jeszcze niezindeksowana”, jak ustalić przyczynę we własnej witrynie, co poprawić, jak poprosić Google o ponowne sprawdzenie i ile realnie trwa oczekiwanie.
Gdzie w Search Console widać ten stan?
Stan pojawia się w raporcie „Indeksowanie stron”. Raport pokazuje wykres oraz liczbę stron zindeksowanych i niezindeksowanych, a niżej tabelę „Dlaczego strony nie są indeksowane”. Każdy wiersz tej tabeli to jedna przyczyna, a jedną z nich jest właśnie „Strona wykryta – obecnie niezindeksowana”.
Dojście do listy adresów wygląda tak:
- Po zalogowaniu do Search Console należy wskazać właściwą usługę, czyli witrynę, której dotyczy sprawa.
- W menu po lewej stronie, w części poświęconej indeksowaniu, otwiera się raport „Indeksowanie stron”.
- Pod wykresem trzeba odszukać tabelę „Dlaczego strony nie są indeksowane” i kolumnę „Przyczyna”.
- Kliknięcie wiersza „Strona wykryta – obecnie niezindeksowana” otwiera stronę z informacjami: wykres pokazujący, jak liczba takich adresów zmieniała się w czasie, oraz listę przykładowych adresów.
- Przy każdym adresie na liście znajduje się ikona inspekcji w kształcie lupy. Jej kliknięcie przenosi do narzędzia do sprawdzania adresów URL z danymi tej jednej strony.
Dwie rzeczy na tym ekranie łatwo przeoczyć. Po pierwsze, lista przykładów obejmuje najwyżej 1000 adresów i pomoc Google zastrzega, że nie musi zawierać wszystkich, nawet jeśli jest ich mniej. Po drugie, w tabeli jest kolumna „Źródło”, która mówi, czy przyczyna leży po stronie witryny, czy po stronie Google. Pomoc stwierdza wprost, że rozwiązywać można tylko problemy, których źródłem jest „Witryna”.
Nad wykresem działa też filtr z opcjami „Wszystkie znane strony”, „Wszystkie przesłane strony” i „Tylko strony nieprzesłane”. Przyda się przy ustalaniu przyczyny, bo pozwala oddzielić adresy podane w mapie witryny od tych, które Google znalazł sam.
Co ten stan oznacza według pomocy Google?
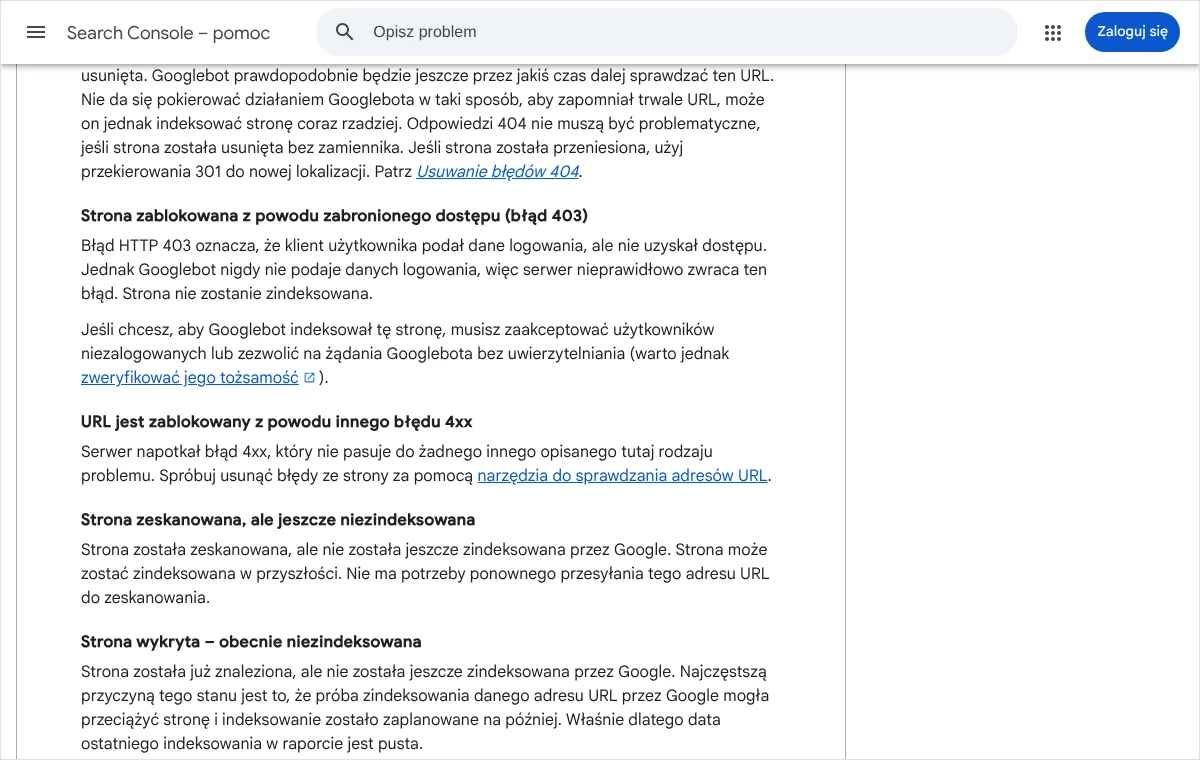
Oficjalny opis jest krótki. Strona została już znaleziona, ale nie została jeszcze zindeksowana przez Google. Najczęstszą przyczyną ma być to, że próba pobrania adresu mogła przeciążyć witrynę, więc Google zaplanował ją na później. Pomoc dodaje, że właśnie dlatego data ostatniego indeksowania w raporcie jest pusta.
Z tego opisu wynikają trzy praktyczne wnioski. Google zna adres, bo znalazł do niego link albo dostał go w mapie witryny. Google nie pobrał jeszcze treści, więc niczego o niej nie wie: ani czy jest dobra, ani czy jest powielona. I wreszcie: to nie jest kara ani błąd w ścisłym sensie, tylko odłożenie wizyty.
Trzeba przy tym rozumieć, jak Google dzieli swoją pracę. Dokumentacja opisuje budżet indeksowania witryny jako zestaw adresów, które Googlebot może i zamierza odwiedzić. Składają się na niego dwa czynniki: limit wydajności, czyli to, ile ruchu serwer zniesie bez szkody, oraz zapotrzebowanie, czyli to, jak bardzo Google chce daną witrynę poznawać. Adres czeka w kolejce, gdy zawodzi jedno albo drugie.
Ta sama dokumentacja wymienia witryny z dużą częścią adresów w stanie „Strona wykryta – obecnie niezindeksowana” jako jedną z grup, dla których zarządzanie budżetem indeksowania ma sens. To ważna wskazówka: pojedyncze adresy w tym stanie są zwyczajne, a duży i rosnący ich udział jest sygnałem, że coś w witrynie wymaga pracy.
Czym różni się strona wykryta od strony zeskanowanej?
Te dwa stany są mylone najczęściej, a różnica decyduje o tym, co naprawiać. W polskiej pomocy Google drugi z nich nazywa się „Strona zeskanowana, ale jeszcze niezindeksowana”, choć w rozmowach często funkcjonuje jako „Strona zeskanowana – obecnie niezaindeksowana”.
Przy stronie wykrytej Googlebot w ogóle nie pobrał adresu. Nie ma daty ostatniego skanowania, nie ma zapisanej wersji strony. Pytanie brzmi: dlaczego Google nie przyszedł? Odpowiedzi szuka się w serwerze, w linkach prowadzących do strony i w ogólnej ocenie witryny.
Przy stronie zeskanowanej Googlebot stronę pobrał i obejrzał, ale nie umieścił jej w indeksie. Pomoc pisze, że może ona zostać zindeksowana w przyszłości i że nie ma potrzeby ponownego przesyłania adresu do zeskanowania. Tu pytanie brzmi inaczej: dlaczego Google, znając treść, jej nie przyjął? Odpowiedzi szuka się przede wszystkim w samej treści.
W praktyce oznacza to inną kolejność działań. Przy stronach wykrytych zaczyna się od dostępności i linków, a treść ocenia się na końcu. Przy stronach zeskanowanych zaczyna się od treści. Poprawianie tekstów na stronach, których Google jeszcze nie widział, nie zaszkodzi, ale samo nie skróci kolejki.
Kiedy ten stan nie wymaga żadnego działania?
Nie każdy adres w witrynie musi trafić do indeksu. Pomoc Google mówi o tym wprost: nie należy oczekiwać zindeksowania wszystkich adresów, wystarczy, że zindeksowane są najważniejsze strony. Zanim zacznie się cokolwiek naprawiać, trzeba więc przejrzeć listę i odpowiedzieć na pytanie, czy są na niej strony, które mają zarabiać lub przyciągać klientów.
Na liście bardzo często znajdują się adresy, które nie mają żadnej wartości w wyszukiwarce: wyniki wewnętrznej wyszukiwarki, kombinacje filtrów i sortowania w sklepie, strony stronicowania komentarzy, adresy z dopisanymi parametrami, kanały RSS, strony załączników. Jeśli lista składa się głównie z nich, stan jest korzystny. Google rozsądnie uznał, że nie musi się tam spieszyć.
Działania nie wymaga też sytuacja, w której strona została opublikowana kilka dni wcześniej. Pomoc podaje, że rozpoczęcie skanowania i indeksowania nowej strony lub witryny może potrwać około tygodnia. Powód do pracy pojawia się wtedy, gdy na liście są ważne strony, gdy czekają one dłużej niż kilka tygodni albo gdy liczba adresów w tym stanie systematycznie rośnie.
Jakie są możliwe przyczyny?
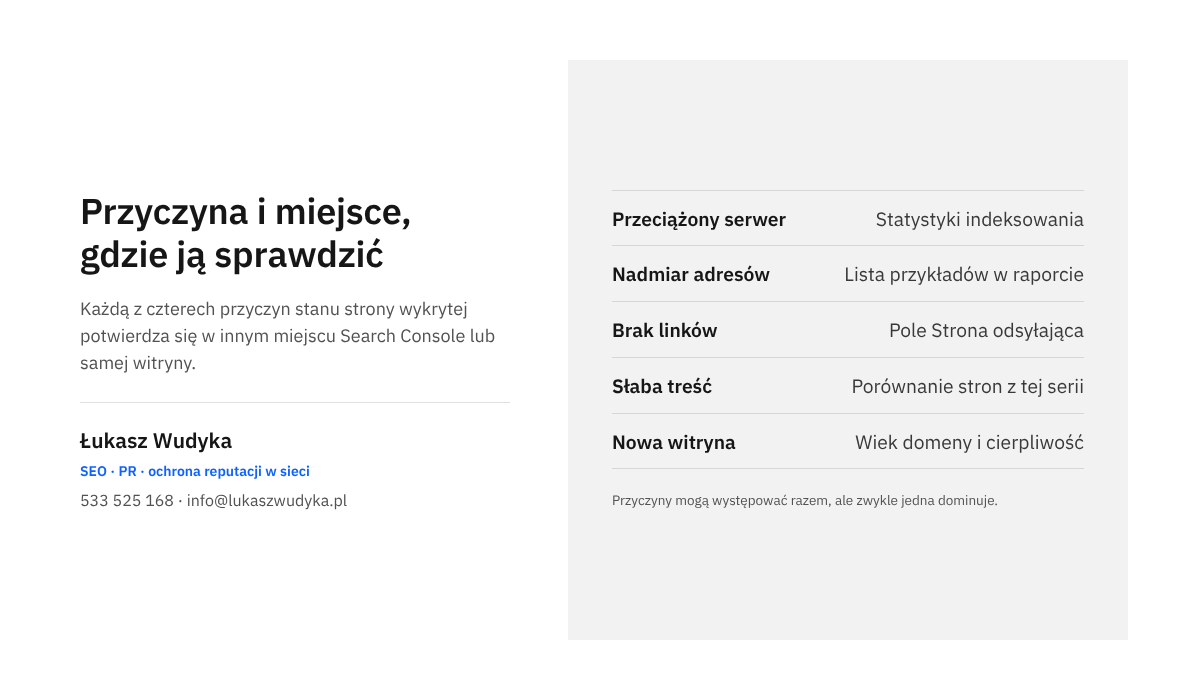
Przyczyn jest w praktyce cztery. Mogą występować razem, ale zwykle jedna dominuje i od niej trzeba zacząć.
Obciążenie serwera i budżet skanowania
To przyczyna, którą pomoc Google wymienia jako najczęstszą. Googlebot stara się nie szkodzić witrynie. Gdy czas odpowiedzi serwera rośnie, pojawiają się błędy z grupy 5xx albo odpowiedź 429, limit wydajności jest obniżany i Google odwiedza mniej adresów. Reszta czeka.
Dotyczy to najczęściej tanich kont hostingowych dzielonych z wieloma innymi witrynami, sklepów z ciężkimi wtyczkami i serwisów, w których każde wejście uruchamia wolne zapytania do bazy danych. Do tej samej grupy należy marnowanie budżetu: jeśli witryna wystawia tysiące zbędnych adresów, Google poświęca czas na nie, a nie na strony ważne.
Słabe linkowanie wewnętrzne
Google musi mieć możliwość znalezienia strony. Według pomocy oznacza to, że link musi prowadzić ze znanej strony lub z mapy witryny. Sama obecność w mapie pozwala adres wykryć, ale nie mówi nic o jego ważności. Strona, do której nie prowadzi żaden link z menu, z kategorii ani z treści innych stron, jest dla robota adresem bez kontekstu.
W mojej praktyce to najczęstsza przyczyna w małych i średnich serwisach firmowych. Nowa podstrona zostaje dodana w systemie, trafia do mapy witryny i nikt nie umieszcza do niej linku. Podobnie dzieje się z wpisami, które po kilku tygodniach spadają na dalekie strony archiwum.
Niska jakość lub powielenie treści w witrynie
Przy stronie wykrytej Google nie zna jeszcze jej treści, więc nie może jej ocenić. Zna natomiast pozostałe strony witryny. Dokumentacja podaje, że zapotrzebowanie na indeksowanie zależy między innymi od jakości stron i od niepowtarzalności treści. Jeśli dotychczas zindeksowane podstrony były krótkie, niemal identyczne albo skopiowane od producenta, chęć Google do pobierania kolejnych podobnych adresów maleje.
Widać to zwłaszcza w seriach stron budowanych z jednego wzorca: oferta dla kolejnych miast różniąca się tylko nazwą miejscowości, setki kart produktów z tym samym opisem, strony tagów zawierające po jednym wpisie.
Nowa witryna
Nowa domena nie ma historii, linków z innych serwisów ani ustalonego tempa odwiedzin. Każda witryna zaczyna od tego samego, ostrożnego limitu wydajności, który Google zwiększa z czasem, jeśli serwer odpowiada sprawnie, a zapotrzebowanie rośnie. W pierwszych tygodniach duża liczba stron wykrytych jest więc zjawiskiem zwyczajnym i zwykle ustępuje sama.
Kto na tym etapie woli nie zajmować się tym samodzielnie, może po prostu zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl. Chętnie przejmę sprawę: ustalę, dlaczego Google nie indeksuje podstron, i usunę przyczynę.
Jak ustalić, która przyczyna zachodzi we własnej witrynie?
Zgadywanie kosztuje tygodnie, bo po każdej zmianie trzeba czekać na reakcję Google. Lepiej poświęcić godzinę na cztery sprawdzenia w kolejności podanej niżej. Każde z nich wyklucza albo potwierdza jedną przyczynę.
- Przejrzenie listy przykładowych adresów w raporcie „Indeksowanie stron” i podzielenie ich na ważne oraz zbędne. Jeśli przeważają adresy z parametrami, filtrami i wyszukiwarką, głównym problemem jest nadmiar adresów.
- Ustawienie filtra nad wykresem na „Wszystkie przesłane strony”, a potem na „Tylko strony nieprzesłane”. Jeśli w stanie wykrytym są strony z mapy witryny, sprawa dotyczy stron, na których właścicielowi zależy. Jeśli tylko strony spoza mapy, Google znajduje w serwisie adresy, których nikt nie planował.
- Otwarcie raportu „Statystyki indeksowania” i ocena pracy serwera.
- Sprawdzenie kilku ważnych adresów w narzędziu do sprawdzania adresów URL i odczytanie, skąd Google je zna.
- Ocena treści stron już zindeksowanych z tej samej części serwisu.
Co odczytać z raportu „Statystyki indeksowania”?
Raport otwiera się przez „Ustawienia usługi”, a następnie „Statystyki indeksowania”. Jest dostępny tylko dla usług najwyższego poziomu, czyli dla usługi domeny albo usługi z prefiksem URL obejmującej całą witrynę. Google zaznacza, że to raport dla zaawansowanych i że przy witrynach mających mniej niż 1000 stron zwykle nie trzeba z niego korzystać. Do tego jednego sprawdzenia nadaje się jednak dobrze.
Najpierw należy spojrzeć na „Stan hosta”. Stan zielony oznacza, że w ciągu ostatnich 90 dni Googlebot nie napotkał poważnych problemów z dostępnością. Jeśli stan jest inny, kliknięcie pokazuje trzy kategorie: „Pobieranie pliku robots.txt”, „Rozpoznawanie nazw DNS” i „Połączenie z serwerem”. Każda ma własny wykres z czerwoną przerywaną linią, której przekroczenie oznacza problem.
Drugim miejscem jest wykres „Średni czas odpowiedzi” zestawiony z wykresem „Łączna liczba żądań robota indeksującego”. Jeśli czas odpowiedzi rośnie, a liczba żądań w tych samych dniach spada, serwer hamuje Googlebota. Trzecim jest tabela odpowiedzi: duży udział błędów serwera potwierdza tę samą diagnozę. W tabeli „Cel indeksowania” wartość „Wykrycie” pokazuje, jaką część pracy Google przeznacza na adresy wcześniej nieodwiedzane.
Co odczytać z narzędzia do sprawdzania adresów URL?
Adres ważnej strony wkleja się w pasku na górze Search Console albo wybiera ikonę inspekcji na liście przykładów. Przy stronie wykrytej narzędzie pokaże stan „Adres URL nie znajduje się w Google”. Po rozwinięciu sekcji „Indeksowanie stron” w części „Wykrywalność” widać dwa pola: „Mapy witryn” oraz „Strona odsyłająca”.
Jeśli w polu „Mapy witryn” jest mapa, a strona odsyłająca nie została podana, Google najpewniej zna adres wyłącznie z mapy. To mocna poszlaka wskazująca na brak linków wewnętrznych. Pomoc zastrzega jednak, że brak tej wartości nie dowodzi, że strona odsyłająca nie istnieje, dlatego wynik trzeba potwierdzić ręcznie: odszukać w serwisie miejsca, z których prowadzi link do tej podstrony, i policzyć, ile kliknięć dzieli ją od strony głównej.
W tym samym narzędziu należy kliknąć „Sprawdź URL wersji opublikowanej”. Test pokazuje, czy Google może teraz pobrać stronę. Jeśli pojawi się komunikat „Przekroczono limit obciążenia hosta”, przyczyną jest serwer. Jeśli test wskaże blokadę w pliku robots.txt albo błąd, trzeba najpierw usunąć tę przeszkodę.
Jak ocenić treść, skoro Google jej nie widział?
Ocenia się sąsiadów. Jeżeli w stanie wykrytym utknęło czterdzieści stron ofert dla miast, należy otworzyć te strony z tej samej serii, które są zindeksowane, i porównać je ze sobą. Gdy różnią się tylko nazwą miejscowości, przyczyna jest jasna. Pomocne jest też sprawdzenie w raporcie „Indeksowanie stron”, czy rośnie liczba adresów w stanie „Strona zeskanowana, ale jeszcze niezindeksowana” oraz w wierszach dotyczących duplikatów. Rosną razem zwykle wtedy, gdy problemem jest jakość.
Jak naprawić problem krok po kroku?
Kolejność ma znaczenie. Najpierw usuwa się przeszkody techniczne, potem porządkuje adresy, następnie poprawia linki, a na końcu treść. Odwrotna kolejność oznacza pracę nad tekstami, których Google i tak nie pobierze.
Gdy zawodzi serwer
Dane z raportu „Statystyki indeksowania” trzeba przekazać firmie hostingowej albo administratorowi razem z dniami, w których pojawiły się błędy. Zgłoszenie może brzmieć tak: „W raporcie Statystyki indeksowania w Search Console widzę błędy połączenia z serwerem i wzrost średniego czasu odpowiedzi w dniach [daty]. Proszę o sprawdzenie obciążenia konta i logów serwera z tych dni oraz o informację, czy żądania Googlebota były ograniczane.”
Po stronie witryny pomagają: sprawna pamięć podręczna stron, usunięcie zbędnych wtyczek, uporządkowanie bazy danych i przejście na wydajniejszy pakiet, jeśli obecny jest stale na granicy zasobów. W WordPressie przydatne jest ustalenie, co dokładnie spowalnia WordPressa, zanim zapadnie decyzja o zmianie hostingu. Dokumentacja Google wymienia dodanie zasobów serwera jako jeden z dwóch sposobów zwiększenia budżetu indeksowania.
Trzeba też sprawdzić, czy zapora sieciowa albo usługa ochrony przed botami nie ogranicza Googlebota. Zbyt ostre reguły potrafią odpowiadać robotowi kodem 429 lub 403, a właściciel widzi w przeglądarce sprawnie działającą stronę.
Gdy witryna wystawia za dużo zbędnych adresów
Dokumentacja Google nazywa to zarządzaniem zasobami adresów i podaje, że jest to czynnik, na który właściciel ma największy wpływ. Naprawa składa się z kilku czynności:
- Połączenie stron powielonych: jedna wersja treści pod jednym adresem, pozostałe przekierowane albo oznaczone adresem kanonicznym.
- Zablokowanie w pliku robots.txt adresów, które w ogóle nie powinny być skanowane, na przykład wyników wewnętrznej wyszukiwarki i kombinacji filtrów.
- Ustawienie odpowiedzi 404 lub 410 dla stron trwale usuniętych, zamiast pustych stron zwracających poprawną odpowiedź.
- Skrócenie łańcuchów przekierowań do jednego kroku.
- Oczyszczenie mapy witryny, tak aby zawierała wyłącznie adresy, które mają być w wynikach, oraz uzupełnienie w niej znacznika
<lastmod>przy stronach aktualizowanych.
Przykładowa reguła blokująca wyniki wyszukiwarki w WordPressie wygląda tak:
User-agent: *
Disallow: /?s=
Disallow: /search/
Przed zapisaniem pliku trzeba się upewnić, że reguła nie obejmuje ważnych podstron. Błąd w robots.txt potrafi odciąć od Google cały katalog, dlatego po zmianie należy sprawdzić kilka ważnych adresów testem „Sprawdź URL wersji opublikowanej”. Jeśli w serwisie nie ma osoby, która rozumie składnię tego pliku, bezpieczniej zlecić zmianę niż eksperymentować.
Gdy do strony nie prowadzą linki
Każda ważna podstrona powinna mieć co najmniej kilka linków z innych stron serwisu, w tym jeden z miejsca wysoko w strukturze: z menu, ze strony kategorii albo ze strony głównej. Link ma być zwykłym odnośnikiem w kodzie strony, widocznym bez klikania i bez logowania, z tekstem mówiącym, co jest pod adresem.
Najszybciej działa dopisanie linków w treści stron, które Google już zna i odwiedza często: w popularnych wpisach, w opisach kategorii, na stronie usług. Pomaga też blok powiązanych treści pod wpisami i okruszki nawigacyjne. Zasady układania takich połączeń opisałem osobno w tekście o tym, jak ułożyć linki w serwisie.
Po dodaniu linków trzeba się upewnić, że adres jest w mapie witryny, a mapa została przesłana. W raporcie „Mapy witryn” adres mapy wkleja się w polu „Dodaj nową mapę witryny” i klika „Prześlij”. Stan mapy powinien brzmieć „Sukces”.
Gdy treści w witrynie są słabe lub powielone
Tu nie ma skrótu. Strony z jednej serii muszą się od siebie realnie różnić: innymi informacjami, przykładami, zdjęciami, odpowiedziami na pytania właściwe dla danego miasta, produktu czy usługi. Jeśli nie da się napisać czegoś osobnego dla każdej z pięćdziesięciu podstron, lepiej mieć ich dziesięć porządnych.
Strony, które nie wnoszą nic własnego, należy połączyć z silniejszymi i przekierować albo usunąć. Dotyczy to pustych tagów, archiwów autorów w jednoosobowych blogach i kart produktów wycofanych z oferty. Gdy kilka podstron walczy o to samo zapytanie, pomocny będzie tekst o tym, czym jest kanibalizacja słów kluczowych i jak ją rozwiązać.
Dokumentacja wskazuje, że Google przydziela zasoby, biorąc pod uwagę między innymi popularność, ogólną wartość dla użytkowników, niepowtarzalność treści i wydajność serwera. Poprawa jakości tego, co już jest w indeksie, wpływa więc także na strony czekające w kolejce.
Gdy witryna jest nowa
W nowej witrynie pomoc Google zaleca zacząć od prośby o zindeksowanie strony głównej, bo od niej robot powinien dotrzeć do pozostałych stron, o ile nawigacja jest kompletna. Do tego należy przesłać mapę witryny, zadbać o linki z menu do wszystkich ważnych podstron i zdobyć pierwsze uczciwe odnośniki z zewnątrz: z profilu firmy w Google, z katalogu branżowego, od partnerów handlowych. Potem trzeba po prostu odczekać.
Jak poprosić o zindeksowanie i zgłosić poprawkę do sprawdzenia?
Search Console daje dwa różne mechanizmy. Prośba o zindeksowanie dotyczy jednego adresu. Weryfikacja poprawki dotyczy całej grupy adresów z danego wiersza raportu. Oba mają sens dopiero po usunięciu przyczyny.
Prośba o zindeksowanie pojedynczej strony
- W pasku wyszukiwania u góry ekranu Search Console wkleja się pełny adres strony i zatwierdza klawiszem Enter.
- Po wyświetleniu wyniku należy kliknąć „Sprawdź URL wersji opublikowanej” i poczekać na zakończenie testu.
- Jeśli test nie wykazał błędów, klika się „Poproś o zindeksowanie”. Po krótkim sprawdzeniu strona trafia do kolejki.
- Po kilku dniach ten sam adres sprawdza się ponownie w narzędziu, żeby zobaczyć, czy zmienił się stan i czy pojawiła się data w polu „Ostatnie skanowanie”.
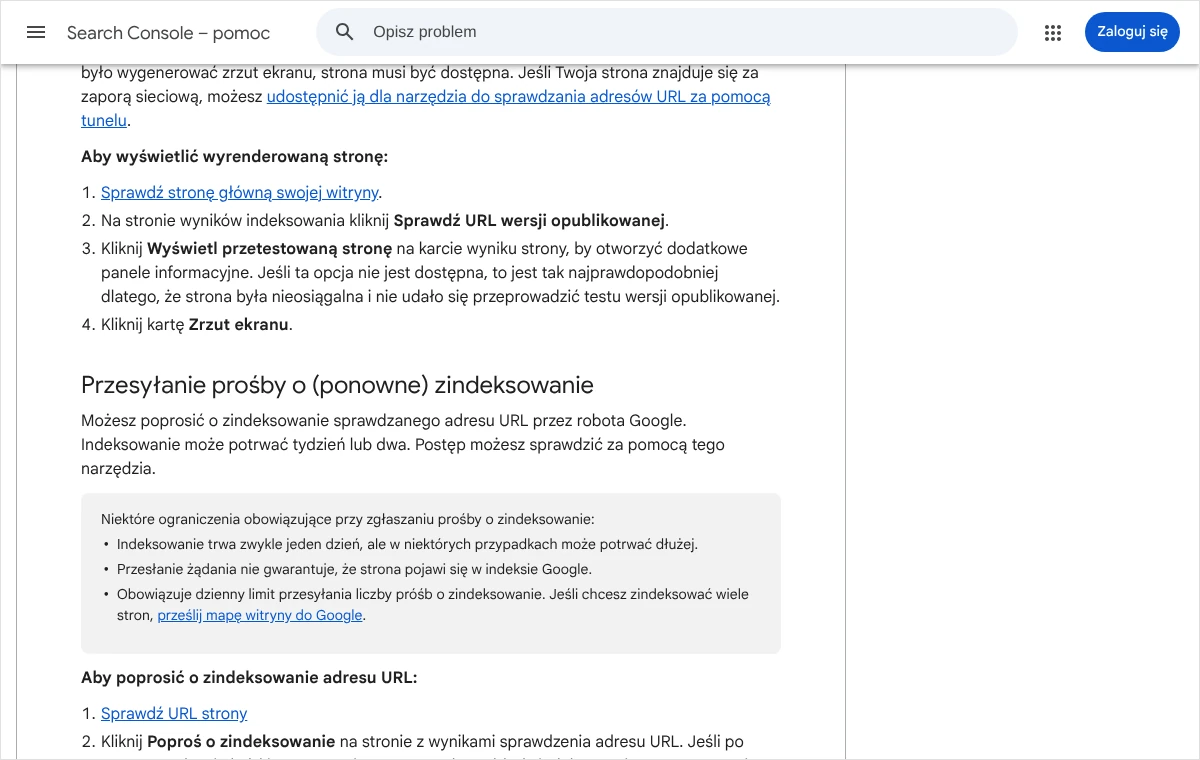
Pomoc Google podaje trzy ograniczenia. Indeksowanie trwa zwykle jeden dzień, ale może potrwać dłużej, nawet tydzień lub dwa. Przesłanie prośby nie gwarantuje, że strona pojawi się w indeksie. Obowiązuje dzienny limit próśb, a przy wielu stronach Google zaleca przesłanie mapy witryny zamiast klikania adres po adresie. Jeśli test wersji opublikowanej uzna stronę za niemożliwą do zindeksowania, prośby nie da się wysłać.
Narzędzie warto więc zarezerwować dla kilku najważniejszych podstron. Liczby dziennego limitu Google nie podaje w pomocy, dlatego nie należy opierać na nim planu naprawy większego serwisu.
Weryfikacja poprawki dla całej grupy adresów
Na stronie z informacjami o stanie „Strona wykryta – obecnie niezindeksowana” znajduje się przycisk „Sprawdź poprawkę”. Po jego kliknięciu Search Console od razu sprawdza kilka stron. Jeśli problem na nich nie występuje, weryfikacja przechodzi w stan „Rozpoczęto” i Google stopniowo odwiedza znane adresy z tej grupy.
Pomoc podaje, że weryfikacja zajmuje zazwyczaj do 2 tygodni, a w niektórych przypadkach znacznie dłużej. O wyniku przychodzi wiadomość e-mail. Przycisku nie należy klikać ponownie, dopóki weryfikacja nie zakończy się stanem „Powodzenie” albo „Niepowodzenie”. Przy niepowodzeniu przycisk „Sprawdź szczegóły” pokazuje, który adres zawiódł.
Jest też sposób na przyspieszenie, opisany w pomocy: utworzenie osobnej mapy witryny zawierającej tylko najważniejsze strony, przesłanie jej, przefiltrowanie raportu według tej mapy i dopiero wtedy kliknięcie „Sprawdź poprawkę”. Weryfikacja obejmie wtedy tylko adresy z tej mapy. Trzeba o tym filtrze pamiętać, bo ustawiony przypadkowo zawęzi sprawdzenie wbrew zamiarowi.
Weryfikacja nie jest obowiązkowa. Google aktualizuje liczby w raporcie przy każdej zwykłej wizycie, niezależnie od tego, czy ktoś kliknął przycisk.
Ile trzeba czekać i po czym poznać, że naprawa zadziałała?
Uczciwa odpowiedź brzmi: od kilku dni do kilku tygodni, a w dużych serwisach dłużej. Dokumentacja podaje tylko te terminy, które przytoczyłem wyżej: około tygodnia na rozpoczęcie skanowania nowej strony, tydzień lub dwa po prośbie o zindeksowanie i zazwyczaj do dwóch tygodni na weryfikację poprawki. Żaden z nich nie jest gwarancją.
Postęp widać w czterech miejscach. Na wykresie strony z informacjami o stanie liczba adresów zaczyna spadać. W narzędziu do sprawdzania adresów URL przy naprawianych stronach pojawia się data ostatniego skanowania. W raporcie „Statystyki indeksowania” rośnie liczba żądań, a czas odpowiedzi jest stabilny. Na głównym wykresie raportu „Indeksowanie stron” przybywa stron zindeksowanych.
Częsty etap pośredni to przejście adresów ze stanu wykrytego do stanu „Strona zeskanowana, ale jeszcze niezindeksowana”. To postęp, nie porażka: Google przyszedł i stronę obejrzał. Jeśli jednak adresy zatrzymują się tam na dłużej, problemem jest treść i to nad nią trzeba pracować dalej. Sposoby samodzielnego sprawdzania obecności strony w indeksie zebrałem w tekście o tym, jak sprawdzić, czy strona jest zaindeksowana w Google.
Co zrobić, gdy po kilku tygodniach nic się nie zmienia?
Należy wrócić do diagnozy i sprawdzić, czy poprawka rzeczywiście działa. Najczęstsze powody braku efektu to: linki dodane w elemencie, którego Google nie odczytuje jako odnośnika, mapa witryny ze stanem innym niż „Sukces”, zapora nadal ograniczająca robota albo poprawienie jednej przyczyny przy pozostawieniu drugiej. Jeśli technicznie wszystko jest w porządku, pozostaje wniosek najmniej wygodny: Google nie uznaje tych stron za warte pośpiechu i trzeba podnieść jakość całej sekcji.
Czego nie robić?
Część popularnych sposobów nie pomaga, a część szkodzi. Poniższych działań radzę unikać.
- Wielokrotne wysyłanie prośby o zindeksowanie tego samego adresu. Zużywa dzienny limit, a przyczyny nie usuwa.
- Klikanie „Sprawdź poprawkę” przed wprowadzeniem zmian albo w trakcie trwającej weryfikacji. Pomoc Google wprost przed tym ostrzega.
- Używanie znacznika noindex do oszczędzania budżetu. Dokumentacja wyjaśnia, że Google i tak musi wtedy pobrać stronę, żeby znacznik zobaczyć, więc czas zostaje zużyty.
- Czasowe blokowanie części serwisu w robots.txt po to, by Google zajął się inną częścią. Według dokumentacji Google nie przeniesie zwolnionego budżetu na inne strony, chyba że witryna osiągnęła już limit wydajności.
- Korzystanie z płatnych usług obiecujących natychmiastowe indeksowanie oraz z interfejsu Indexing API dla zwykłych stron. Według dokumentacji Google tego interfejsu można używać tylko dla stron z ofertami pracy i transmisjami wideo na żywo.
- Masowe dopisywanie nowych podstron w nadziei, że któraś się przyjmie. Większa liczba słabych adresów wydłuża kolejkę dla wszystkich.
- Zmienianie adresów stron tylko po to, by Google potraktował je jak nowe. Traci się historię adresu i dokłada robotowi pracy przy przekierowaniach.
Odradzam też usuwanie i ponowne przesyłanie mapy witryny co kilka dni. Google odczytuje mapę regularnie, a ponowne przesłanie ma sens po dużych zmianach w jej zawartości.
Najczęstsze pytania
Czy ten stan oznacza karę od Google?
Nie. To informacja o kolejności pracy robota, a nie o naruszeniu zasad. Kary, czyli ręczne działania, mają w Search Console osobny raport i osobne powiadomienia. Stan strony wykrytej mówi tylko tyle, że adres jest znany i czeka na pierwszą wizytę.
Czy strona w tym stanie może pojawić się w wynikach wyszukiwania?
Nie może. Narzędzie do sprawdzania adresów URL pokazuje przy niej „Adres URL nie znajduje się w Google”, a pomoc wyjaśnia, że taki adres nie może pojawiać się w wynikach. Dopóki Google nie pobierze strony i nie doda jej do indeksu, nie przyniesie ona ruchu z wyszukiwarki.
Czy mała witryna firmowa może mieć problem z budżetem skanowania?
Rzadko w sensie, w jakim opisuje go dokumentacja dla dużych serwisów. Google pisze, że mniejszym witrynom wystarcza aktualna mapa witryny i regularne przeglądanie raportu „Indeksowanie stron”. W małych serwisach strony wykryte wynikają zwykle z braku linków, słabej treści, młodego wieku domeny albo z kłopotów z hostingiem.
Czy wystarczy dodać stronę do mapy witryny?
Mapa pomaga Google poznać adres, ale nie zastępuje linków. Pomoc zaznacza, że niektóre adresy z mapy mogą nie zostać zindeksowane, zależnie od rozmiaru witryny, aktywności, ruchu i innych czynników. Strona powinna być jednocześnie w mapie i w strukturze linków serwisu.
Dlaczego liczba stron wykrytych rośnie, choć nic nie było publikowane?
Najczęściej dlatego, że serwis sam tworzy nowe adresy: przez filtry, sortowanie, parametry w linkach, kalendarze albo wyszukiwarkę wewnętrzną. Google znajduje je, podążając za linkami. Rozwiązaniem jest uporządkowanie adresów opisane w części o naprawie, a nie proszenie o ich zindeksowanie.
Czy udostępnienie linku w mediach społecznościowych przyspieszy indeksowanie?
Dokumentacja Google nie podaje tego jako sposobu na indeksowanie i nie radzę na tym polegać. Oficjalnie opisane drogi to linki ze znanych stron, mapa witryny i prośba w narzędziu do sprawdzania adresów URL. Udostępnienie ma sens z innych powodów, bo może przyprowadzić czytelników.
Czy trzeba naprawiać wszystkie adresy z listy?
Nie. Pomoc Google przypomina, że niezindeksowane adresy mogą być prawidłowe i że decyzję o naprawie należy podejmować rozsądnie. Pracę wkłada się w strony, które mają znaczenie dla firmy. Resztę porządkuje się tak, żeby nie zabierała robotowi czasu.
Jak często zaglądać do raportu po wprowadzeniu zmian?
Raz w tygodniu w zupełności wystarczy. Dane w raporcie nie odświeżają się natychmiast, a codzienne sprawdzanie skłania do pochopnych, kolejnych zmian. Lepiej zapisać liczbę adresów w dniu poprawki i porównywać ją co tydzień przez co najmniej miesiąc.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zupełnie zrozumiałe. Opisane czynności wymagają spokoju i kilku wolnych godzin, a w firmie zwykle brakuje jednego i drugiego. Chętnie zrobię to od początku do końca: ustalę, dlaczego Google nie indeksuje podstron, i usunę przyczynę.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i w kilku zdaniach opisać sprawę. Odpowiadam osobiście i od razu mówię, co da się zrobić.