W raporcie Google Search Console pojawia się wiersz „Strona zeskanowana, ale jeszcze niezindeksowana”, a obok niego liczba adresów, czasem bardzo duża. Właściciel firmy widzi, że robot Google odwiedził jego podstrony, a mimo to nie ma ich w wynikach wyszukiwania. Trudno wtedy ocenić, czy to chwilowa zwłoka, czy sygnał, że ze stroną jest coś nie tak.
Ten tekst jest instrukcją dla osób, które prowadzą firmową stronę albo sklep i same zaglądają do Search Console. Nie wymaga wiedzy programistycznej, wystarczy dostęp do usługi i do panelu strony.
Po lekturze czytelnik będzie umiał znaleźć listę adresów z tym stanem, oddzielić adresy nieistotne od ważnych, ustalić przyczynę przy każdej ważnej podstronie, wprowadzić poprawkę i sprawdzić, czy przyniosła skutek. Opisuję także, co robić, gdy mimo poprawek strona nadal pozostaje poza indeksem.
Co dokładnie oznacza stan „Strona zeskanowana, ale jeszcze niezindeksowana”?
Żeby strona mogła wyświetlić się w wynikach wyszukiwania, Google musi wykonać trzy czynności. Najpierw dowiaduje się, że adres istnieje. Potem robot pobiera stronę, czyli ją skanuje. Na końcu system ocenia pobraną treść i decyduje, czy zapisać ją w indeksie, czyli w bazie, z której powstają wyniki wyszukiwania.
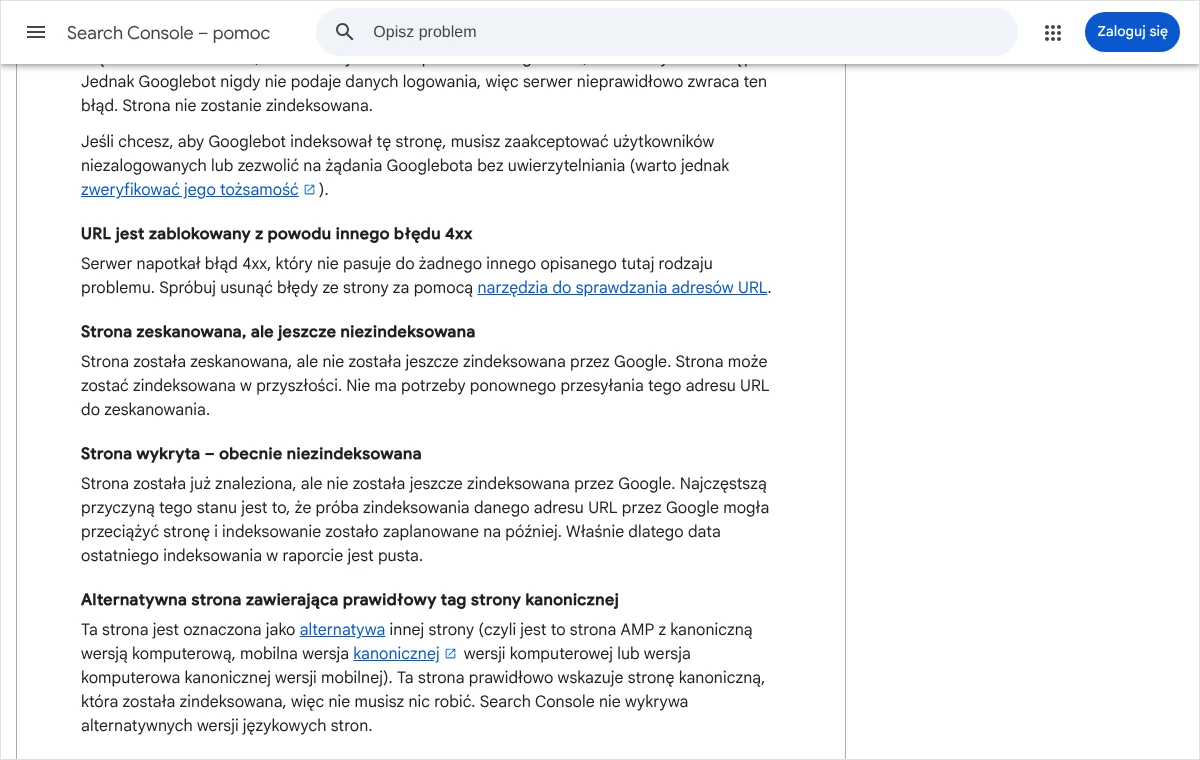
Opisywany stan oznacza, że dwie pierwsze czynności zostały wykonane, a trzecia nie. Dokumentacja Search Console opisuje go krótko: strona została zeskanowana, ale nie została jeszcze zindeksowana, może zostać zindeksowana w przyszłości i nie ma potrzeby ponownego przesyłania tego adresu do zeskanowania.
Z tego opisu wynikają dwie ważne rzeczy. Po pierwsze, robot dotarł do strony i ją pobrał, więc przeszkodą nie jest blokada dostępu ani awaria serwera. Takie sytuacje mają w raporcie osobne wiersze, na przykład „URL zablokowany przez plik robots.txt” albo „Błąd serwera (5xx)”. Po drugie, Google nie podaje w tym miejscu powodu swojej decyzji. Przyczynę trzeba ustalić samodzielnie i temu służy dalsza część instrukcji.
Sam stan nie jest karą ani ostrzeżeniem o naruszeniu zasad. W raporcie należy do grupy „Nie zindeksowano”, a Google zaznacza przy niej, że strony z tej grupy nie trafiły do indeksu niekoniecznie z powodu błędu. Dokumentacja wprost uprzedza też, żeby nie oczekiwać zindeksowania wszystkich adresów w witrynie.
Czym ten stan różni się od „Strona wykryta – obecnie niezindeksowana”?
Oba wiersze stoją w raporcie obok siebie i łatwo je pomylić. Przy stanie „Strona wykryta – obecnie niezindeksowana” Google zna adres, ale jeszcze go nie pobrał, dlatego data ostatniego skanowania pozostaje pusta. Tam zwykle chodzi o kolejkę i obciążenie serwera, co opisałem osobno w tekście o tym, co oznacza komunikat o stronie wykrytej, ale niezindeksowanej.
Przy stanie „Strona zeskanowana, ale jeszcze niezindeksowana” data skanowania jest wypełniona. Robot widział treść i mimo to strona nie znalazła się w indeksie. Dlatego w pierwszym przypadku pracuje się głównie nad dostępnością i strukturą serwisu, a w drugim nad tym, co robot zastał na samej podstronie.
Gdzie w Search Console znaleźć adresy z tym stanem?
Liczba przy wierszu niewiele mówi, dopóki nie wiadomo, jakie adresy się pod nią kryją. Pierwszym zadaniem jest więc otwarcie listy i zapisanie jej w miejscu, w którym da się z nią pracować.
- Po zalogowaniu do Google Search Console wybiera się właściwą usługę z listy w lewym górnym rogu.
- W menu po lewej stronie, w części „Indeksowanie”, należy kliknąć pozycję „Strony”. Otworzy się raport „Indeksowanie stron” z wykresem oraz liczbą stron zindeksowanych i niezindeksowanych.
- Pod wykresem znajduje się tabela „Dlaczego strony nie są indeksowane”. Trzeba odszukać w niej wiersz „Strona zeskanowana, ale jeszcze niezindeksowana” i go kliknąć.
- Otworzy się strona ze szczegółami: wykres liczby adresów w czasie oraz tabela z przykładami. Przy każdym adresie widać datę ostatniego skanowania.
- Listę najwygodniej wyeksportować do arkusza przyciskiem eksportu w prawym górnym rogu i dalej pracować już na pliku.
Tabela z przykładami ma ograniczenie, o którym dobrze wiedzieć od początku. Dokumentacja podaje, że lista nie musi zawierać wszystkich adresów z danym stanem i jest ograniczona do 1000 wierszy. W dużym sklepie widać więc tylko próbkę.
Jak zawęzić listę do adresów, na których firmie zależy?
Nad wykresem znajduje się filtr mapy witryny. Domyślnie ustawiona jest opcja „Wszystkie znane strony”, która pokazuje każdy adres znany Google, także przypadkowy. Po zmianie na „Wszystkie przesłane strony” raport pokaże tylko adresy zgłoszone w mapie witryny, czyli te, które właściciel sam uznał za ważne.
To najprostszy sposób, żeby sprawdzić skalę rzeczywistego problemu. Jeśli po włączeniu filtra wiersz znika albo liczba spada do kilku adresów, sytuacja jest znacznie lepsza, niż sugerowała pierwsza liczba. Warunkiem jest oczywiście przesłana mapa. Kto jej jeszcze nie ma w Search Console, powinien zacząć od zgłoszenia mapy witryny, bo bez niej filtr niczego nie pokaże.
Kiedy ten stan nie wymaga żadnego działania?
Znaczna część adresów z tej listy to zwykle strony, których nikt nie chciałby widzieć w wynikach wyszukiwania. System zarządzania treścią tworzy je automatycznie, robot je odwiedza, a Google słusznie uznaje, że nie ma czego indeksować. W takich przypadkach raport pokazuje stan prawidłowy.
Po wyeksportowaniu listy należy przejrzeć ją pod kątem adresów technicznych. Najczęściej są to:
- kanały RSS, czyli adresy zakończone na
/feed/, - wyniki wyszukiwarki wewnętrznej, w WordPressie adresy z fragmentem
?s=, - adresy z parametrami sortowania i filtrowania w sklepie,
- kolejne strony list wpisów lub produktów,
- strony załączników, tagów bez treści i archiwów autorów,
- adresy z dopiskami doklejonymi przez systemy reklamowe lub wtyczki.
Takich adresów nie trzeba naprawiać ani zgłaszać do indeksowania. Wystarczy oznaczyć je w arkuszu jako nieistotne i odłożyć. Jeśli jest ich bardzo dużo, można ograniczyć ich powstawanie, o czym piszę w części o naprawie.
Drugą grupą, która nie wymaga pośpiechu, są strony opublikowane niedawno. Według dokumentacji Google zindeksowanie nowych treści może zająć kilka dni, a w tym czasie adres może przejściowo widnieć w omawianym wierszu. Przy świeżej publikacji rozsądnie jest odczekać i wrócić do raportu później.
Działania wymaga dopiero trzecia grupa: strony usług, produktów, kategorii i wpisów, które mają przyciągać klientów, a od dłuższego czasu pozostają poza indeksem. Tylko nimi zajmują się kolejne części instrukcji.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: przejrzę listę adresów z raportu, oddzielę nieistotne od ważnych, ustalę przyczynę przy każdej ważnej podstronie i doprowadzę poprawki do końca.
Jakie są możliwe przyczyny przy ważnych podstronach?
Google nie publikuje listy powodów, dla których zeskanowana strona nie trafia do indeksu. W dokumentacji opisującej działanie wyszukiwarki zaznacza natomiast, że indeksowanie nie jest gwarantowane i zależy od treści strony, a wśród typowych przeszkód wymienia niską jakość treści oraz budowę witryny utrudniającą indeksowanie. Poniższe przyczyny wynikają z tych wskazań i z mojej praktyki. Przy konkretnej podstronie zwykle zachodzi jedna lub dwie.
Treści jest za mało albo nie odpowiada na żadne pytanie
Podstrona usługi z dwoma zdaniami, karta produktu z samą nazwą i ceną, wpis złożony z jednego akapitu. Robot pobiera taką stronę bez trudu, ale system nie znajduje na niej niczego, co uzasadniałoby miejsce w indeksie. To najczęstsza przyczyna na stronach małych firm.
Treść powtarza się na wielu podstronach
Dotyczy to serii stron budowanych z jednego wzoru, na przykład tej samej oferty powielonej dla kilkunastu miejscowości, gdzie zmienia się tylko nazwa miasta. Podobnie działają opisy produktów skopiowane od producenta, obecne w identycznym brzmieniu w wielu sklepach. Google wybiera wtedy jedną wersję, a pozostałe pomija.
Do podstrony prowadzi za mało linków z własnego serwisu
Strona, do której nie da się dojść z menu, z kategorii ani z innych tekstów, wygląda na mało ważną dla samego właściciela. Robot mógł ją znaleźć w mapie witryny i pobrać, ale brak odnośników wewnętrznych jest dla systemu wskazówką, że to treść poboczna.
Robot widzi inną stronę niż odwiedzający
Zdarza się, że właściwa treść pojawia się dopiero po uruchomieniu skryptów albo po kliknięciu w zakładkę, a robot otrzymuje niemal pustą stronę. Bywa też, że serwer w chwili skanowania zwrócił stronę niekompletną. Dla człowieka podstrona wygląda poprawnie, dla Google jest uboga.
Serwis jest nowy albo ogólnie słabo oceniany
W nowej witrynie, która nie ma jeszcze historii ani odnośników z innych stron, indeksowanie postępuje wolniej i wybiórczo. Podobnie jest w serwisach, w których dużą część stanowią strony o niewielkiej wartości. Wtedy problem nie leży w jednej podstronie, lecz w całości.
Raport pokazuje stan sprzed zmiany
Dane w raporcie nie odświeżają się natychmiast. Zdarza się, że strona została już zindeksowana, a w tabeli nadal widnieje wśród niezindeksowanych. Dlatego zanim cokolwiek zostanie poprawione, trzeba sprawdzić bieżący stan każdego ważnego adresu.
Jak sprawdzić, która przyczyna dotyczy konkretnej strony?
Do tego służy „Narzędzie do sprawdzania adresów URL” w Search Console. Pokazuje ono, co Google wie o pojedynczym adresie i jak widzi go robot. Sprawdzenie jednego adresu zajmuje kilka minut, a poniższą kolejność warto powtórzyć dla każdej ważnej podstrony z listy.
- W tabeli z przykładami należy najechać na wiersz z adresem i kliknąć ikonę lupy, która otwiera ten adres w narzędziu do sprawdzania. Można też wkleić pełny adres w pole wyszukiwania na górze Search Console.
- Na górze wyniku widnieje stan ogólny. Jeśli brzmi „Adres URL znajduje się w Google”, strona jest już zindeksowana, a raport po prostu jeszcze się nie odświeżył. Jeśli brzmi „Adres URL nie znajduje się w Google”, należy przejść dalej.
- Trzeba rozwinąć sekcję „Indeksowanie stron”. W części dotyczącej skanowania widać datę ostatniej wizyty robota. Jeśli strona była poprawiana po tej dacie, Google nie zna jeszcze nowej wersji.
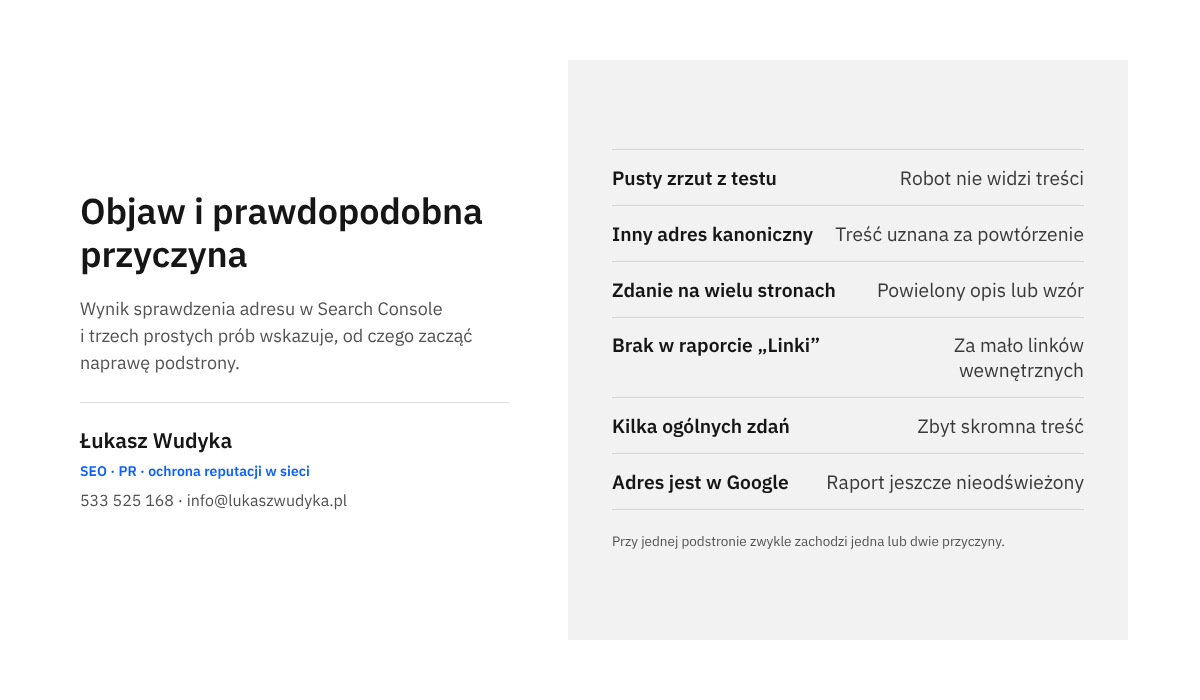
- W tej samej sekcji należy porównać pola „Adres kanoniczny określony przez użytkownika” oraz „Adres kanoniczny wybrany przez Google”. Jeżeli różnią się od sprawdzanego adresu, Google uznaje podstronę za powtórzenie innej.
- Następnie należy kliknąć „Sprawdź URL wersji opublikowanej”. Narzędzie pobierze stronę w tej chwili i pokaże, czy da się ją zindeksować.
- Po zakończeniu testu trzeba kliknąć „Wyświetl przetestowaną stronę” i otworzyć kartę „Zrzut ekranu”. Widać na niej, jak stronę zobaczył robot. Brak tekstu, puste miejsca po zdjęciach albo sam nagłówek oznaczają, że treść do robota nie dociera.
Dokumentacja zastrzega, że test wersji opublikowanej sprawdza jedynie, czy narzędzie ma dostęp do strony na potrzeby indeksowania. Pomyślny wynik nie oznacza, że strona trafi do indeksu. Służy on do wykluczenia przeszkód technicznych, a nie do oceny jakości.
Co sprawdzić poza Search Console?
Trzy proste próby pozwalają potwierdzić pozostałe przyczyny. Pierwsza dotyczy powtarzającej się treści: należy skopiować jedno charakterystyczne zdanie z podstrony i wkleić je w wyszukiwarkę Google w cudzysłowie. Jeśli to samo zdanie widnieje na innych adresach własnego serwisu albo w obcych sklepach, przyczyna jest znana.
Druga próba dotyczy linków wewnętrznych. W Search Console należy otworzyć raport „Linki” i w części poświęconej linkom wewnętrznym odszukać sprawdzany adres. Jeśli nie ma go na liście albo prowadzi do niego pojedynczy odnośnik, podstrona jest w serwisie niemal odcięta.
Trzecia próba to uczciwe porównanie. Wystarczy otworzyć trzy pierwsze wyniki Google na zapytanie, na które podstrona ma odpowiadać, i zestawić je z własną treścią. Jeżeli konkurencyjne strony odpowiadają na więcej pytań klienta, pokazują zdjęcia, zakres prac i warunki, a własna podstrona ogranicza się do ogólników, przyczyną jest zbyt skromna treść.
Jak naprawić każdą z przyczyn?
Naprawa zależy od tego, co wykazało sprawdzenie. Poniżej opisuję postępowanie osobno dla każdej sytuacji. Radzę zaczynać od podstron, które mają największe znaczenie dla sprzedaży, a nie od tych, które stoją najwyżej na liście.
Gdy treści jest za mało
Podstronę należy rozbudować tak, żeby klient znalazł na niej odpowiedzi, po które przyszedł: co obejmuje usługa, dla kogo jest przeznaczona, jak przebiega realizacja, od czego zależy termin, jakie są warunki współpracy, jakie pytania padają najczęściej. Tekst powinien powstać na podstawie wiedzy firmy, a nie przez dopisanie ogólnych zdań dla zwiększenia objętości.
Pomagają również własne zdjęcia z opisami, dane kontaktowe i jasny tytuł strony. Jeśli podstrony nie da się sensownie rozbudować, lepiej połączyć ją z inną, pokrewną, niż utrzymywać dwie słabe.
Gdy treść się powtarza
Są trzy wyjścia i trzeba świadomie wybrać jedno. Można przepisać podstronę tak, żeby większość treści była własna i dotyczyła tylko jej tematu. Przy stronach dla miejscowości oznacza to opis realnej obsługi danego miejsca, a nie podmianę nazwy.
Można też połączyć kilka podobnych podstron w jedną mocniejszą i ustawić przekierowanie 301 ze starych adresów na nowy. Trzecie wyjście to pozostawienie duplikatu wyłącznie dla wygody odwiedzających i wskazanie w nim wersji głównej znacznikiem kanonicznym, czyli wpisem rel="canonical" w nagłówku strony, który podaje adres wersji głównej.
W WordPressie nie trzeba wpisywać go ręcznie, bo wtyczki do SEO mają w edycji strony pole na adres kanoniczny. Wpisuje się w nie pełny adres wersji głównej, razem z początkiem https://. Trzeba przy tym uważać, żeby nie wskazać adresu kanonicznego na stronie, która sama ma być w indeksie, bo wtedy Google ją pominie.
Gdy brakuje linków wewnętrznych
Do ważnej podstrony powinny prowadzić odnośniki z miejsc, które same są często odwiedzane: z menu lub strony głównej, ze strony kategorii, z pokrewnych usług i z wpisów na blogu poruszających ten sam temat. Odnośnik powinien mieć opisową treść, na przykład nazwę usługi, a nie słowo „tutaj”.
Zwykle wystarcza kilka dobrze dobranych odnośników, żeby podstrona przestała być odcięta. Sposób rozplanowania ich w całym serwisie opisałem w tekście o tym, jak ułożyć linkowanie wewnętrzne.
Gdy robot nie widzi treści
Jeśli zrzut ekranu z testu pokazuje pustą lub niepełną stronę, sprawę trzeba przekazać osobie, która wykonała stronę. Wystarczy opis: „W teście wersji opublikowanej w Search Console robot nie widzi treści podstrony, proszę o udostępnienie jej w kodzie HTML bez konieczności uruchamiania skryptów”. Do zgłoszenia należy dołączyć adres podstrony i zrzut z narzędzia.
W tej samej karcie co zrzut ekranu dostępne są dodatkowe informacje o zasobach, których nie udało się wczytać. Warto je przekazać wykonawcy, bo często wskazują konkretny plik blokowany dla robota.
Gdy lista jest pełna adresów technicznych
Adresów technicznych nie trzeba naprawiać, ale przy bardzo dużej ich liczbie robot poświęca im czas, który mógłby przeznaczyć na ważne podstrony. Wyniki wyszukiwarki wewnętrznej w WordPressie można wyłączyć ze skanowania dwoma wierszami w pliku robots.txt:
User-agent: *
Disallow: /?s=
Z tym plikiem należy obchodzić się ostrożnie. Jeden zbyt szeroki wiersz potrafi zablokować całą witrynę, dlatego przed zmianą trzeba zachować kopię dotychczasowej treści pliku, a po zmianie sprawdzić w narzędziu do sprawdzania adresów, czy strona główna i ważne podstrony nadal są dostępne dla robota. Bezpieczniejszą drogą, gdy brakuje pewności, jest pozostawienie adresów technicznych bez zmian.
Jak poprosić Google o ponowną ocenę poprawionej strony?
Dokumentacja mówi, że przy tym stanie nie ma potrzeby ponownego przesyłania adresu. Dotyczy to strony, na której nic się nie zmieniło. Po wprowadzeniu rzeczywistej poprawki zgłoszenie ma sens, bo informuje Google, że pod adresem jest nowa wersja do oceny.
- W polu na górze Search Console należy wkleić adres poprawionej podstrony i poczekać na wynik.
- Trzeba kliknąć „Sprawdź URL wersji opublikowanej” i upewnić się na zrzucie ekranu, że robot widzi nową treść.
- Po powrocie do wyniku należy kliknąć „Poproś o zindeksowanie”. Narzędzie wykona krótki test i, jeśli nie wykryje błędów, doda stronę do kolejki indeksowania.
- Datę zgłoszenia i zakres poprawki warto zanotować w arkuszu przy danym adresie. Ułatwi to późniejszą ocenę skutków.
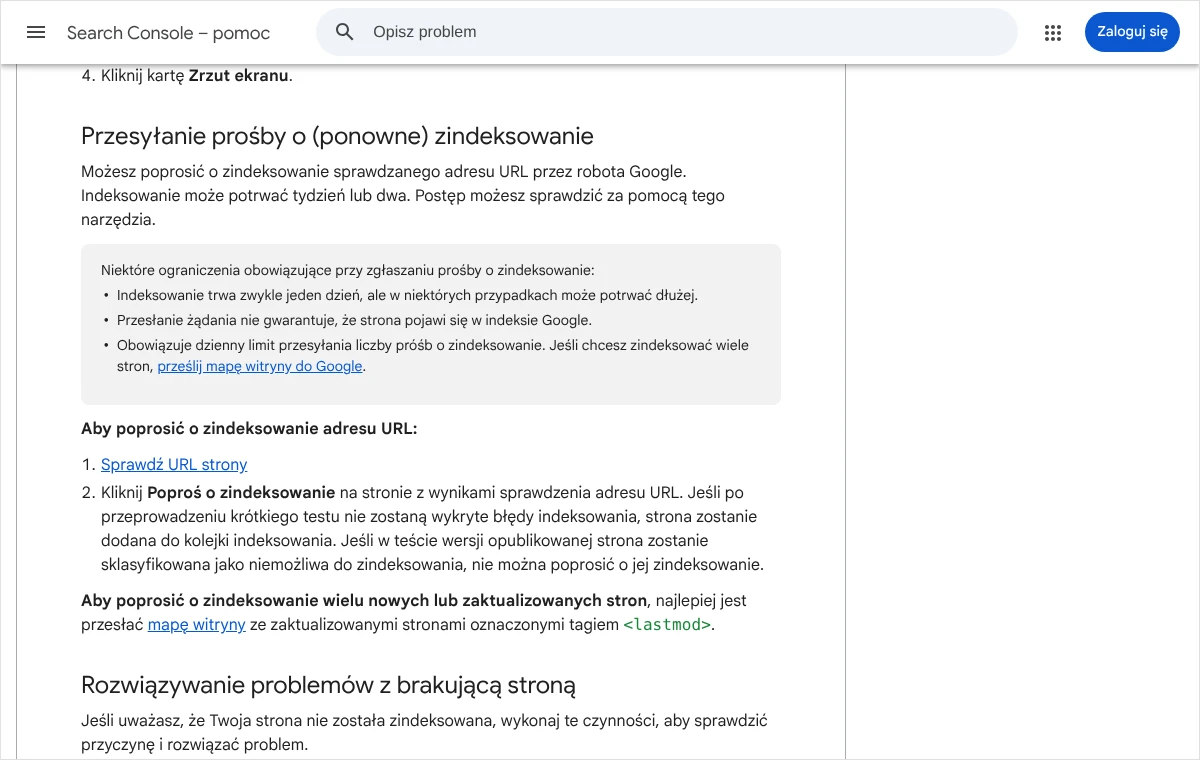
Zgłoszenie ma trzy ograniczenia opisane przez Google. Nie gwarantuje, że strona pojawi się w indeksie. Obowiązuje dzienny limit próśb, którego wysokości Google nie podaje. Wielokrotne zgłaszanie tego samego adresu nie przyspiesza indeksowania, więc jedna prośba po jednej poprawce w zupełności wystarcza.
Co zrobić przy większej liczbie poprawionych stron?
Przy kilkudziesięciu lub kilkuset adresach ręczne zgłaszanie nie ma sensu. Google zaleca wtedy przesłanie mapy witryny, w której poprawione strony mają zaktualizowaną datę modyfikacji w znaczniku <lastmod>. Wtyczki do SEO w WordPressie uzupełniają tę datę same po zapisaniu zmian na stronie.
Po poprawieniu całej grupy adresów można też skorzystać z przycisku „Sprawdź poprawkę” na stronie szczegółów wiersza „Strona zeskanowana, ale jeszcze niezindeksowana”. Google rozpoczyna wtedy weryfikację wszystkich adresów z tego wiersza. Według dokumentacji trwa ona zazwyczaj do 2 tygodni, a niekiedy znacznie dłużej, i nie należy klikać przycisku ponownie przed jej zakończeniem.
Weryfikacja zatrzymuje się, gdy Google trafi na pierwszy adres, w którym stan się nie zmienił. Dlatego dokumentacja podpowiada, żeby wcześniej zawęzić raport filtrem do mapy zawierającej tylko najważniejsze strony. Weryfikacja obejmie wtedy wyłącznie adresy z tej mapy i ma szansę zakończyć się szybciej.
Po czym poznać, że naprawa zadziałała?
Najpewniejszym źródłem jest narzędzie do sprawdzania adresów. Po ponownym sprawdzeniu podstrony stan na górze powinien zmienić się na „Adres URL znajduje się w Google”, a data ostatniego skanowania powinna być późniejsza niż data poprawki. Jeśli data jest wcześniejsza, robot jeszcze nie wrócił i ocena jest przedwczesna.
Drugim potwierdzeniem jest zwykłe wyszukiwanie. W Google należy wpisać operator site: z pełnym adresem podstrony, na przykład site:przykladowa-domena.pl/nazwa-uslugi/. Jeżeli strona pojawia się w wyniku, jest w indeksie. Dokładny opis tej i innych metod znajduje się w tekście o tym, jak sprawdzić, czy Google zaindeksował stronę.
Trzecim znakiem jest sam raport „Indeksowanie stron”. Liczba przy wierszu powinna z czasem maleć, a linia zindeksowanych stron na wykresie rosnąć. Raport reaguje jednak z opóźnieniem, dlatego nie należy oceniać skutków na jego podstawie dzień po zgłoszeniu.
Co do terminów Google podaje różne wartości: zwykle jeden dzień, w innych miejscach tydzień lub dwa, a w dokumentacji dla twórców stron od kilku dni do kilku tygodni. W praktyce rozsądnie jest sprawdzić adres po kilku dniach, potem po dwóch tygodniach, i dopiero po tym czasie wyciągać wnioski.
Co zrobić, gdy strona nadal pozostaje poza indeksem?
Jeśli po kilku tygodniach robot ponownie odwiedził podstronę, a stan się nie zmienił, poprawka była zbyt mała albo przyczyna leży gdzie indziej. Ponowne klikanie prośby o zindeksowanie niczego nie zmieni. Trzeba wrócić do diagnozy i przejść ją raz jeszcze, tym razem surowiej.
Najpierw należy ponownie porównać podstronę z wynikami, które Google pokazuje na dane zapytanie. Dopisanie dwóch akapitów do strony, która wcześniej miała trzy zdania, rzadko wystarcza, gdy konkurencyjne strony omawiają temat wyczerpująco. Następnie trzeba sprawdzić, czy przybyło odnośników wewnętrznych i czy prowadzą z miejsc faktycznie odwiedzanych.
Jeżeli poza indeksem pozostaje wiele podstron jednocześnie, uwagę należy przenieść z pojedynczych adresów na cały serwis. Pomaga usunięcie lub połączenie stron, które niczego nie wnoszą: pustych tagów, powielonych opisów, starych wpisów bez wartości. Usuniętym adresom, które mają odpowiednik, ustawia się przekierowanie 301, pozostałe mogą zwracać kod 404.
Warto też zajrzeć do Search Console do raportu „Ręczne działania” w części poświęconej bezpieczeństwu. Jeśli widnieje tam informacja, że nie wykryto problemów, przyczyną nie jest kara. Gdyby pojawił się tam wpis, należy postępować zgodnie z jego treścią, bo to odrębna sprawa od omawianego stanu.
W nowych serwisach często potrzebny jest po prostu czas i stopniowe budowanie wiarygodności: regularne publikowanie rzetelnych treści, wzmianki i odnośniki z innych, uczciwych stron, na przykład od partnerów handlowych, organizacji branżowych czy lokalnych mediów. Odradzam kupowanie pakietów linków i usług obiecujących natychmiastowe indeksowanie. Są sprzeczne z zasadami Google dotyczącymi spamu i mogą zaszkodzić całej witrynie.
Jakich błędów unikać przy tym stanie?
Większość kłopotów bierze się z pośpiechu i z prób obejścia problemu zamiast jego rozwiązania. Poniższe zachowania widuję najczęściej i każde z nich pogarsza sytuację albo co najmniej marnuje czas.
- Codzienne zgłaszanie tego samego adresu do indeksowania. Google wprost podaje, że nie przyspiesza to niczego, a dzienny limit próśb wyczerpuje się niepotrzebnie.
- Zmienianie adresów podstron w nadziei na „nowy start”. Nowy adres z tą samą treścią trafi do tego samego wiersza, a po drodze powstaną błędy 404 i utracone odnośniki.
- Usuwanie podstron bez sprawdzenia, czy mają odwiedziny i odnośniki. Przed usunięciem trzeba ustalić, czy strona nie jest potrzebna klientom, i zaplanować przekierowanie.
- Dopisywanie tekstu wyłącznie dla objętości. Powtarzanie tych samych zdań innymi słowami nie zmienia oceny, bo nie przybywa odpowiedzi na pytania klienta.
- Blokowanie niezindeksowanych adresów w pliku robots.txt bez namysłu. Blokada zatrzymuje skanowanie, więc Google nie zobaczy późniejszych poprawek.
- Traktowanie całej liczby z raportu jako problemu. Bez podziału na adresy ważne i techniczne naprawia się rzeczy, które naprawy nie wymagają.
Uważam też, że nie należy poprawiać wszystkiego jednocześnie. Zmiany wprowadzane partiami, z notatką o dacie i zakresie, pozwalają później ocenić, co faktycznie pomogło.
Najczęstsze pytania
Czy ten stan oznacza karę od Google?
Nie. Stan należy do grupy stron niezindeksowanych, przy której Google zaznacza, że brak indeksowania nie musi wynikać z błędu. Kary nakładane ręcznie widać w osobnym raporcie „Ręczne działania”, a omawiany wiersz informuje jedynie, że system po pobraniu strony nie umieścił jej w indeksie.
Ile trzeba czekać na zindeksowanie po poprawce?
Google nie podaje jednego terminu. W pomocy Search Console mowa jest o jednym dniu w typowym przypadku oraz o tygodniu lub dwóch, a w dokumentacji dla twórców stron o okresie od kilku dni do kilku tygodni. Żaden z tych terminów nie jest gwarantowany, dlatego ocenę skutków najlepiej odłożyć do chwili, gdy robot ponownie odwiedzi stronę.
Czy każda strona w serwisie powinna być w indeksie?
Nie i Google mówi to wprost: nie należy oczekiwać zindeksowania wszystkich adresów w witrynie. W indeksie powinny znajdować się główne wersje istotnych stron. Adresy techniczne, powtórzenia i strony bez treści pozostają poza nim i jest to prawidłowe.
Czy prośba o zindeksowanie wystarczy bez zmian na stronie?
Zwykle nie. Robot już stronę widział i system podjął decyzję na podstawie tego, co na niej zastał. Ponowne pobranie tej samej treści najczęściej kończy się tym samym wynikiem, dlatego prośbę należy wysyłać dopiero po rzeczywistej poprawce.
Dlaczego liczba adresów w raporcie rośnie, choć nic nie było zmieniane?
Najczęściej robot odkrywa kolejne adresy techniczne tworzone automatycznie przez system strony: filtry, sortowania, kanały RSS, wyniki wyszukiwarki wewnętrznej. Wystarczy włączyć filtr „Wszystkie przesłane strony”, żeby sprawdzić, czy wzrost dotyczy ważnych podstron. Jeśli nie, wzrost nie jest powodem do niepokoju, choć przy dużej skali warto ograniczyć powstawanie takich adresów.
Narzędzie pokazuje, że strona jest w Google, a raport nadal ją wymienia. Któremu wierzyć?
Narzędziu do sprawdzania adresów, ponieważ pokazuje bieżące dane o pojedynczym adresie. Raport „Indeksowanie stron” odświeża się z opóźnieniem i przez pewien czas może pokazywać stan wcześniejszy. W takiej sytuacji nie trzeba nic robić poza odczekaniem.
Czy strona, która była w indeksie, może do tego stanu wrócić?
Tak. Google ocenia strony wielokrotnie i może usunąć z indeksu adres, który wcześniej w nim był, na przykład gdy treść się zestarzała, w serwisie pojawiła się bardzo podobna podstrona albo znikły prowadzące do niej odnośniki. Postępowanie jest wtedy takie samo: sprawdzenie adresu w narzędziu, ustalenie przyczyny i poprawka.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Rozumiem to dobrze, bo prowadzenie firmy rzadko zostawia czas na przeglądanie raportów. Mogę zająć się tym od początku do końca: otworzę raport w Search Console, przejrzę adresy z omawianego wiersza, oddzielę te, które nie wymagają niczego, od tych, które powinny przyciągać klientów, a przy każdej ważnej podstronie ustalę, dlaczego Google jej nie zindeksował. Potem przygotuję poprawki treści i odnośników, zgłoszę strony do ponownej oceny i sprawdzę, czy trafiły do indeksu.
Na koniec przekażę prosty opis tego, co zostało zrobione i na co zwracać uwagę przy kolejnych publikacjach. Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i krótko opisać, co widać w raporcie.