Adres został ukryty w Search Console, przez kilka miesięcy nie było go w wynikach, a potem bez żadnego ostrzeżenia pojawił się znowu: stara oferta, wycofany cennik, podstrona z danymi byłego pracownika albo wersja testowa serwisu. To jedna z najczęstszych niespodzianek, z jakimi zgłaszają się do mnie właściciele firm. Zwykle towarzyszy jej przekonanie, że Google popełnił błąd albo cofnął własną decyzję. Tymczasem narzędzie zadziałało dokładnie tak, jak zostało zaprojektowane: ukryło adres na określony czas i po jego upływie przestało go ukrywać.
Ten tekst jest instrukcją dla osób, które mają dostęp do Search Console swojej witryny i chcą, żeby wskazana strona zniknęła z Google na dobre, a nie na kolejne pół roku. Po lekturze będzie wiadomo, jak potwierdzić, że przyczyną powrotu jest wygasła prośba, którą z trzech dróg trwałego usunięcia wybrać w konkretnej sytuacji, jak ją poprawnie wykonać i po czym poznać, że tym razem adres już nie wróci. Opisuję też błędy, przez które strona potrafi wracać mimo kilku prób.
Najważniejsze w skrócie
- Prośba złożona w narzędziu „Usunięcia” ukrywa adres na około 6 miesięcy, po czym otrzymuje stan „Usunięcie wygasło” i strona może znów być widoczna.
- Tymczasowe usunięcie nie wstrzymuje odwiedzin robota, więc istniejąca i dostępna strona pozostaje w indeksie i czeka na koniec blokady.
- Trwały skutek dają tylko trzy działania na samej witrynie: usunięcie strony z kodem 404 lub 410, ochrona hasłem albo tag noindex.
- Plik robots.txt nie nadaje się do tego celu, ponieważ zablokowany w nim adres nadal może pojawiać się w wynikach, tyle że bez opisu.
- Właściwa kolejność to najpierw zmiana na stronie, a dopiero potem nowa prośba o tymczasowe usunięcie, która ukryje adres do czasu ponownej wizyty robota.
- Skuteczność potwierdza narzędzie do sprawdzania adresów URL komunikatem „Adres URL nie znajduje się w Google”.
Dlaczego strona wróciła do Google, skoro została usunięta?
Narzędzie „Usunięcia” w Search Console nie usuwa niczego z internetu ani nawet z indeksu Google w sposób trwały. Pomoc Search Console opisuje je wprost jako sposób na tymczasowe blokowanie stron w wynikach wyszukiwania i zastrzega, że pozytywnie rozpatrzona prośba jest ważna tylko przez około 6 miesięcy. W innym miejscu tej samej strony pada liczba 180 dni. Po tym czasie prośba traci ważność, a w tabeli historii pojawia się przy niej stan „Usunięcie wygasło” z wyjaśnieniem, że strona może ponownie pojawiać się w wynikach wyszukiwania Google.
Druga rzecz, o której mało kto wie w chwili składania prośby: ukrycie adresu nie zatrzymuje robota. Google nadal odwiedza stronę, o ile ona istnieje i nie została zablokowana w inny sposób, może odświeżać jej zapis w indeksie, a jedynie nie pokazuje jej w wynikach do końca okresu blokady. Jeśli więc przez te miesiące strona pozostała na serwerze, odpowiadała poprawnie i nie miała żadnej blokady indeksowania, to w dniu wygaśnięcia prośby była gotowa do wyświetlenia. Stąd wrażenie, że wróciła z dnia na dzień.
Dokumentacja mówi o tym jasno: użycie narzędzia jest tylko jednym z etapów trwałego usuwania adresu i samo nie wystarcza. Pierwszym etapem jest szybkie ukrycie, drugim zmiana na samej witrynie, która sprawi, że Google nie będzie miał czego pokazywać. Powrót strony po kilku miesiącach oznacza zatem, że wykonano tylko pierwszy etap. Dobra wiadomość jest taka, że drugi można wykonać w każdej chwili, a ponowna prośba o ukrycie zamknie okres przejściowy.
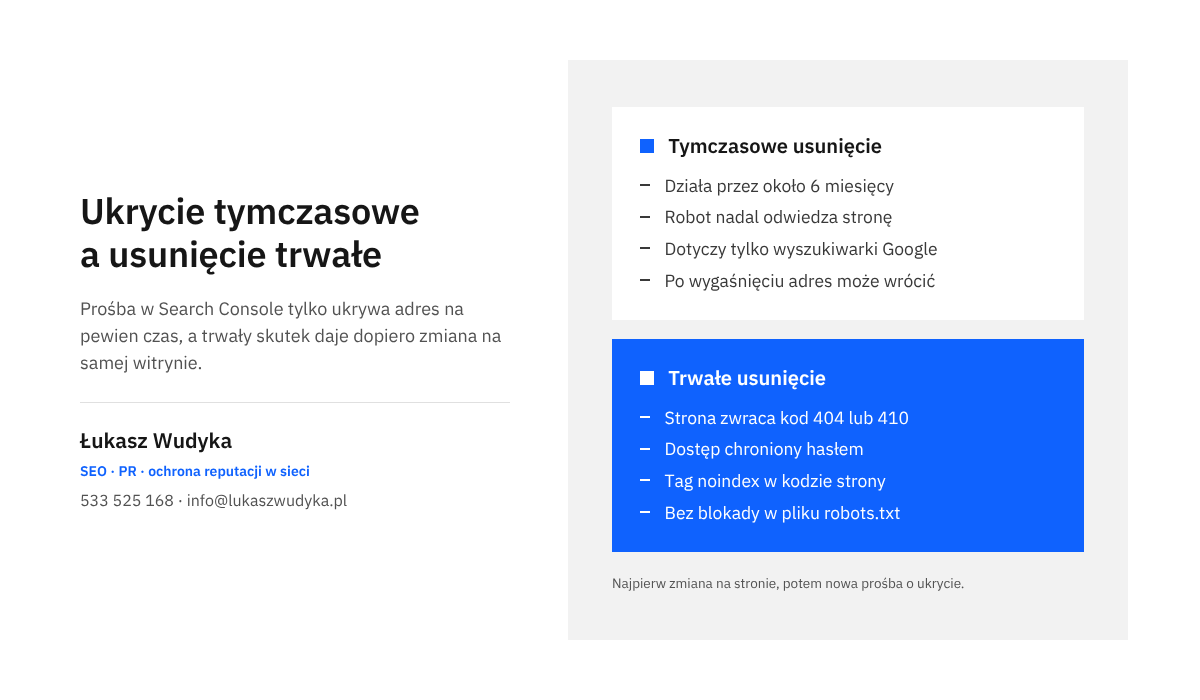
Warto też wiedzieć, czego narzędzie nie obejmuje. Działa wyłącznie w wyszukiwarce Google, więc w innych wyszukiwarkach adres mógł być widoczny przez cały czas. Nie usuwa treści z serwera, dlatego każdy, kto znał link, nadal mógł otworzyć stronę. Nie obejmuje też innych subdomen: prośba dotycząca adresu w domenie głównej ukrywa warianty z www i bez www oraz z http i https, ale nie ukrywa na przykład wersji pod adresem zaczynającym się od „m.”. Te ograniczenia mają znaczenie przy wyborze trwałego rozwiązania, o czym niżej.
Jak potwierdzić, że przyczyną jest wygasła prośba, a nie coś innego?
Zanim zacznie się cokolwiek zmieniać na stronie, należy ustalić fakty. Zdarza się, że do wyników wraca nie ten adres, który był ukryty, lecz jego bliźniak: ta sama treść dostępna pod adresem pisanym wielkimi literami, z parametrem po znaku zapytania albo z końcówką „.html”. Pomoc Search Console podkreśla, że prośba o usunięcie pojedynczego adresu dotyczy dokładnie tego zapisu, a różnica jednej litery oznacza dla Google inny adres. Poniższe czynności pozwalają rozróżnić te sytuacje w kilka minut.
- Otwarcie narzędzia do usuwania W Search Console, w usłudze obejmującej daną witrynę, należy przejść do pozycji „Usunięcia” w menu po lewej stronie i pozostać na karcie „Tymczasowe usunięcia”.
- Odszukanie prośby w tabeli historii Tabela pokazuje prośby z ostatnich 6 miesięcy wraz z adresem, typem i stanem. Przy właściwym adresie powinien widnieć typ „Tymczasowe usunięcie adresu URL” oraz stan „Usunięcie wygasło”.
- Porównanie adresów znak po znaku Adres z tabeli trzeba zestawić z adresem skopiowanym z wyniku wyszukiwania. Jeśli różnią się wielkością liter, parametrem lub rozszerzeniem, do wyników wrócił inny wariant tej samej strony.
- Sprawdzenie adresu w indeksie Adres z wyniku wyszukiwania wkleja się w pole u góry Search Console. Komunikat „Adres URL znajduje się w Google” potwierdza, że strona jest w indeksie i może być wyświetlana.
- Otwarcie strony w oknie prywatnym przeglądarki Należy ustalić, czy strona wciąż się wyświetla bez logowania. Jeśli tak, Google widzi ją tak samo jak każdy internauta i nie ma powodu, żeby pomijał ją w wynikach.
Jeżeli prośby nie ma już w tabeli, najpewniej minęło ponad pół roku od jej złożenia i wpis zniknął z historii, co nie zmienia dalszego postępowania. Jeżeli natomiast przy prośbie widnieje stan „Prośba anulowana”, ktoś z dostępem do usługi wycofał ją ręcznie i należy ustalić, kto i po co. Stan „Prośba odrzucona” oznacza, że adres w ogóle nie został ukryty, a według pomocy zwykle powodem jest wcześniejsza, identyczna prośba. Sposób czytania wyników sprawdzenia adresu opisałem osobno w tekście o tym, jak działa narzędzie Usunięcia w Search Console, gdzie omawiam też typy próśb.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Ustalę wtedy, który dokładnie adres wrócił do wyników i dlaczego, dobiorę sposób trwałego usunięcia do rodzaju strony, wprowadzę zmianę na witrynie, złożę nową prośbę w Search Console i dopilnuję, żeby adres rzeczywiście zniknął z indeksu.
Którą z trzech dróg trwałego usunięcia wybrać?
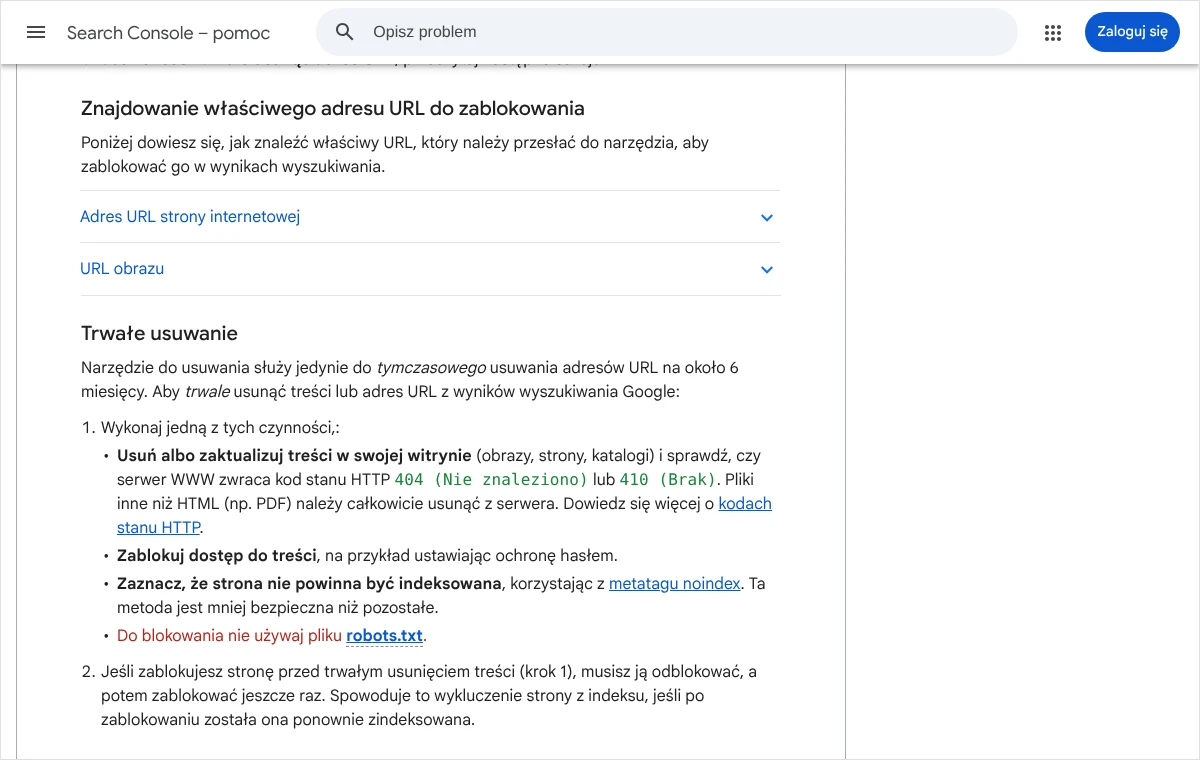
Dokumentacja Google wymienia trzy działania, z których należy wykonać jedno: usunięcie albo zmianę treści tak, żeby serwer zwracał kod 404 lub 410, zablokowanie dostępu do treści hasłem oraz oznaczenie strony tagiem noindex. O tej trzeciej metodzie pomoc Search Console pisze, że jest mniej bezpieczna niż pozostałe. Wybór zależy od jednego pytania: czy ta strona jest jeszcze komukolwiek potrzebna. Zestawienie poniżej porządkuje odpowiedzi, a kolejne części opisują wykonanie każdej z dróg.
| Sytuacja | Właściwa droga | Na co uważać |
|---|---|---|
| Strona nie jest już nikomu potrzebna | Usunięcie strony, serwer zwraca kod 404 lub 410 | Adres nie może być przekierowany na inną stronę ani wyświetlać zwykłej treści z kodem 200 |
| Strona ma służyć tylko wybranym osobom | Ochrona hasłem na poziomie serwera lub systemu strony | Hasło musi obejmować także pliki, np. dokumenty PDF podlinkowane ze strony |
| Strona ma być dostępna z linku, ale nie z Google | Tag noindex w kodzie strony lub w nagłówku odpowiedzi | Adres nie może być jednocześnie zablokowany w pliku robots.txt |
| Usunięto tylko fragment treści, strona zostaje | Prośba typu „Wyczyść krótki opis w wyszukiwarce” | Strona pozostaje w wynikach, zmienia się tylko opis pod tytułem |
Usunięcie strony z serwera, czyli kod 404 lub 410
To rozwiązanie najpewniejsze i jedyne, które chroni treść także przed innymi wyszukiwarkami oraz przed osobami znającymi link. Dokumentacja dla właścicieli witryn nazywa je najbezpieczniejszym sposobem. Polega na tym, że strony po prostu nie ma: w systemie zarządzania treścią przenosi się ją do kosza i opróżnia kosz albo usuwa plik z serwera. Po takim zabiegu serwer powinien odpowiadać kodem 404, czyli „Nie znaleziono”, albo 410, czyli „Brak”. Google podaje, że adresy już zindeksowane, które zwracają kod z grupy 4xx, są usuwane z indeksu, a oba kody traktuje pod tym względem jednakowo.
Najczęstszy błąd na tym etapie to strona, która wygląda na usuniętą, ale technicznie nadal istnieje. Część szablonów po usunięciu wpisu przekierowuje odwiedzającego na stronę główną albo pokazuje napis o braku treści, zwracając przy tym kod 200. Google opisuje taki przypadek jako pozorny błąd 404 i może traktować adres jako wciąż istniejący. Dlatego po usunięciu trzeba sprawdzić faktyczną odpowiedź serwera, a nie tylko wygląd ekranu. Na serwerze Apache kod 410 dla jednego adresu ustawia w pliku .htaccess wiersz Redirect gone /stara-oferta/, w którym ścieżkę zastępuje się własną. Przed każdą zmianą w tym pliku należy zachować jego kopię, bo błąd w składni potrafi wyłączyć całą witrynę.
Osobna uwaga dotyczy plików. Pomoc Search Console wskazuje, że pliki inne niż HTML, na przykład dokumenty PDF, należy całkowicie usunąć z serwera. Usunięcie podstrony, na której plik był podlinkowany, nie usuwa samego pliku z katalogu z multimediami, więc dokument może pozostać w wynikach pod własnym adresem. To samo dotyczy zdjęć: obraz widoczny w wynikach graficznych ma osobny adres i wymaga osobnego usunięcia z serwera.
Ochrona hasłem, gdy strona ma zostać dla wybranych osób
Jeśli treść jest potrzebna pracownikom, klientom albo partnerom, ale nie powinna być publiczna, właściwym rozwiązaniem jest ograniczenie dostępu. Dokumentacja Google wyjaśnia, że strona zabezpieczona hasłem pozostaje dostępna dla właściwych użytkowników, a jednocześnie jest zamknięta dla Googlebota i innych robotów. Robot, który przy próbie wejścia otrzymuje żądanie autoryzacji, dostaje odpowiedź z grupy 4xx, a więc taką, po której zindeksowany wcześniej adres wypada z indeksu. To rozwiązanie działa również w innych wyszukiwarkach, czego nie można powiedzieć o tagu noindex.
Ochronę najlepiej ustawić na poziomie serwera, w panelu hostingu, w miejscu opisanym zwykle jako ochrona katalogu hasłem. Taka blokada obejmuje wszystko, co znajduje się w katalogu, razem z plikami. Systemy zarządzania treścią oferują też własne zabezpieczenia pojedynczych wpisów, jednak przed ich użyciem trzeba sprawdzić dwie rzeczy: czy po wejściu bez hasła nie widać tytułu i początku treści oraz czy zabezpieczenie obejmuje załączniki. Typowym zastosowaniem tej drogi jest wersja testowa serwisu pod adresem w rodzaju „test.” albo „dev.”, która nigdy nie powinna była trafić do Google.
Tag noindex, gdy strona ma działać, ale poza wynikami wyszukiwania
Trzecia droga zostawia stronę dostępną dla każdego, kto ma link, i prosi wyszukiwarkę, żeby jej nie pokazywała. Według dokumentacji Google robot, który podczas odwiedzin odczyta tę regułę, całkowicie eliminuje stronę z wyników, niezależnie od tego, czy prowadzą do niej linki z innych witryn. Regułę podaje się na dwa sposoby. Pierwszy to wiersz w sekcji head strony: <meta name="robots" content="noindex">. Drugi to nagłówek odpowiedzi serwera X-Robots-Tag: noindex, przydatny dla plików, które nie mają kodu HTML, takich jak dokumenty PDF czy obrazy.
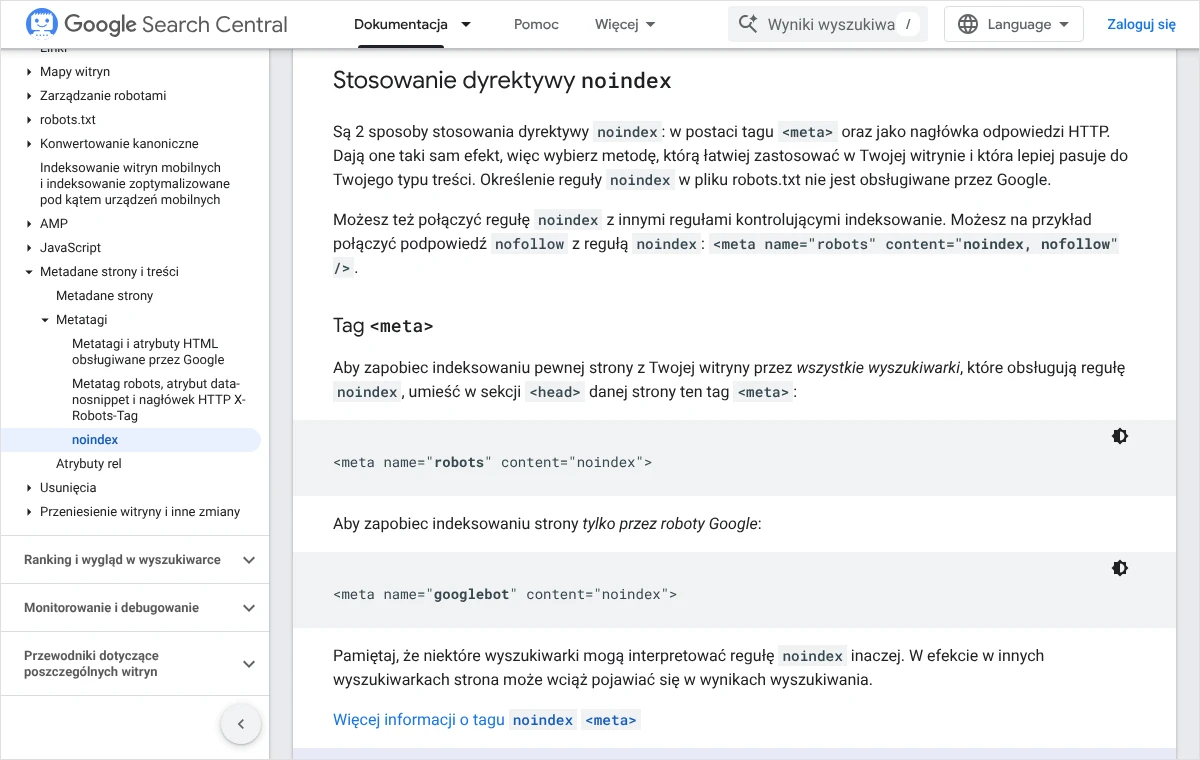
W systemach zarządzania treścią zwykle nie trzeba edytować kodu. Dokumentacja wskazuje, że system może mieć stronę ustawień wyszukiwarki albo inny mechanizm dodawania tagów meta, a w praktyce jest to najczęściej przełącznik w edycji konkretnej podstrony, dostarczany przez wtyczkę SEO. Po włączeniu należy otworzyć źródło strony i wyszukać w nim słowo noindex, żeby upewnić się, że tag naprawdę się pojawił. Jeśli witryna korzysta z pamięci podręcznej, trzeba ją wyczyścić, bo robot może przez długi czas otrzymywać starą wersję bez tagu.
Ta metoda ma dwa słabe punkty, o których uczciwie trzeba powiedzieć. Treść pozostaje publiczna, a wyszukiwarki, które nie obsługują reguły noindex, mogą ją nadal pokazywać. Poza tym tag działa tylko tak długo, jak długo jest na stronie: zmiana szablonu, aktualizacja wtyczki albo przywrócenie kopii zapasowej potrafi go usunąć bez wiedzy właściciela, a wtedy strona wróci do wyników po kolejnej wizycie robota. Dla treści naprawdę wrażliwych, takich jak dane osobowe, radzę wybierać usunięcie albo hasło. Więcej o diagnozowaniu tej reguły zawiera tekst o komunikacie „Strona wykluczona za pomocą tagu noindex”.
Dlaczego nie wolno blokować takiej strony w pliku robots.txt?
Odruchem wielu osób, a niestety także części wykonawców stron, jest dopisanie do pliku robots.txt reguły zakazującej robotom wstępu pod dany adres. Brzmi to rozsądnie, ale działa odwrotnie do zamierzeń. Google opisuje ten plik jako narzędzie do zarządzania ruchem robotów, używane głównie po to, żeby witryna nie była przeciążona żądaniami, i wprost zastrzega, że nie jest to mechanizm służący do ukrywania strony przed wyszukiwarką. Na obu stronach dokumentacji poświęconych trwałemu usuwaniu znajduje się to samo zdanie: do blokowania nie należy używać pliku robots.txt.
Powód jest prosty. Reguła w tym pliku zabrania robotowi pobierania strony, ale nie zabrania pokazywania jej adresu. Jeśli do strony prowadzą linki z innych miejsc w sieci, Google może zindeksować sam adres i wyświetlać go w wynikach bez opisu, czasem z tekstem linku zaczerpniętym z cudzej witryny. Co gorsza, zakaz wstępu unieważnia tag noindex: robot, który nie może otworzyć strony, nie odczyta reguły zapisanej w jej kodzie. Dokumentacja podkreśla, że noindex działa tylko wtedy, gdy strona nie jest zablokowana w pliku robots.txt ani niedostępna dla robota z innego powodu.
W praktyce oznacza to konieczność sprawdzenia pliku przed wdrożeniem którejkolwiek z trzech dróg. Jeśli znajduje się w nim wiersz zaczynający się od „Disallow:” i obejmujący usuwany adres, należy go usunąć, żeby robot mógł wejść na stronę i zobaczyć kod 404, żądanie hasła albo tag noindex. Dopiero po odnotowaniu tej odpowiedzi adres trwale wypadnie z indeksu. Zasady pisania reguł omawiam w tekście o tym, jak ustawić plik robots.txt, a sam problem adresu widocznego mimo zakazu ma w Search Console własny stan w raporcie „Indeksowanie stron”.
Jak ponowić prośbę, żeby adres zniknął od razu i nie wrócił?
Zmiana na witrynie zaczyna działać dopiero wtedy, gdy robot ponownie odwiedzi adres, a to według dokumentacji może potrwać nawet kilka miesięcy, zależnie od znaczenia strony. Na ten czas przydaje się to samo narzędzie, które wcześniej zawiodło oczekiwania: nowa prośba ukryje adres w ciągu około doby, a zanim wygaśnie, Google zdąży odczytać trwałą blokadę. Pomoc Search Console opisuje tę kolejność w drugim punkcie sekcji o trwałym usuwaniu: jeśli strona została zablokowana przed wprowadzeniem trwałej zmiany, trzeba ją odblokować i zablokować jeszcze raz.
- Wdrożenie trwałej zmiany na stronie Najpierw wykonuje się jedną z trzech dróg opisanych wyżej i sprawdza w oknie prywatnym przeglądarki, że strona zwraca błąd, żąda hasła albo zawiera tag noindex.
- Uporządkowanie starej prośby W narzędziu „Usunięcia” prośba ze stanem „Usunięcie wygasło” nie wymaga działań. Jeśli jednak w tabeli jest jeszcze czynna prośba dla tego adresu, należy otworzyć menu obok niej i użyć polecenia „Anuluj prośbę”.
- Złożenie nowej prośby Na karcie „Tymczasowe usunięcia” należy kliknąć „Nowa prośba” i pozostać przy typie „Tymczasowe usunięcie adresu URL”.
- Wpisanie adresu i wybór zakresu W pole wkleja się pełny adres skopiowany z wyniku wyszukiwania, bez części po znaku #. Dla jednej strony zaznacza się „Usuń tylko ten URL”, a dla całego katalogu „Usuń wszystkie URL-e z tym prefiksem”.
- Zatwierdzenie i kontrola stanu Po kliknięciu „Dalej” i dokończeniu procedury prośba otrzymuje stan „Przetwarzam prośbę”. Rozpatrzenie może zająć nawet cały dzień, a wynik trzeba sprawdzić w tej samej tabeli.
- Powtórzenie dla pozostałych wariantów Osobne prośby składa się dla adresów pisanych inną wielkością liter, z parametrami oraz dla wersji w innych subdomenach, jeśli prowadzą do tej samej treści.
Przy opcji z prefiksem potrzebna jest szczególna ostrożność. Wpisanie samego adresu domeny, na przykład „https://example.com/”, ukrywa całą witrynę, a prefiks bez ukośnika na końcu obejmuje także inne adresy zaczynające się tym samym ciągiem znaków. Przed zatwierdzeniem należy więc jeszcze raz przeczytać wpisany adres i upewnić się, że zakres nie jest szerszy od zamierzonego. Gdyby doszło do pomyłki, prośbę da się wycofać poleceniem „Anuluj prośbę”, a ukryte adresy wrócą do wyników.
Jest też jeden przypadek, w którym nowa prośba zachowa się inaczej. Jeżeli strona została usunięta i zwraca kod 404, Google według pomocy uznaje, że strona nie istnieje, i unieważnia prośbę o jej zablokowanie, bo nie ma już czego ukrywać. To nie błąd, tylko skrót: adres i tak wypadnie z indeksu. Trzeba jedynie pamiętać o skutku ubocznym opisanym w dokumentacji. Każda strona, która w przyszłości pojawi się pod tym samym adresem, zostanie uznana za nową i będzie mogła trafić do wyników.
Po czym poznać, że tym razem usunięcie jest trwałe?
Brak strony w wynikach dzień po złożeniu prośby niczego jeszcze nie dowodzi, bo tak samo wyglądało to pół roku wcześniej. Dowodem jest dopiero zapis w indeksie. Najprościej odczytać go narzędziem do sprawdzania adresów URL: po wklejeniu adresu w pole u góry Search Console powinien pojawić się komunikat „Adres URL nie znajduje się w Google”, a w sekcji „Indeksowanie stron” przyczyna zgodna z wybraną drogą, czyli błąd 404, żądanie autoryzacji albo wykryta reguła noindex. Dopóki widnieje tam „Adres URL znajduje się w Google”, robot nie odczytał jeszcze zmiany i adres jest tylko ukryty.
Na tym etapie pomaga przycisk „Sprawdź URL wersji opublikowanej”, który pokazuje, co Google widzi pod adresem w danej chwili, a nie podczas ostatniej wizyty. Jeśli test wykazuje, że strona jest dostępna i dozwolona do indeksowania, trwała zmiana nie działa i trzeba wrócić do poprzednich kroków: najczęściej winna jest pamięć podręczna, tag dodany tylko w wersji dla zalogowanych albo usunięcie nie tego wariantu adresu. Pomoc zastrzega przy tym, że test wersji opublikowanej nie uwzględnia tymczasowo zablokowanych adresów, więc jego wynik mówi wyłącznie o stanie samej strony.
Drugim miejscem kontroli jest raport „Indeksowanie stron”. W tabeli „Dlaczego strony nie są indeksowane” adres powinien z czasem trafić do wiersza odpowiadającego zastosowanej metodzie. Raport odświeża się z opóźnieniem, dlatego radzę zapisać sobie przypomnienie i wrócić do niego po kilku tygodniach, a potem jeszcze raz przed upływem sześciu miesięcy od nowej prośby. Jeśli przed tym terminem narzędzie do sprawdzania adresów potwierdza, że adresu nie ma w Google, wygaśnięcie prośby niczego już nie zmieni. Sposób ręcznej kontroli opisuje też tekst o tym, jak sprawdzić, czy Google zaindeksował stronę.
Co zrobić, gdy adres mimo wszystko wraca, i jakich błędów unikać?
Jeśli po wykonaniu całej procedury treść nadal pojawia się w Google, w pierwszej kolejności należy ustalić, pod jakim adresem. Bardzo często jest to kopia w obrębie tej samej witryny: strona kategorii z fragmentem tekstu, wynik wewnętrznej wyszukiwarki, archiwum autora, wersja do druku albo plik w katalogu z multimediami. Każdy taki adres wymaga własnej trwałej zmiany i własnej prośby. Dokumentacja przypomina, że ta sama treść bywa dostępna pod kilkoma adresami i usunięcie jednego nie usuwa pozostałych.
Inaczej wygląda sprawa, gdy treść została skopiowana na cudzą witrynę. Narzędzie „Usunięcia” działa wyłącznie dla usług, których jest się właścicielem, więc tutaj nie pomoże. Jeżeli obca strona została już zmieniona lub usunięta, a Google wciąż pokazuje stary zapis, właściwe jest narzędzie do odświeżania nieaktualnej treści, z którego można korzystać bez praw do witryny. Jeżeli treść nadal tam widnieje, pozostaje kontakt z administratorem tamtej witryny, a w przypadku danych osobowych także osobne formularze Google. Podobnie jest z innymi wyszukiwarkami: mają własne zasady i własne panele, a działania w Search Console nie mają na nie wpływu.
Błędy, które widuję najczęściej, dają się sprowadzić do kilku. Pierwszy to ponawianie prośby co pół roku zamiast wprowadzenia trwałej zmiany, co kończy się powrotem strony przy pierwszym przeoczeniu terminu. Drugi to łączenie tagu noindex z zakazem w pliku robots.txt. Trzeci to przekierowanie usuniętego adresu na stronę główną w nadziei, że sprawa się zamknie: przekierowanie nie jest usunięciem i bywa odczytywane jako pozorny błąd 404. Czwarty to użycie narzędzia do porządkowania wersji z www i bez www, przed czym pomoc ostrzega, bo może to ukryć wszystkie wersje adresu naraz. Piąty to zdjęcie blokady po kilku tygodniach, gdy strona zniknęła z wyników. Blokada ma zostać tak długo, jak długo strona ma być niewidoczna.
Najczęstsze pytania
Czy da się przedłużyć tymczasowe usunięcie, zanim wygaśnie?
Narzędzie nie ma funkcji przedłużania. Po wygaśnięciu można złożyć nową prośbę dla tego samego adresu i zyskać kolejne około 6 miesięcy, jednak pomoc Search Console wyraźnie wskazuje, że służy ono tylko do usuwania tymczasowego. Ponawianie próśb jest rozwiązaniem zawodnym, bo wystarczy jedno przeoczenie terminu, żeby strona wróciła. Trwały efekt daje wyłącznie zmiana na samej witrynie: usunięcie strony, hasło albo tag noindex.
Ile trzeba czekać, aż Google odczyta tag noindex lub kod 404?
Dokumentacja nie podaje jednego terminu. Zastrzega, że zależnie od znaczenia strony w internecie może minąć nawet kilka miesięcy, zanim robot odwiedzi ją ponownie. Dlatego po wprowadzeniu trwałej zmiany składa się nową prośbę o tymczasowe usunięcie, która ukrywa adres zwykle w ciągu doby i obowiązuje przez około 6 miesięcy. Ten okres zazwyczaj wystarcza, żeby robot odnotował zmianę, co należy potwierdzić narzędziem do sprawdzania adresów URL.
Czy kod 410 działa szybciej niż 404?
Dokumentacja Google dotycząca kodów stanu HTTP podaje, że wszystkie błędy z grupy 4xx, z wyjątkiem kodu 429, są traktowane tak samo: robot przekazuje dalej informację, że treść nie istnieje, a zindeksowany wcześniej adres jest usuwany z indeksu. Oba kody wymienia też pomoc Search Console jako równorzędne sposoby trwałego usunięcia. Wybór między nimi nie ma więc dla wyniku większego znaczenia. Ważne, żeby serwer nie zwracał kodu 200 ani przekierowania.
Czy po usunięciu strony Google przestanie odwiedzać jej adres?
Nie od razu. Pomoc Search Console wyjaśnia, że robot prawdopodobnie będzie jeszcze przez jakiś czas sprawdzał adres zwracający błąd 404 i nie da się nakazać mu, żeby trwale o nim zapomniał, choć odwiedziny stają się coraz rzadsze. Takie wizyty nie oznaczają, że strona wróciła do wyników. Adres może też pojawiać się w raporcie „Indeksowanie stron” w wierszu z błędami 404, co przy stronie usuniętej celowo jest stanem prawidłowym i nie wymaga naprawy.
Czy wystarczy usunąć link do strony z menu i z mapy witryny?
Nie wystarczy. Strona, do której nic nie prowadzi, nadal istnieje pod swoim adresem, a Google ten adres już zna i będzie go odwiedzać. Dokumentacja wskazuje, że wyszukiwarka może indeksować każdy znaleziony adres, chyba że na stronie znajduje się reguła noindex, a link do niej może umieścić dowolna obca witryna. Usunięcie adresu z mapy witryny i z nawigacji jest rozsądnym uzupełnieniem porządków, ale nie zastępuje żadnej z trzech trwałych dróg.
Co zrobić, gdy w wynikach wraca nie cała strona, lecz stary opis pod tytułem?
Jeśli strona ma pozostać w Google, a nieaktualny jest tylko fragment wyświetlany pod tytułem, właściwa jest prośba typu „Wyczyść krótki opis w wyszukiwarce”, dostępna w tym samym oknie co tymczasowe usunięcie. Według pomocy fragment znika z wyników do czasu ponownego zindeksowania strony, a potem jest tworzony na podstawie nowej treści. Warunkiem jest wcześniejsze usunięcie niechcianych informacji z samej strony, inaczej wrócą przy kolejnej wizycie robota.
Czy osoba z uprawnieniami użytkownika może złożyć prośbę o usunięcie?
Pomoc Search Console podaje, że z narzędzia do usuwania korzysta właściciel usługi, czyli osoba mająca w Search Console uprawnienia właściciela dla danej witryny. Jeśli narzędzie nie pozwala złożyć prośby, należy ustalić, jaką rolę ma dane konto w tej usłudze, i w razie potrzeby poprosić właściciela o złożenie prośby albo o nadanie wyższych uprawnień. Osoby bez dostępu do witryny mogą skorzystać jedynie z narzędzia do odświeżania nieaktualnej treści.
Źródła
- Narzędzie do usuwania stron z wyników wyszukiwania oraz do generowania raportów SafeSearch, Pomoc Search Console
- Usuwanie informacji o witrynie z Google, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Plik robots.txt – wprowadzenie i przewodnik, Centrum wyszukiwarki Google
- Jak kody stanu HTTP wpływają na roboty Google, Infrastruktura indeksowania Google
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Raport Indeksowanie stron, Pomoc Search Console
- mod_alias – Apache HTTP Server Version 2.4, Dokumentacja serwera Apache
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zrozumiałe. Trwałe usunięcie strony z Google wymaga pracy w kilku miejscach naraz: w Search Console, w systemie strony, czasem w panelu hostingu i w plikach serwera, a pomyłka w jednym z nich kończy się powrotem adresu za kilka miesięcy. Chętnie przejmę tę sprawę w całości. Ustalę, które adresy wróciły do wyników i dlaczego, sprawdzę ich warianty oraz pliki, dobiorę właściwą drogę dla każdej strony, wprowadzę zmianę na witrynie, uporządkuję plik robots.txt, złożę nowe prośby i po kilku tygodniach potwierdzę w raportach, że adresów nie ma już w indeksie.
Wystarczy krótka wiadomość z adresem strony, która nie powinna być widoczna, i informacją, czy ma zniknąć całkowicie, czy tylko z wyszukiwarki. Można zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl. Odpowiem, co da się zrobić, ile to potrwa i czego będę potrzebować, żeby zacząć.