Kategoria z butami ma w sklepie jeden adres. Wystarczy jednak dołożyć filtr koloru, rozmiaru, marki i ceny, a do tego sortowanie, żeby z tej jednej kategorii powstały tysiące różnych adresów. Każdy z nich pokazuje niemal te same produkty, tylko w innym układzie. Klientowi to pomaga, natomiast robot Google widzi w tym nieskończony zbiór stron do odwiedzenia.
Skutki są dwa. Robot zużywa czas na adresy bez wartości i później dociera do nowych produktów, a w raportach Search Console rośnie liczba duplikatów i stron pominiętych. Zdarza się też, że w wynikach wyszukiwania pojawia się przypadkowa kombinacja filtrów zamiast właściwej kategorii.
Ta instrukcja jest przeznaczona dla właścicieli sklepów internetowych i osób, które opiekują się nimi od strony technicznej. Po lekturze będzie wiadomo, jak sprawdzić skalę problemu, jak zdecydować, które filtry mają być widoczne w Google, jak zablokować pozostałe i po czym poznać, że porządki przyniosły skutek.
Skąd bierze się tysiące adresów z jednej kategorii?
Filtry w sklepie, nazywane w dokumentacji Google nawigacją fasetową, najczęściej działają na parametrach adresu. Po znaku zapytania pojawia się nazwa cechy i jej wartość, na przykład /buty/?kolor=czarny&rozmiar=42. Każda zmiana wartości tworzy nowy adres, a każda kolejna cecha mnoży liczbę możliwych kombinacji.
Rachunek jest prosty. Dziesięć kolorów, piętnaście rozmiarów i dwadzieścia marek to już trzy tysiące kombinacji w jednej kategorii, zanim klient użyje sortowania albo suwaka ceny. Jeśli sklep pozwala zaznaczyć kilka wartości naraz, liczba adresów przestaje mieć praktyczną granicę.
Do tego dochodzą adresy, które różnią się tylko zapisem. Ten sam zestaw produktów bywa dostępny pod adresem z kolorem przed rozmiarem i z rozmiarem przed kolorem. Dla człowieka to jedna strona, dla robota dwie różne.
Google opisuje ten mechanizm wprost: adresy z filtrów wyglądają na nowe, a robot nie potrafi ocenić ich przydatności bez wcześniejszego pobrania. Dlatego odwiedza ich bardzo dużo, zanim uzna je za bezużyteczne. W tym czasie nowe produkty i zmienione opisy czekają w kolejce.
Które parametry tworzą najwięcej adresów?
Najwięcej zamieszania robią cztery grupy parametrów: filtry cech (kolor, rozmiar, marka, materiał), zakres ceny, sortowanie oraz liczba produktów na stronie. W sklepach na WooCommerce filtry cech mają zwykle nazwy zaczynające się od filter_, cena korzysta z min_price i max_price, a sortowanie z orderby. Inne platformy stosują własne nazwy, dlatego zawsze trzeba je odczytać z paska adresu własnego sklepu.
Osobną grupą są numery kolejnych stron listy produktów. To nie jest filtr i nie należy go blokować razem z filtrami, bo przez kolejne strony robot dociera do produktów. Zasady dla tej części sklepu opisałem w tekście o tym, jak poprawnie ustawić stronicowanie w kategorii sklepu.
Po czym rozpoznać, że filtry wymknęły się spod kontroli?
Najpewniejszym źródłem jest Google Search Console, czyli panel, w którym Google pokazuje, jak widzi witrynę. Dostęp do niego nie wymaga opłaty, potrzebne jest tylko potwierdzenie własności domeny. Sprawdzenie zajmuje kilkanaście minut i warto wykonać je w podanej kolejności.
- Po zalogowaniu do Search Console należy wybrać w menu po lewej stronie raport „Indeksowanie stron”.
- Na wykresie widać dwie liczby: strony zindeksowane i niezindeksowane. Sygnałem ostrzegawczym jest sytuacja, w której stron niezindeksowanych jest wielokrotnie więcej niż produktów i kategorii w sklepie.
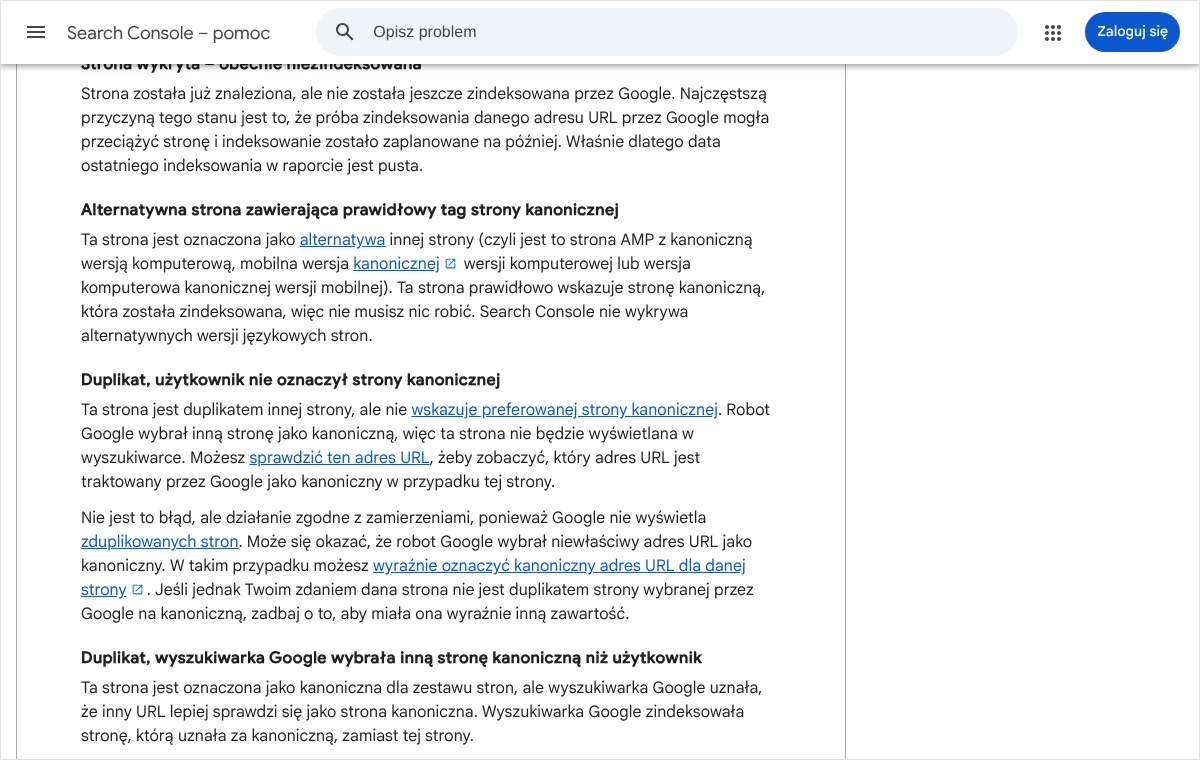
- Poniżej znajduje się tabela „Dlaczego strony nie są indeksowane”. Trzeba odszukać w niej wiersze „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej”, „Duplikat, użytkownik nie oznaczył strony kanonicznej”, „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” oraz „Strona zeskanowana, ale jeszcze niezindeksowana”.
- Kliknięcie wiersza otwiera listę przykładowych adresów. Jeśli większość z nich zawiera znak zapytania i nazwy filtrów, źródło problemu jest potwierdzone.
- Następnie należy kliknąć link „Wyświetl dane na temat zindeksowanych stron” i przejrzeć listę. Adresy z parametrami na tej liście oznaczają, że część kombinacji filtrów trafiła do indeksu.
- Na koniec trzeba wejść w „Ustawienia” i otworzyć raport „Statystyki indeksowania”. W tabelach z podziałem na odpowiedzi, typ pliku i cel można kliknąć dowolny wiersz, żeby zobaczyć przykładowe adresy, które robot ostatnio pobierał.
Raport „Statystyki indeksowania” jest dostępny tylko dla usług obejmujących całą domenę lub adres najwyższego poziomu. Lista przykładów nie jest pełna, pokazuje adresy reprezentatywne. To jednak wystarcza, żeby ocenić, czy robot zajmuje się produktami, czy kombinacjami filtrów.
Listy przykładowych adresów w raporcie „Indeksowanie stron” są ograniczone do tysiąca pozycji. W dużym sklepie pełniejszy obraz dają dzienniki serwera, czyli zapis wszystkich odwiedzin, w tym wizyt robotów. Dostęp do nich daje firma hostingowa, a analiza polega na policzeniu, jaka część wizyt Googlebota przypada na adresy ze znakiem zapytania.
Jak odróżnić zwykły stan od problemu?
Sam wiersz o alternatywnej stronie z prawidłowym tagiem kanonicznym nie jest błędem. Google podaje, że taki adres prawidłowo wskazuje wersję główną i nie wymaga działań. Powodem do pracy jest dopiero skala: dziesiątki tysięcy takich adresów przy kilkuset produktach oznaczają, że robot traci czas, choć indeks pozostaje czysty.
Poważniejsze są trzy objawy. Pierwszy to adresy z filtrami na liście stron zindeksowanych. Drugi to nowe produkty, które tygodniami pozostają w stanie „Strona wykryta – obecnie niezindeksowana”. Trzeci to wyniki wyszukiwania, w których zamiast kategorii pojawia się adres z parametrami. Jak sprawdzić pojedynczy adres, wyjaśniam osobno w tekście o tym, jak sprawdzić, czy Google zaindeksował stronę.
Skanowanie i indeksowanie to dwa różne problemy. Który zachodzi w sklepie?
Od odpowiedzi na to pytanie zależy wybór narzędzia. Skanowanie to odwiedziny robota, który pobiera stronę. Indeksowanie to decyzja, że strona trafia do bazy, z której powstają wyniki wyszukiwania. Polskie tłumaczenia dokumentacji Google często nazywają oba etapy indeksowaniem, co utrudnia lekturę, dlatego w tym tekście trzymam się rozróżnienia.
Jeżeli robot odwiedza tysiące adresów z filtrami, ale w indeksie ich nie ma, problemem jest skanowanie. Sklep traci uwagę robota i moc serwera. Właściwym narzędziem jest wtedy blokada w pliku robots.txt, bo tylko ona zatrzymuje same odwiedziny.
Jeżeli adresy z filtrami są już w indeksie, problemem jest indeksowanie. Blokada w robots.txt niczego wtedy nie usuwa. Trzeba najpierw wyprowadzić adresy z indeksu, a dopiero potem ograniczyć skanowanie. Kolejność jest tu ważna i wrócę do niej w dalszej części.
W praktyce w wielu sklepach występują oba problemy naraz. Wtedy plan dzieli się na dwa etapy: porządek w indeksie, a po nim blokada skanowania.
Które filtry zasługują na miejsce w Google, a które nie?
Zanim cokolwiek zostanie zablokowane, potrzebna jest decyzja biznesowa. Nie każdy filtr jest bezwartościowy. Jeśli klienci wpisują w wyszukiwarkę „czarne buty do biegania”, strona z takim właśnie zestawem produktów powinna być widoczna. Pytanie brzmi, czy ma to być przypadkowy adres z parametrami, czy przygotowana podstrona.
Radzę przyjąć prostą zasadę. Kombinacja, której ludzie faktycznie szukają, dostaje własną podstronę ze stałym, czytelnym adresem, własnym tytułem, nagłówkiem i krótkim opisem. Do takiej podstrony prowadzą zwykłe linki z menu lub z kategorii i trafia ona do mapy witryny. Wszystkie pozostałe kombinacje zostają wyłącznie narzędziem dla klienta.
Przy podziale pomagają cztery pytania:
- Czy ktoś wpisuje taką frazę w wyszukiwarkę? Liczbę wyszukiwań pokazuje Planer słów kluczowych Google.
- Czy pod tym filtrem jest stale dostępnych co najmniej kilka produktów? Strona z jednym produktem albo pusta nie ma wartości.
- Czy zestaw produktów różni się wyraźnie od kategorii głównej? Sortowanie od najtańszych niczego nie zmienia w ofercie, więc nigdy nie powinno być indeksowane.
- Czy da się napisać dla tej strony odrębny tytuł i opis? Jeśli nie, będzie duplikatem.
Z doświadczenia wynika, że na osobne podstrony zasługuje zwykle jedna cecha na kategorię, czasem dwie: marka, rodzaj, przeznaczenie albo kolor. Cena, rozmiar, sortowanie, liczba produktów na stronie i kombinacje trzech lub więcej cech prawie zawsze powinny pozostać poza indeksem. Ostateczna lista zależy od branży, dlatego trzeba ją oprzeć na danych o wyszukiwaniach, a nie na przeczuciu.
Wynikiem tego etapu ma być krótka tabela w arkuszu: nazwa parametru, przykład adresu i decyzja „indeksować jako podstronę” albo „zablokować”. Bez niej łatwo zablokować adresy, które przynoszą ruch.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: sprawdzę w Search Console i w dziennikach serwera, które adresy z filtrów pobiera robot, przygotuję listę parametrów do zablokowania i reguły gotowe do wdrożenia w sklepie.
Jak zablokować skanowanie filtrów w pliku robots.txt?
Plik robots.txt to zwykły plik tekstowy w głównym katalogu domeny, w którym właściciel wskazuje robotom, jakich adresów mają nie pobierać. Google zaleca tę metodę jako pierwszą dla filtrów, które nie mają być widoczne w wyszukiwarce. Uzasadnienie z dokumentacji jest krótkie: skanowanie produktów z filtrami zużywa zasoby serwera bez korzyści albo z niewielką korzyścią.
Uwaga na jedno ograniczenie. Blokada działa dobrze wtedy, gdy adresów z filtrami nie ma jeszcze w indeksie. Jeśli raport pokazał je na liście stron zindeksowanych, należy najpierw wykonać czynności z następnej sekcji, a do robots.txt wrócić później.
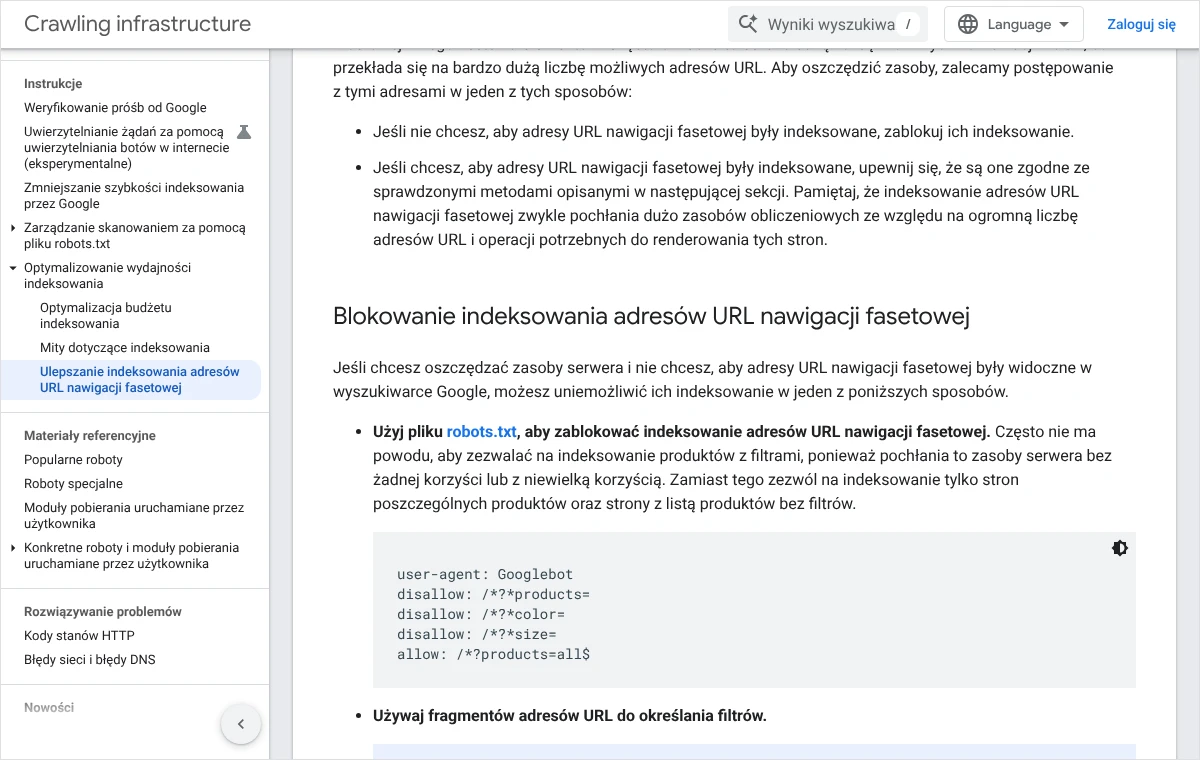
Reguły korzystają z dwóch znaków specjalnych. Gwiazdka zastępuje dowolny ciąg znaków, a znak dolara oznacza koniec adresu. Dla sklepu, w którym filtry cech zaczynają się od filter_, a cena i sortowanie mają typowe nazwy, zestaw reguł może wyglądać tak:
user-agent: *
disallow: /*?*filter_
disallow: /*?*min_price=
disallow: /*?*max_price=
disallow: /*?*orderby=
Każdy wiersz oznacza: nie pobierać adresu, w którym po znaku zapytania występuje podana nazwa parametru. Nazwy trzeba zastąpić tymi, które działają w konkretnym sklepie. W ścieżkach wielkość liter ma znaczenie, więc Kolor i kolor to dla robota dwa różne zapisy.
Kolejne czynności przy zmianie pliku
- Otwarcie w przeglądarce adresu domeny z dopiskiem
/robots.txti skopiowanie obecnej treści do osobnego pliku. To kopia na wypadek pomyłki. - Przepisanie z tabeli decyzji wszystkich parametrów oznaczonych jako „zablokować” i ułożenie dla każdego osobnego wiersza
disallow. - Sprawdzenie, czy w pliku istnieje osobna grupa reguł dla Googlebota. Jeśli tak, nowe wiersze trzeba dopisać także do niej, ponieważ robot stosuje tylko jedną, najlepiej dopasowaną grupę i pomija ogólną.
- Wprowadzenie zmian w pliku. W zależności od sklepu robi się to we wtyczce SEO, w panelu platformy albo bezpośrednio na serwerze.
- Ponowne otwarcie adresu
/robots.txtw przeglądarce i sprawdzenie, czy nowa treść jest widoczna. - W Search Console, w ustawieniach usługi, należy otworzyć raport dotyczący pliku robots.txt. Przy pliku trzeba wybrać „Więcej ustawień”, a następnie „Poproś o ponowne zindeksowanie”, żeby Google szybciej pobrał nową wersję.
- Sprawdzenie w narzędziu do sprawdzania adresów URL trzech adresów: kategorii bez filtrów, jednego produktu i jednego adresu z filtrem. Dwa pierwsze muszą pozostać dostępne dla robota, trzeci powinien być zablokowany.
Google przechowuje plik robots.txt w pamięci podręcznej zwykle do 24 godzin, więc bez prośby z kroku szóstego zmiana zaczyna działać z opóźnieniem. W raporcie widać kolumny „Stan pobierania”, „Sprawdzono” i „Problemy”. Stan „Pobrano” z aktualnym czasem sprawdzenia oznacza, że robot zna nowe reguły.
Czego nie wpisywać do robots.txt?
Najgroźniejszy błąd to reguła disallow: /*?, która blokuje każdy adres ze znakiem zapytania. W wielu sklepach, szczególnie na WordPressie, pliki stylów i skryptów mają w adresie parametr wersji. Po takiej blokadzie robot nie pobierze ich i zobaczy stronę bez wyglądu, co może pogorszyć ocenę całego sklepu. Zablokowane zostaną też kolejne strony list produktów, jeśli działają na parametrze.
Druga pułapka to blokada adresów, które miały pozostać widoczne. Jeżeli wybrana cecha ma własne podstrony, ale nadal działa na parametrze, trzeba dla niej dopisać wyjątek wierszem allow. Przy sprzecznych regułach Google stosuje tę o dłuższej ścieżce, a przy równych tę mniej restrykcyjną. Więcej o budowie pliku napisałem w tekście o tym, jak ustawić plik robots.txt.
Co zrobić z adresami filtrów, które już są w indeksie?
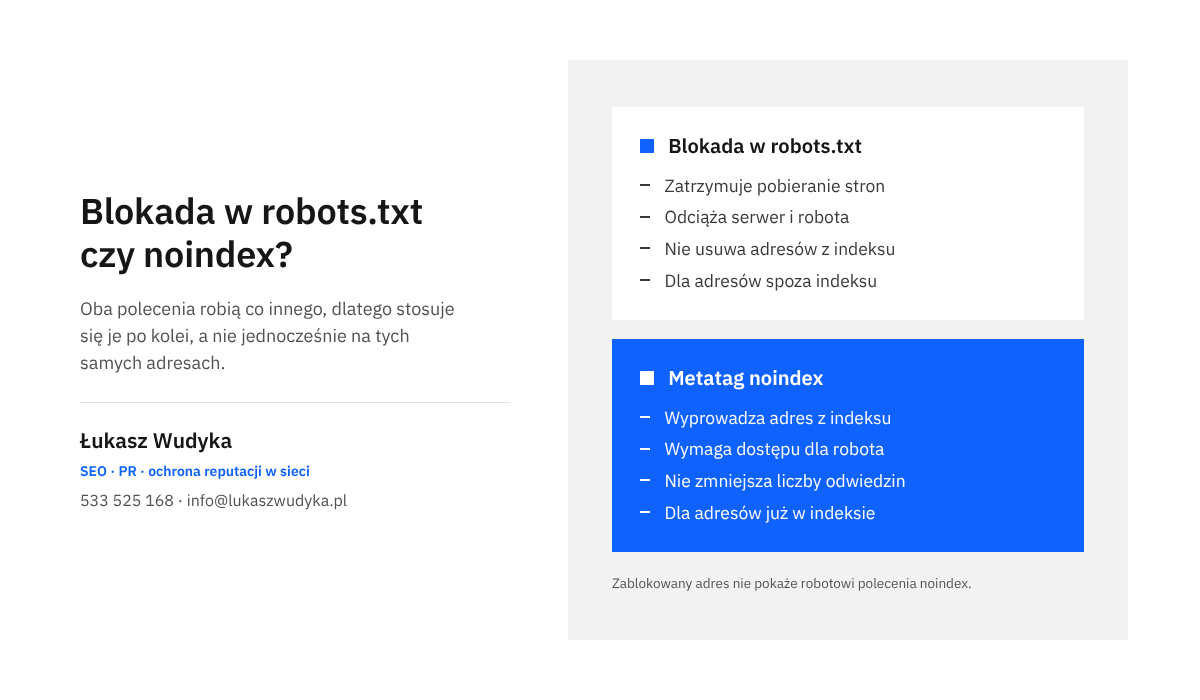
Tu najłatwiej o błąd, który utrwala problem na miesiące. Jeśli adres jest w indeksie i zostanie zablokowany w robots.txt, robot przestaje go pobierać. Nie zobaczy więc ani polecenia noindex, ani tagu kanonicznego. Adres może pozostać w indeksie, a w Search Console pojawi się ostrzeżenie „Strona zindeksowana, ale zablokowana przez plik robots.txt”.
Google potwierdza to w opisie raportu: sama blokada w robots.txt nie wyklucza strony z indeksu, a do pełnego wykluczenia służy noindex. Robot musi mieć możliwość pobrania strony, żeby to polecenie odczytać. Dlatego kolejność jest następująca:
- Jeżeli parametry filtrów są już zablokowane w robots.txt, blokadę trzeba tymczasowo zdjąć dla tych, które mają zniknąć z indeksu.
- Na stronach z filtrami należy ustawić w sekcji nagłówkowej metatag
<meta name="robots" content="noindex">. W większości sklepów da się to zrobić ustawieniem wtyczki SEO lub modułu filtrów, bez zmian w kodzie. - Ustawienie trzeba sprawdzić na kilku adresach z filtrami w narzędziu do sprawdzania adresów URL, klikając „Sprawdź URL wersji opublikowanej”. Wynik powinien pokazać, że indeksowanie jest wykluczone przez tag noindex.
- Te same testy należy powtórzyć dla kategorii bez filtrów i dla produktu. Na nich polecenia noindex być nie może.
- W raporcie „Indeksowanie stron” trzeba obserwować wiersz „URL zawiera tag „noindex””. Liczba adresów w tym wierszu powinna rosnąć, a liczba adresów z parametrami na liście stron zindeksowanych maleć.
- Dopiero gdy adresy z filtrami znikną z listy stron zindeksowanych, przychodzi czas na blokadę w robots.txt opisaną wcześniej.
Ten etap wymaga cierpliwości. Robot wraca do mało ważnych adresów rzadko, więc przy dużej liczbie kombinacji wyprowadzanie ich z indeksu trwa tygodnie, a czasem dłużej. Nie należy tego przyspieszać blokadą, bo skutek będzie odwrotny. Dlaczego oba polecenia użyte jednocześnie się znoszą, wyjaśniam w tekście o tym, dlaczego noindex i blokada w robots.txt nie działają razem.
Kiedy wystarczy tag kanoniczny?
Tag kanoniczny to wiersz w kodzie strony, który wskazuje jej wersję główną. Strona z filtrem koloru może wskazywać kategorię bez filtrów. Google podaje, że takie oznaczenie z czasem zmniejsza liczbę odwiedzin wersji z filtrami, ale zalicza je do metod mniej skutecznych na dłuższą metę niż robots.txt.
Powód jest prosty: tag kanoniczny to wskazówka, a nie polecenie. Jeśli strona z filtrem pokazuje wyraźnie inny zestaw produktów niż kategoria, Google może uznać ją za odrębną i wskazówkę pominąć. W raporcie widać to jako „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik”.
Uważam tag kanoniczny za dobre rozwiązanie dla sortowania i liczby produktów na stronie, gdzie zawartość jest ta sama, tylko w innym układzie. Dla filtrów, które zawężają ofertę, pewniejszy jest noindex, a po oczyszczeniu indeksu blokada skanowania. Na jednej stronie nie należy łączyć noindex z tagiem kanonicznym wskazującym inny adres, bo to dwa sprzeczne sygnały.
Czy atrybut nofollow w linkach filtrów pomaga?
Atrybut rel="nofollow" dodany do linków w panelu filtrów zniechęca robota do podążania za nimi. Dokumentacja Google stawia jednak warunek: atrybut musi mieć każdy link prowadzący do danego adresu. Wystarczy jeden zwykły link w banerze, w artykule na blogu albo na obcej stronie, żeby robot adres poznał. Traktuję więc nofollow jako uzupełnienie, nigdy jako jedyne zabezpieczenie.
Jak uporządkować adresy filtrów, które mają pozostać widoczne?
Jeżeli część filtrów ma być indeksowana pod adresami z parametrami lub ze ścieżką, Google podaje trzy wymagania techniczne. Ich spełnienie ogranicza liczbę zbędnych adresów, ale nie usuwa kosztu: więcej adresów do pobrania zawsze oznacza większe obciążenie serwera i wolniejsze wykrywanie nowości.
Pierwsze wymaganie dotyczy separatora. Parametry należy rozdzielać znakiem &. Przecinki, średniki i nawiasy kwadratowe są dla robotów trudne do rozpoznania jako granica między parametrami, przez co ten sam filtr bywa odczytywany jako wiele różnych adresów.
Drugie wymaganie dotyczy kolejności. Jeśli filtry są zapisane w ścieżce, na przykład /buty/czarne/skorzane/, ich układ musi być zawsze taki sam i żaden nie może się powtarzać. Sklep powinien sam ustawiać cechy w stałym porządku, niezależnie od tego, w jakiej kolejności klient je zaznaczył.
Trzecie wymaganie dotyczy pustych wyników. Gdy kombinacja filtrów nie zwraca żadnego produktu, strona powinna odpowiedzieć kodem 404 pod tym samym adresem. Nie należy przekierowywać na ogólną stronę błędu. To samo dotyczy powtórzonych filtrów, nielogicznych zestawień i numerów stron, które nie istnieją. Strona z napisem o braku produktów i kodem 200 trafia w raporcie do wiersza „Pozorny błąd 404”.
Kod odpowiedzi można sprawdzić w narzędziu do sprawdzania adresów URL albo w narzędziach dla programistów w przeglądarce, na karcie z żądaniami sieciowymi. Jeśli sklep nie potrafi zwracać kodu 404 dla pustych wyników, jest to zadanie dla programisty lub dostawcy platformy.
Jak ograniczyć powstawanie nowych adresów u źródła?
Blokady leczą skutki. Trwały porządek daje dopiero ograniczenie liczby adresów, które sklep sam tworzy i podsuwa robotom. Pomagają w tym cztery zmiany.
Pierwsza to filtry działające bez zmiany adresu albo zapisujące wybór po znaku #. Google zasadniczo nie bierze pod uwagę tej części adresu, więc filtrowanie nie tworzy wtedy nowych stron do pobrania. Wiele modułów filtrów ma taką opcję w ustawieniach, zwykle opisaną jako przeładowanie listy bez odświeżania strony. Warunek: wybrane wcześniej podstrony dla ważnych cech muszą mieć własne, zwykłe adresy.
Druga zmiana to porządek w mapie witryny. Powinny się w niej znajdować wyłącznie adresy, które mają być w indeksie: kategorie, produkty i przygotowane podstrony cech. Adres z parametrem filtra w mapie jest dla Google wyraźną zachętą do pobrania.
Trzecia zmiana dotyczy linków wewnętrznych. Menu, banery, wpisy na blogu i opisy kategorii nie powinny prowadzić do adresów z parametrami. Każdy taki link warto zamienić na adres kategorii albo podstrony cechy.
Czwarta zmiana to ograniczenie samych filtrów. Cecha, której nikt nie używa, tylko mnoży kombinacje. Przegląd statystyk sklepu pokaże, które filtry klienci faktycznie zaznaczają, a pozostałe można ukryć.
Po czym poznać, że porządki zadziałały, i co zrobić, gdy nie zadziałały?
Skutki widać w tych samych raportach, od których zaczęła się diagnoza. W „Statystykach indeksowania” przykładowe adresy powinny stopniowo zmieniać charakter: mniej adresów ze znakiem zapytania, więcej produktów i kategorii. W raporcie „Indeksowanie stron” rośnie wiersz „URL zablokowany przez plik robots.txt”, a maleją wiersze z duplikatami.
Po wprowadzeniu zmian można otworzyć w raporcie wiersz z wybranym problemem i kliknąć „Sprawdź poprawkę”. Google podaje, że weryfikacja zajmuje zazwyczaj do 2 tygodni, a czasem dłużej. O jej przebiegu informują wiadomości e-mail. Nie należy klikać przycisku ponownie przed zakończeniem weryfikacji.
Najważniejszy sprawdzian jest jednak inny: nowe produkty powinny szybciej przechodzić ze stanu wykrytych do zindeksowanych. Radzę zanotować stan raportów przed zmianami i porównywać go co tydzień przez dwa miesiące.
Liczba adresów nie maleje
Najczęstsza przyczyna to reguła, która nie pasuje do rzeczywistych adresów. Trzeba porównać nazwę parametru w robots.txt z paskiem adresu znak po znaku, łącznie z wielkością liter. Druga przyczyna to osobna grupa reguł dla Googlebota, do której nowe wiersze nie zostały dopisane. Trzecia to nieodświeżona kopia pliku po stronie Google, co widać w raporcie dotyczącym robots.txt po czasie ostatniego sprawdzenia.
Adresy są zablokowane, ale nadal widnieją w indeksie
To znak, że blokada została założona przed oczyszczeniem indeksu. Trzeba ją zdjąć, ustawić noindex i poczekać, aż adresy znikną z listy stron zindeksowanych. W pilnych przypadkach Search Console pozwala czasowo ukryć adresy w raporcie „Usunięcia”, lecz jest to rozwiązanie tymczasowe, które nie zastępuje noindex.
Spadł ruch z wyszukiwarki
Wtedy zablokowany został parametr, którego adresy przyciągały klientów. W raporcie „Skuteczność” należy przefiltrować strony po znaku zapytania i sprawdzić, które adresy miały kliknięcia przed zmianą. Dla nich trzeba cofnąć blokadę albo, lepiej, przygotować stałe podstrony i przekierować do nich stare adresy przekierowaniem 301.
Jakich błędów unikać przy porządkowaniu filtrów?
Większość kłopotów, z którymi właściciele sklepów zgłaszają się po nieudanych porządkach, wynika z kilku powtarzalnych pomyłek:
- Blokada wszystkich adresów ze znakiem zapytania, która odcina robotowi pliki stylów, skrypty i kolejne strony list produktów.
- Blokada w robots.txt założona na adresy, które są już w indeksie, przez co polecenie noindex nigdy nie zostaje odczytane.
- Polecenie noindex ustawione przez pomyłkę na kategoriach bez filtrów lub na produktach.
- Tag kanoniczny ze wszystkich kolejnych stron listy produktów skierowany na pierwszą stronę, co utrudnia robotowi dotarcie do dalszych produktów.
- Zmiany wprowadzone bez wcześniejszego sprawdzenia, które adresy z parametrami przynoszą ruch.
- Kilka zmian naraz, po których nie wiadomo, która wywołała skutek.
Bezpieczna praktyka polega na wprowadzaniu jednej zmiany, zapisaniu jej z opisem i odczekaniu co najmniej dwóch tygodni przed następną. Kopia poprzedniej wersji robots.txt i ustawień wtyczki pozwala cofnąć pomyłkę w kilka minut.
Najczęstsze pytania
Czy każdy sklep musi blokować filtry?
Nie. W małym sklepie z kilkudziesięcioma produktami i dwoma filtrami liczba kombinacji jest niewielka, a poprawny tag kanoniczny zwykle wystarcza. Blokada staje się potrzebna, gdy raporty pokazują, że adresów z parametrami jest wielokrotnie więcej niż produktów albo że nowe produkty długo czekają na zindeksowanie.
Czy blokada w robots.txt usuwa adresy z Google?
Nie. Zatrzymuje pobieranie stron, ale adres znany wcześniej lub linkowany z innych miejsc może pozostać w indeksie bez opisu. Do usunięcia służy polecenie noindex na stronie, którą robot może pobrać.
Jak długo trzeba czekać na efekty?
Zmiana w robots.txt zaczyna działać po odświeżeniu pliku przez Google, zwykle w ciągu doby. Na zmiany w raportach trzeba poczekać dłużej, bo Search Console pokazuje dane z opóźnieniem. Wyprowadzanie adresów z indeksu przez noindex trwa od kilku tygodni wzwyż, zależnie od liczby adresów i częstotliwości odwiedzin robota.
Czy w Search Console jest narzędzie do ustawiania parametrów adresów?
Takie narzędzie istniało, ale Google je wycofał. Obecnie parametrami zarządza się wyłącznie po stronie sklepu: plikiem robots.txt, poleceniem noindex, tagiem kanonicznym i budową samych adresów.
Czy reguły dla Google działają też na inne roboty?
Reguły w grupie oznaczonej gwiazdką dotyczą wszystkich robotów, które przestrzegają pliku robots.txt. Poszczególne wyszukiwarki mogą inaczej traktować znaki specjalne, dlatego po zmianie warto zajrzeć także do panelu Bing Webmaster Tools, jeśli sklep z niego korzysta.
Co z adresami wewnętrznej wyszukiwarki sklepu?
Wyniki wewnętrznej wyszukiwarki działają podobnie jak filtry: każde zapytanie klienta tworzy nowy adres. Powinny mieć polecenie noindex, a po oczyszczeniu indeksu blokadę skanowania dla własnego parametru, najczęściej litery s lub słowa search w adresie.
Czy filtry zapisane w ścieżce zamiast w parametrach rozwiązują problem?
Same z siebie nie. Liczba kombinacji pozostaje ta sama, zmienia się tylko zapis. Adresy ze ścieżką trudniej też objąć jedną regułą w robots.txt. Taki zapis sprawdza się dla kilku wybranych cech z własnymi podstronami, a reszta filtrów powinna pozostać na parametrach lub działać bez zmiany adresu.
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
To zrozumiałe. Porządkowanie filtrów wymaga cierpliwości, dostępu do kilku paneli i pewności, że jedna reguła nie odetnie sklepu od klientów. Mogę zająć się tym od początku do końca: sprawdzę raporty i dzienniki serwera, ustalę z właścicielem sklepu, które filtry mają być widoczne w Google, przygotuję reguły i ustawienia, dopilnuję wdrożenia, a potem przez kolejne tygodnie będę obserwować, czy robot wrócił do produktów.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres sklepu. Odpowiem, od czego zacząć i ile pracy wymaga dana sytuacja.



