W prawie każdym sklepie internetowym klient może ułożyć listę produktów według ceny, popularności lub daty dodania, a także zdecydować, ile pozycji ma się wyświetlać na jednej stronie. Każdy taki wybór dopisuje do adresu kategorii parametr, na przykład ?orderby=price albo ?per_page=48. Dla kupującego to wygoda, dla wyszukiwarki kolejny adres z tą samą ofertą, tylko inaczej ułożoną. Przy kilkudziesięciu kategoriach i kilku wariantach sortowania robią się z tego setki adresów, które niczego nowego nie wnoszą, a zajmują robota i zaśmiecają raporty.
Ta instrukcja jest przeznaczona dla właścicieli sklepów i osób, które opiekują się nimi od strony technicznej. Po lekturze będzie wiadomo, jak sprawdzić, czy Google rzeczywiście pobiera i indeksuje adresy z sortowaniem oraz liczbą produktów, którą z trzech metod porządkowania wybrać w danej sytuacji, jak ją wdrożyć bez szkody dla właściwych stron kategorii i po czym poznać, że zmiana przyniosła skutek. Opisuję wyłącznie sposoby wskazane w dokumentacji Google, razem z ich ograniczeniami, bo każda z tych metod działa inaczej i źle dobrana potrafi przynieść efekt odwrotny do zamierzonego.
Najważniejsze w skrócie
- Adresy z parametrem sortowania i liczby produktów pokazują tę samą ofertę co strona kategorii, dlatego Google traktuje je zwykle jako duplikaty.
- Dokumentacja Google wskazuje dwie drogi: znacznik noindex w sekcji head albo wyłączenie skanowania wzorców adresów w pliku robots.txt.
- Nie wolno łączyć obu metod na tym samym adresie, bo robot zablokowany w robots.txt nie odczyta znacznika noindex.
- Adresy już widoczne w wynikach najpierw dostają noindex, a blokadę w robots.txt wprowadza się dopiero po ich zniknięciu z indeksu.
- Skutek sprawdza się w Search Console: w raporcie „Indeksowanie stron” i w narzędziu do sprawdzania adresów URL.
Skąd biorą się adresy z sortowaniem i liczbą produktów i w czym przeszkadzają?
Strona kategorii ma jeden podstawowy adres, na przykład https://sklep.example/kategoria/buty/. Gdy klient zmienia kolejność listy, oprogramowanie sklepu nie tworzy nowej podstrony, tylko dopisuje do tego adresu parametr po znaku zapytania. Tak powstają adresy w rodzaju /kategoria/buty/?orderby=price lub /kategoria/buty/?per_page=48. Nazwy parametrów zależą od systemu i szablonu: w jednych sklepach będzie to „orderby”, w innych „order”, „sort”, „limit” albo „resultsPerPage”. Zasada pozostaje ta sama: zmienia się układ albo długość listy, a oferta, opis kategorii i tytuł strony zostają bez zmian.
Kłopot zaczyna się wtedy, gdy parametry się łączą. Sortowanie rosnąco i malejąco, trzy warianty liczby produktów, do tego numer strony listy i ewentualne filtry dają dla jednej kategorii dziesiątki kombinacji. Google opisuje to zjawisko w dokumentacji nawigacji fasetowej: adresy oparte na parametrach potrafią tworzyć praktycznie nieskończone przestrzenie adresów, a robot nie umie z góry ocenić, czy nowy adres jest przydatny, więc najpierw musi go pobrać. W efekcie odwiedza bardzo wiele adresów, zanim uzna je za bezużyteczne, i ma mniej czasu na nowe produkty oraz zmienione strony.
Drugi skutek dotyczy samych wyników wyszukiwania. Jeśli kilka adresów pokazuje tę samą treść, Google wybiera jeden z nich jako kanoniczny i tylko ten wyświetla. Zwykle wybiera dobrze, czyli czysty adres kategorii, ale nie ma takiego obowiązku. Zdarza się, że w wynikach pojawia się wersja posortowana od najdroższych albo adres z wymuszoną liczbą produktów, do którego nikt nie prowadzi w menu i którego tytuł nie różni się od tytułu kategorii. Podobny mechanizm, tylko na większą skalę, opisałem w tekście o tym, jak filtry w sklepie tworzą tysiące adresów. Sortowanie i liczba produktów to jego prostsza odmiana, bo tu żadna z wersji nie zasługuje na osobne miejsce w wynikach.
Jak sprawdzić, czy Google pobiera i indeksuje takie adresy?
Przed jakąkolwiek zmianą trzeba ustalić dwie rzeczy: jak dokładnie nazywają się parametry w danym sklepie i co Google już o tych adresach wie. Nazwy parametrów najłatwiej odczytać z paska adresu przeglądarki: wystarczy wejść na dowolną kategorię, zmienić kolejność sortowania, potem liczbę produktów na stronie i zanotować to, co pojawia się po znaku zapytania. Jeżeli adres w ogóle się nie zmienia, sklep obsługuje sortowanie bez przeładowania strony albo zapamiętuje wybór w pliku cookie, i wtedy problemu opisanego w tym tekście najpewniej nie ma.
Stan po stronie Google pokazuje Search Console. Najwięcej mówi raport „Indeksowanie stron”, a w nim tabela „Dlaczego strony nie są indeksowane”, w której każdy wiersz to jedna przyczyna z listą przykładowych adresów. Trzeba pamiętać o ograniczeniu opisanym w pomocy: lista przykładów obejmuje najwyżej 1000 pozycji, więc w dużym sklepie pokazuje próbkę, a nie komplet. Do oceny skali to wystarcza, do pełnego spisu adresów już nie.
- Otwarcie raportu W Search Console, w menu po lewej stronie, należy przejść do raportu „Indeksowanie stron” i przewinąć widok do tabeli „Dlaczego strony nie są indeksowane”.
- Przejrzenie przyczyn związanych z duplikatami Kolejno otwiera się wiersze „Duplikat, użytkownik nie oznaczył strony kanonicznej”, „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” oraz „Strona zeskanowana, ale jeszcze niezindeksowana” i szuka na listach adresów z zanotowanymi parametrami.
- Kontrola adresów zindeksowanych Pod wykresem należy kliknąć „Wyświetl dane na temat zindeksowanych stron” i sprawdzić, czy wśród przykładów nie ma adresów z sortowaniem lub liczbą produktów. To one są najpilniejsze, bo mogą wyświetlać się w wynikach.
- Zbadanie pojedynczego adresu Jeden przykładowy adres z parametrem wkleja się w pole wyszukiwania u góry Search Console. W sekcji „Indeksowanie stron” widać wtedy pola „Adres kanoniczny określony przez użytkownika” i „Adres kanoniczny wybrany przez Google”.
- Szybka próba w wyszukiwarce W Google wpisuje się zapytanie w postaci
site:sklep.example inurl:orderby, z własną domeną i własną nazwą parametru. Wynik jest przybliżony, ale pokazuje, czy takie adresy w ogóle trafiają do wyników.
Interpretacja jest prosta. Jeśli adresy z parametrami są wyłącznie na listach duplikatów i stron alternatywnych, a pole „Adres kanoniczny wybrany przez Google” wskazuje czysty adres kategorii, Google radzi sobie samodzielnie i pilnej potrzeby interwencji nie ma. Jeśli znajdują się wśród stron zindeksowanych, albo Google wybiera jako kanoniczną wersję z parametrem, trzeba działać. Trzeci przypadek to bardzo długie listy adresów z parametrami przy niewielkim sklepie: wtedy indeks jest czysty, ale robot traci czas, i celem porządków staje się ograniczenie samego skanowania.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejrzę raporty w Search Console, ustalę, które parametry sklepu tworzą zbędne adresy, dobiorę metodę do skali problemu i przygotuję gotowe ustawienia do wdrożenia razem z listą kontrolną do sprawdzenia skutku.
Noindex, robots.txt czy tag kanoniczny: którą metodę wybrać?
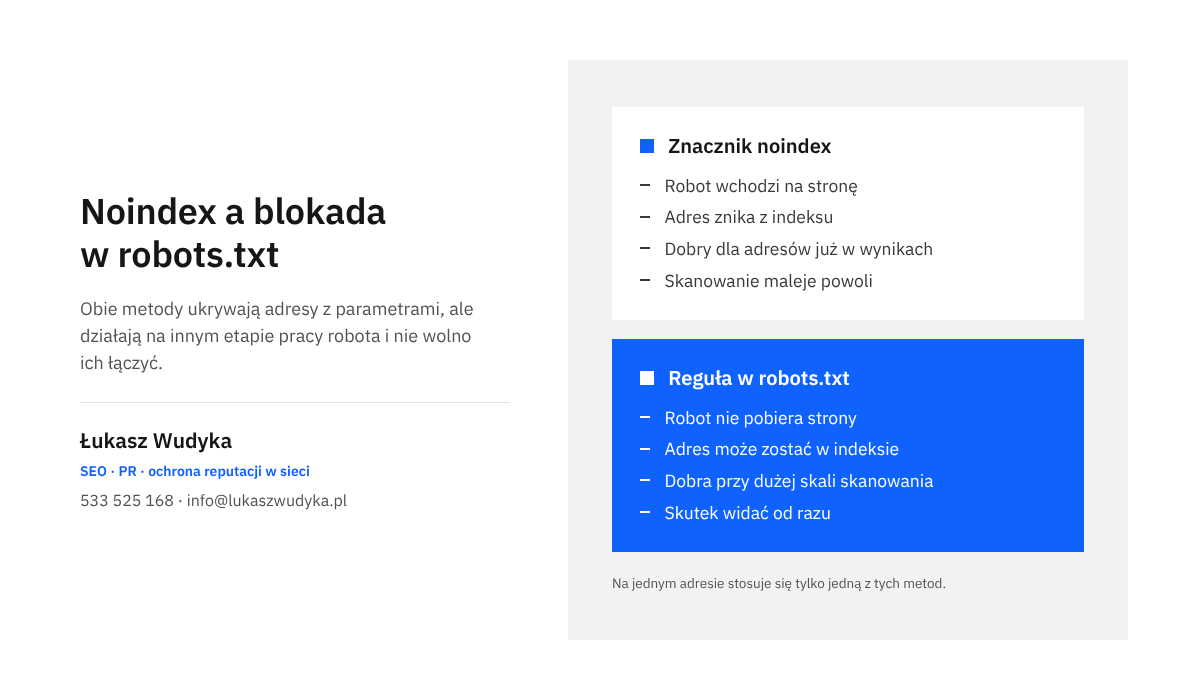
Google odnosi się do sortowania wprost w dokumentacji dotyczącej podziału list na strony w sklepach. Zaleca tam, aby zapobiec indeksowaniu odmian tej samej listy na jeden z dwóch sposobów: znacznikiem noindex w metatagu robots albo wyłączeniem skanowania określonych wzorców adresów w pliku robots.txt. To dwie różne czynności. Noindex pozwala robotowi wejść na stronę, ale zabrania umieszczania jej w indeksie. Reguła w robots.txt zabrania wchodzenia na stronę, lecz o indeksie nie mówi nic. Od tej różnicy zależy cały wybór.
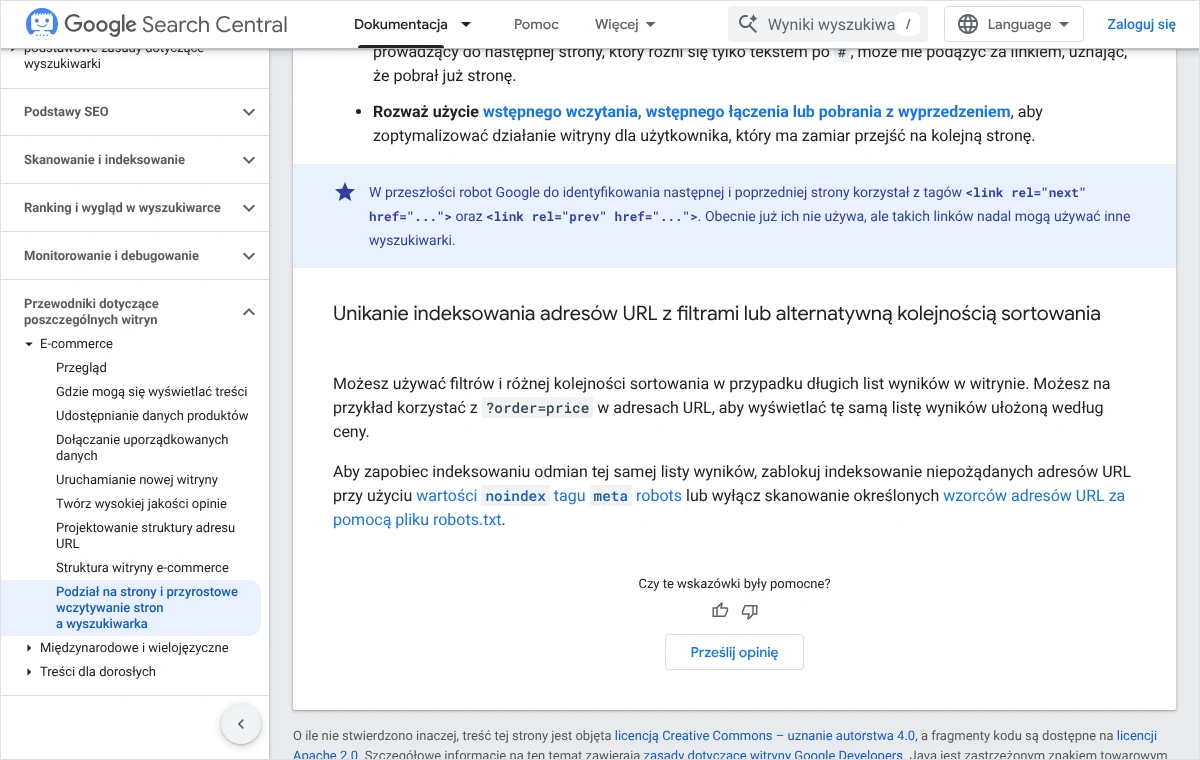
Noindex jest metodą pewną, gdy celem jest zniknięcie adresów z wyników. Google po kolejnym pobraniu strony odczytuje znacznik i usuwa adres z indeksu, nawet jeśli prowadzą do niego linki z innych witryn. Ceną jest to, że robot nadal musi takie adresy odwiedzać, więc oszczędność na skanowaniu pojawia się powoli. Plik robots.txt działa odwrotnie: natychmiast zatrzymuje pobieranie wskazanych adresów, ale nie gwarantuje ich nieobecności w wynikach. W pomocy Search Console opisano stan „Strona zindeksowana, ale zablokowana przez plik robots.txt”: adres może trafić do indeksu na podstawie samych linków, a wynik ma wtedy bardzo ograniczoną treść.
Trzecia możliwość to tag kanoniczny, czyli element link rel="canonical" wskazujący czysty adres kategorii. Dokumentacja nawigacji fasetowej zalicza go do sposobów, które z czasem mogą zmniejszyć skanowanie wersji niekanonicznych, ale zaznacza, że na dłuższą metę jest mniej skuteczny niż blokada w robots.txt. To wskazówka, a nie polecenie: Google bierze ją pod uwagę, lecz może wybrać inaczej. Uważam, że tag kanoniczny warto mieć zawsze jako tło, bo porządkuje sygnały, natomiast nie należy na nim poprzestawać, gdy adresy z parametrami już są w wynikach. Szczegóły jego ustawiania opisałem osobno w tekście o tym, jak wskazać Google właściwą wersję podstrony.
| Sytuacja w sklepie | Metoda | Uzasadnienie |
|---|---|---|
| Adresy z parametrami są widoczne w wynikach Google | Noindex | Robot musi móc wejść na stronę, żeby odczytać zakaz i usunąć adres z indeksu. |
| Adresów nie ma w wynikach, ale robot pobiera ich bardzo dużo | Robots.txt | Blokada od razu zatrzymuje skanowanie i oszczędza zasoby serwera. |
| Mały sklep, adresy tylko na listach duplikatów | Tag kanoniczny | Google samodzielnie wybiera adres kategorii, wystarczy potwierdzić ten wybór. |
| Brak dostępu do szablonu i ustawień indeksowania | Robots.txt | Plik da się zmienić bez ingerencji w kod sklepu, przy świadomości jego ograniczeń. |
Najważniejsza zasada brzmi: jedna metoda blokująca na jeden adres. Jeśli strona ma znacznik noindex i jednocześnie jest zablokowana w robots.txt, robot nigdy nie zobaczy znacznika i adres może pozostać w wynikach. Pomoc Search Console opisuje to dosłownie: przy stronie zablokowanej w robots.txt pole „Czy indeksowanie jest dozwolone” zawsze pokazuje wartość „Tak”, bo Google nie może wykryć dyrektywy noindex. Dlatego przy adresach już zindeksowanych obowiązuje kolejność: najpierw noindex, potem cierpliwe czekanie na zniknięcie adresów z indeksu, a dopiero na końcu, jeśli skala tego wymaga, blokada skanowania. Więcej o tej pułapce jest w tekście wyjaśniającym, dlaczego noindex i blokada w robots.txt jednocześnie nie działają.
Jak ustawić noindex na adresach z sortowaniem i liczbą produktów?
Znacznik noindex umieszcza się w sekcji head strony albo wysyła jako nagłówek odpowiedzi serwera. W pierwszym wariancie w kodzie adresu z parametrem ma się znaleźć wiersz <meta name="robots" content="noindex">, w drugim serwer dołącza do odpowiedzi nagłówek X-Robots-Tag: noindex. Oba zapisy mają dla Google to samo znaczenie. Istotne jest, aby znacznik pojawiał się wyłącznie wtedy, gdy w adresie występuje parametr sortowania lub liczby produktów, a nigdy na czystym adresie kategorii. Pomyłka w tym warunku to najgroźniejszy błąd całej operacji, bo usuwa z wyników właściwe strony sklepu.
Sposób wdrożenia zależy od oprogramowania. W wielu systemach sklepowych i wtyczkach SEO istnieje gotowe ustawienie dla adresów z parametrami albo dla widoków sortowania, a jego nazwa i położenie różnią się między narzędziami, dlatego nie podaję tu jednej ścieżki. Jeżeli takiego ustawienia nie ma, warunek dopisuje programista w szablonie kategorii lub w konfiguracji serwera. Zlecenie można sformułować krótko: na stronach list produktów, gdy w adresie występuje parametr sortowania lub liczby produktów na stronie, w sekcji head ma się pojawić metatag robots o wartości noindex, a na adresach bez tych parametrów nie. Do zlecenia należy dołączyć dokładne nazwy parametrów zanotowane wcześniej.
- Spisanie parametrów Na liście powinny się znaleźć wszystkie nazwy, które sklep dopisuje przy sortowaniu i zmianie liczby produktów, razem z przykładowym adresem dla każdej z nich.
- Kopia zapasowa Przed zmianą w szablonie lub konfiguracji serwera wykonuje się kopię plików, a najlepiej całego sklepu, żeby dało się wrócić do stanu wyjściowego.
- Wprowadzenie warunku W ustawieniach wtyczki albo w kodzie szablonu włącza się noindex dla adresów zawierających spisane parametry. Adresów kolejnych stron listy bez sortowania ta zmiana nie powinna obejmować.
- Kontrola w źródle strony W przeglądarce otwiera się adres z parametrem, wyświetla źródło strony i wyszukuje słowo „noindex”. To samo powtarza się na czystym adresie kategorii, gdzie tego słowa być nie może.
- Test w Search Console Adres z parametrem wkleja się do narzędzia do sprawdzania adresów URL i klika „Sprawdź URL wersji opublikowanej”. W sekcji dostępności pole „Czy indeksowanie jest dozwolone” ma pokazać wartość „Nie”.
- Sprawdzenie pliku robots.txt Na koniec trzeba upewnić się, że żadna reguła w robots.txt nie blokuje adresów z tymi parametrami. Jeśli blokuje, należy ją na czas wychodzenia adresów z indeksu wycofać.
Jak zablokować skanowanie parametrów w pliku robots.txt?
Blokada w robots.txt ma sens w dwóch sytuacjach: gdy adresów z parametrami nie ma w indeksie, a robot pobiera ich dużo, oraz jako drugi etap po tym, jak noindex zrobił swoje. Plik leży w katalogu głównym witryny, pod adresem w rodzaju https://sklep.example/robots.txt, i musi być zwykłym plikiem tekstowym w kodowaniu UTF-8. Dokumentacja Google zaleca edycję w prostym edytorze tekstu, a nie w procesorze tekstu, który potrafi dopisać niewidoczne znaki. W wielu sklepach plik jest tworzony przez system albo wtyczkę i edytuje się go w panelu, a nie na serwerze.
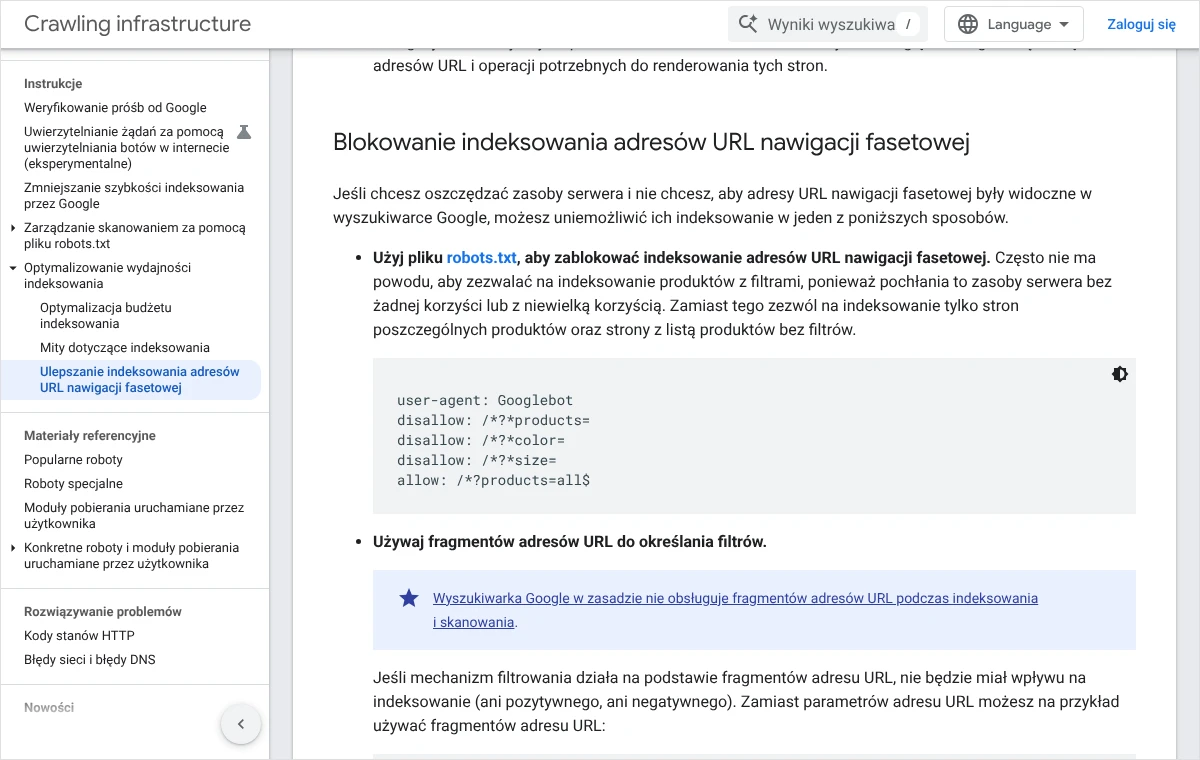
Reguły dla parametrów korzystają z gwiazdki, która zastępuje dowolny ciąg znaków. Google podaje w dokumentacji nawigacji fasetowej wzorzec, który da się zastosować wprost do sortowania i liczby produktów. Dla parametrów o nazwach „orderby” i „per_page” fragment pliku wygląda tak:
User-agent: *
Disallow: /*?*orderby=
Disallow: /*?*per_page=
Zapis /*?*orderby= oznacza: dowolna ścieżka, potem znak zapytania, potem dowolne znaki i nazwa parametru ze znakiem równości. Dzięki drugiej gwiazdce reguła działa niezależnie od tego, czy parametr stoi w adresie jako pierwszy, czy po innych. W regułach rozróżniana jest wielkość liter, więc nazwę parametru należy przepisać dokładnie tak, jak wygląda w adresie. Trzeba też sprawdzić, czy ta sama nazwa nie występuje w adresach, które mają pozostać dostępne. Jeśli sklep używa na przykład parametru „order” także w koszyku lub na koncie klienta, nic złego się nie stanie, ale jeśli jakaś ważna lista działa wyłącznie z parametrem, reguła odetnie ją od robota.
- Pobranie obecnej wersji Aktualną treść pliku otwiera się w przeglądarce pod adresem kończącym się na
/robots.txti zachowuje jej kopię w osobnym pliku tekstowym. - Dopisanie reguł W grupie rozpoczynającej się od wiersza „User-agent: *” dopisuje się po jednym wierszu „Disallow” dla każdego parametru. Istniejących reguł nie należy przy tej okazji zmieniać.
- Publikacja pliku Zmieniony plik umieszcza się w katalogu głównym witryny albo zatwierdza w panelu sklepu, po czym otwiera jego adres w oknie prywatnym przeglądarki, żeby potwierdzić, że widać nową treść.
- Test na dwóch adresach W narzędziu do sprawdzania adresów URL bada się adres z parametrem oraz czysty adres kategorii. Przy pierwszym pole „Czy skanowanie jest dozwolone” ma wskazywać blokadę, przy drugim zgodę.
- Kontrola raportu robots.txt W Search Console dostępny jest raport dotyczący pliku robots.txt, który pokazuje, jaką wersję pliku Google pobrał i czy nie znalazł w niej błędów składni.
Po przesłaniu pliku nie trzeba niczego zgłaszać: roboty Google same znajdują nową wersję i zaczynają z niej korzystać, choć przez pewien czas mogą posługiwać się kopią z pamięci podręcznej. Warto wiedzieć, czego ta metoda nie zrobi. Nie usunie z wyników adresów, które już tam są, a jedynie zamrozi ich stan. Nie przeniesie też na kategorię sygnałów z linków prowadzących do adresów z parametrami, bo robot nie zobaczy na zablokowanej stronie ani tagu kanonicznego, ani odnośników. Z tego powodu w małych i średnich sklepach radzę zaczynać od noindex, a po robots.txt sięgać dopiero wtedy, gdy skala skanowania naprawdę tego wymaga.
Co zmienić w samym sklepie, żeby takich adresów powstawało mniej?
Blokady leczą skutek. Równie ważne jest to, skąd Google dowiaduje się o adresach z parametrami. Robot podąża za zwykłymi odnośnikami, czyli za adresami w atrybucie href elementów a, i nie klika przycisków ani nie wybiera pozycji z list rozwijanych. Jeżeli sortowanie w sklepie jest listą rozwijaną, która przeładowuje stronę skryptem, robot trafia na adresy z parametrami rzadziej. Jeżeli każda opcja sortowania i każda liczba produktów jest zwykłym linkiem w kodzie, sklep sam podsuwa robotowi komplet kombinacji na każdej stronie kategorii. Zmiana sposobu wyświetlania tych kontrolek to praca dla programisty szablonu, ale często daje więcej niż same reguły.
Dokumentacja nawigacji fasetowej wymienia jeszcze dwa rozwiązania. Pierwsze to zapisywanie wyboru po znaku kratki, czyli we fragmencie adresu, na przykład /kategoria/buty/#orderby=price. Google zasadniczo nie uwzględnia fragmentów przy skanowaniu i indeksowaniu, więc taki mechanizm nie tworzy dla wyszukiwarki żadnych nowych adresów. Drugie to atrybut rel="nofollow" na linkach prowadzących do wersji posortowanych. Tu dokumentacja zastrzega, że sposób działa tylko wtedy, gdy atrybut ma każdy odnośnik do danego adresu, co w praktyce trudno utrzymać, dlatego traktuję go jako dodatek, a nie podstawę.
Trzeba również zadbać o spójność sygnałów, które wskazują adres główny. Dokumentacja dotycząca stron kanonicznych zaleca, aby linki wewnętrzne prowadziły do adresu kanonicznego, a mapa witryny zawierała wyłącznie adresy kanoniczne. W sklepie oznacza to trzy kontrole: menu, okruszki i banery mają kierować na czyste adresy kategorii, mapa witryny nie może zawierać adresów z parametrami, a tag kanoniczny na wersji posortowanej ma wskazywać adres bez parametru sortowania, zapisany jako adres bezwzględny, z protokołem i domeną. Przy stronicowaniu obowiązuje osobna zasada: druga i kolejne strony listy nie powinny wskazywać pierwszej strony jako kanonicznej. Opisałem to w tekście o tym, jak ustawić stronicowanie w kategorii sklepu.
Po czym poznać, że zmiana zadziałała, i co zrobić, gdy nie działa?
Skutek ocenia się w tych samych miejscach, w których stawiano diagnozę. Po wdrożeniu noindex adresy z parametrami powinny stopniowo przechodzić w raporcie „Indeksowanie stron” do wiersza „URL zawiera tag „noindex””, a znikać z listy stron zindeksowanych. Po wdrożeniu blokady w robots.txt zaczną się pojawiać w wierszu „URL zablokowany przez plik robots.txt”. Oba stany są w tej sytuacji zamierzone. Pomoc Search Console podkreśla, że niezindeksowanie adresu z uzasadnionej przyczyny, takiej jak oczekiwana reguła robots.txt lub znacznik noindex, nie jest problemem wymagającym naprawy.
| Objaw | Prawdopodobna przyczyna | Co zrobić |
|---|---|---|
| Adres z parametrem nadal jest w wynikach mimo noindex | Google nie pobrał strony ponownie albo blokuje ją robots.txt | Sprawdzić pole „Czy skanowanie jest dozwolone” i datę ostatniego skanowania |
| Stan „Strona zindeksowana, ale zablokowana przez plik robots.txt” | Blokada skanowania założona na adres obecny w indeksie | Zdjąć regułę, ustawić noindex, wrócić do blokady po zniknięciu adresu |
| Z wyników zniknęła właściwa kategoria | Noindex objął także adres bez parametrów | Poprawić warunek, zbadać adres i poprosić o zindeksowanie |
| Google wybiera jako kanoniczny adres z parametrem | Linki wewnętrzne lub mapa witryny wskazują wersję z parametrem | Ujednolicić linki, mapę witryny i tag kanoniczny |
| Reguła w robots.txt nie blokuje adresu | Inna wielkość liter albo inna nazwa parametru niż w adresie | Przepisać nazwę dokładnie z paska adresu i powtórzyć test |
Jeżeli po dłuższym czasie nic się nie zmienia, najczęściej zawodzi jedno z trzech ogniw. Pierwsze to pamięć podręczna sklepu lub sieci dostarczania treści, która podaje robotowi starą wersję strony bez znacznika, dlatego po wdrożeniu trzeba ją wyczyścić i powtórzyć test wersji opublikowanej. Drugie to warunek zależny od skryptu: jeśli noindex jest dopisywany dopiero w przeglądarce, a nie w kodzie wysyłanym przez serwer, Google może go odczytać z opóźnieniem albo wcale. Trzecie to nowe parametry, które pojawiły się po aktualizacji szablonu lub instalacji wtyczki i nie są objęte regułami. Z tego powodu spis parametrów warto powtarzać po każdej większej zmianie w sklepie.
Jakich błędów unikać przy ukrywaniu adresów z parametrami?
Najczęstszy błąd to zbyt szeroka reguła. Wiersz w rodzaju Disallow: /*? blokuje każdy adres ze znakiem zapytania, a więc także stronicowanie oparte na parametrze, wyszukiwarkę sklepu, a czasem pliki stylów i skryptów z numerem wersji w adresie. Robot, który nie może pobrać kolejnych stron listy, przestaje docierać do produktów z dalszych pozycji, a bez stylów gorzej rozumie wygląd strony. Reguły powinny wymieniać konkretne nazwy parametrów i nic ponad to. Po każdej zmianie pliku trzeba zbadać w Search Console co najmniej jedną kategorię, jedną kolejną stronę listy i jeden produkt.
Drugi błąd to wpisanie zakazu indeksowania do pliku robots.txt. Google nie obsługuje reguły noindex umieszczonej w tym pliku, więc taki wiersz nie ma żadnego skutku, a daje złudne poczucie, że sprawa jest załatwiona. Trzeci błąd to sprzeczne sygnały: tag kanoniczny wskazujący kategorię, noindex na tej samej stronie, a do tego adres z parametrem w mapie witryny. Dokumentacja odradza używanie noindex jako sposobu wyboru strony kanonicznej, dlatego trzeba zdecydować, o co chodzi. Jeśli adres ma zniknąć z wyników, decyduje noindex. Jeśli wystarczy, że Google potraktuje go jako wersję alternatywną, wystarcza tag kanoniczny i spójne linki.
Najczęstsze pytania
Czy adresy z sortowaniem obniżają pozycje sklepu w Google?
Same w sobie nie są karą ani błędem. Google rozpoznaje duplikaty, wybiera jedną wersję jako kanoniczną i pozostałych nie wyświetla, co pomoc Search Console opisuje jako działanie zgodne z zamierzeniami. Szkoda pojawia się pośrednio: robot poświęca czas na zbędne adresy i wolniej dociera do nowych produktów, a w wynikach może znaleźć się wersja posortowana zamiast właściwej kategorii. Im większy sklep i im więcej kombinacji parametrów, tym bardziej opłaca się to uporządkować.
Czy wystarczy sam tag kanoniczny wskazujący stronę kategorii?
W małym sklepie często tak, pod warunkiem że Google faktycznie wybiera czysty adres kategorii, co widać w polu „Adres kanoniczny wybrany przez Google”. Tag kanoniczny jest jednak wskazówką, a nie zakazem, i dokumentacja Google ocenia go jako mniej skuteczny w ograniczaniu skanowania niż blokada w robots.txt. Jeżeli adresy z parametrami są już w wynikach albo robot pobiera ich bardzo dużo, potrzebna jest mocniejsza metoda: noindex albo reguła w pliku robots.txt.
Czy narzędzie do usuwania adresów w Search Console przyspieszy porządki?
Nie jest to właściwa droga. Dokumentacja dotycząca stron kanonicznych ostrzega, że narzędzie do usuwania ukrywa w wyszukiwarce wszystkie wersje adresu, a więc także właściwą stronę kategorii. Adresy z parametrami wychodzą z indeksu po ponownym pobraniu strony ze znacznikiem noindex, w tempie zależnym od częstotliwości wizyt robota. Pojedyncze adresy można przyspieszyć prośbą o zindeksowanie, pamiętając o dziennym limicie takich próśb.
Czy blokować w ten sam sposób kolejne strony listy produktów?
Nie. Kolejne strony listy pełnią inną funkcję niż sortowanie: prowadzą robota do produktów, które nie mieszczą się na pierwszej stronie. Dokumentacja Google zaleca, aby każda strona sekwencji miała własny adres, była połączona zwykłymi linkami z następnymi i wskazywała samą siebie jako kanoniczną. Blokada stronicowania w robots.txt albo noindex na dalszych stronach może odciąć część asortymentu od wyszukiwarki, zwłaszcza gdy produkty nie są podlinkowane w inny sposób.
Co zrobić, gdy adres z parametrem ma linki z innych witryn?
W takiej sytuacji lepszy jest tag kanoniczny wskazujący czysty adres kategorii, ewentualnie z noindex, niż blokada w robots.txt. Robot, który nie może pobrać strony, nie zobaczy na niej ani tagu kanonicznego, ani odnośników, a sam adres może mimo blokady trafić do indeksu na podstawie linków z zewnątrz. Jeśli to możliwe, warto również poprosić właściciela witryny odsyłającej o zmianę odnośnika na adres bez parametrów.
Czy po wdrożeniu zmian trzeba klikać „Sprawdź poprawkę” w Search Console?
Nie jest to konieczne. Stany „URL zawiera tag „noindex”” i „URL zablokowany przez plik robots.txt” przy adresach z parametrami są skutkiem zamierzonym, więc nie ma czego zgłaszać do weryfikacji. Przycisk „Sprawdź poprawkę” przydaje się wtedy, gdy naprawiono rzeczywisty błąd, na przykład przypadkowy noindex na stronach kategorii. Weryfikacja trwa według pomocy Search Console zazwyczaj do 2 tygodni, a czasem dłużej.
Źródła
- Podział na strony, przyrostowe wczytywanie stron i ich wpływ na wyszukiwarkę Google, Centrum wyszukiwarki Google
- Zarządzanie indeksowaniem adresów URL nawigacji fasetowej, Infrastruktura indeksowania Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Jak określić stronę kanoniczną za pomocą rel=”canonical” i innych metod, Centrum wyszukiwarki Google
- Tworzenie i przesyłanie pliku robots.txt, Infrastruktura indeksowania Google
- Raport Indeksowanie stron, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Porządkowanie adresów z parametrami wymaga zajrzenia do Search Console, do szablonu sklepu i do pliku robots.txt, a pomyłka w jednym warunku potrafi usunąć z wyników całe kategorie. Chętnie przejmę tę sprawę w całości. Zaczynam od sprawdzenia, które parametry sklepu tworzą zbędne adresy i ile z nich Google już zna, potem dobieram metodę do skali problemu, przygotowuję dokładne ustawienia lub zlecenie dla programisty i sprawdzam wdrożenie na prawdziwych adresach. Na koniec przez kolejne tygodnie obserwuję raporty, żeby potwierdzić, że adresy rzeczywiście wychodzą z indeksu, a kategorie i produkty pozostają widoczne.
Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres sklepu. Odpowiem, co widać w wynikach Google i w jakiej kolejności najlepiej to uporządkować, a decyzja o dalszych krokach pozostaje po stronie właściciela sklepu.



