Właściciel strony przesyła mapę witryny w Search Console, wraca po kilku dniach i w kolumnie „Stan” widzi czerwony napis „Nie udało się pobrać”. Sam komunikat mówi niewiele: Google próbował sięgnąć po plik i go nie dostał, ale nie wyjaśnia dlaczego. Przyczyn może być kilka i każda wymaga innej naprawy, od poprawienia jednej litery w adresie, przez usunięcie reguły w pliku robots.txt, po rozmowę z firmą hostingową o zaporze, która odrzuca roboty. Zgadywanie i wielokrotne przesyłanie tej samej mapy niczego nie przyspiesza, dlatego lepiej przejść przez przyczyny w ustalonej kolejności.
Ta instrukcja jest przeznaczona dla osób, które prowadzą firmę i same zaglądają do Search Console, a także dla tych, którzy chcą wiedzieć, o co poprosić wykonawcę strony. Po lekturze czytelnik będzie umiał odczytać szczegóły błędu w raporcie „Mapy witryn”, potwierdzić przyczynę w narzędziu do sprawdzania adresów URL, usunąć każdą z typowych blokad i poprawnie przesłać mapę jeszcze raz. Opisuję też, po czym poznać, że naprawa zadziałała, ile trzeba poczekać i co zrobić, gdy stan mimo poprawek się nie zmienia.
Najważniejsze w skrócie
- Stan „Nie udało się pobrać” oznacza, że robot Google nie otrzymał pliku mapy, a nie, że mapa ma błędy w środku.
- Dokumentacja Google wymienia pięć przyczyn: blokadę w robots.txt, ręczne działania, zły adres z błędem 404, ogólny błąd serwera i niskie zapotrzebowanie na indeksowanie.
- Przyczynę potwierdza test wersji opublikowanej w narzędziu do sprawdzania adresów URL, w sekcji „Dostępność strony”.
- Prawidłowy wynik testu to „Czy skanowanie jest dozwolone” o wartości „Tak” oraz „Pobranie strony” o wartości „Udało się”.
- Po kilku nieudanych próbach Google przestaje sięgać po mapę, więc po naprawie trzeba ją przesłać ponownie w raporcie „Mapy witryn”.
- Raport pokazuje tylko mapy należące do aktualnej usługi, dlatego pomyłka między http a https albo między adresem z www i bez www daje fałszywy obraz.
Co dokładnie oznacza stan „Nie udało się pobrać” i gdzie go szukać?
Raport „Mapy witryn” w Search Console pokazuje tabelę wszystkich map przesłanych przez ten raport lub przez interfejs API. Każdy wiersz zawiera adres mapy, jej typ, datę przesłania, datę ostatniego odczytu, stan oraz liczbę wykrytych stron. Kolumna „Stan” opisuje wynik ostatniej próby, a pomoc Search Console podaje trzy możliwe wartości. „Sukces” oznacza, że mapa została pobrana i odczytana bez błędów. Komunikat o błędach w mapie oznacza, że plik udało się pobrać, ale część wpisów jest wadliwa. „Nie udało się pobrać” oznacza, że Google w ogóle nie otrzymał pliku.
To rozróżnienie decyduje o kierunku poszukiwań. Przy stanie „Nie udało się pobrać” nie ma sensu poprawiać zawartości mapy, dat czy kolejności adresów, bo robot do treści pliku nawet nie dotarł. Problem leży wcześniej: w adresie, w regułach dostępu albo w odpowiedzi serwera. Dopiero gdy plik zacznie być pobierany, Google przechodzi do jego analizy i wtedy mogą pojawić się zupełnie inne komunikaty, na przykład o nieprawidłowym adresie URL albo o błędzie składni. Kolumna „Ostatni odczyt” jest widoczna tylko wtedy, gdy mapa została kiedykolwiek pobrana, więc pusta wartość w tym miejscu potwierdza, że plik nie dotarł do Google ani razu.
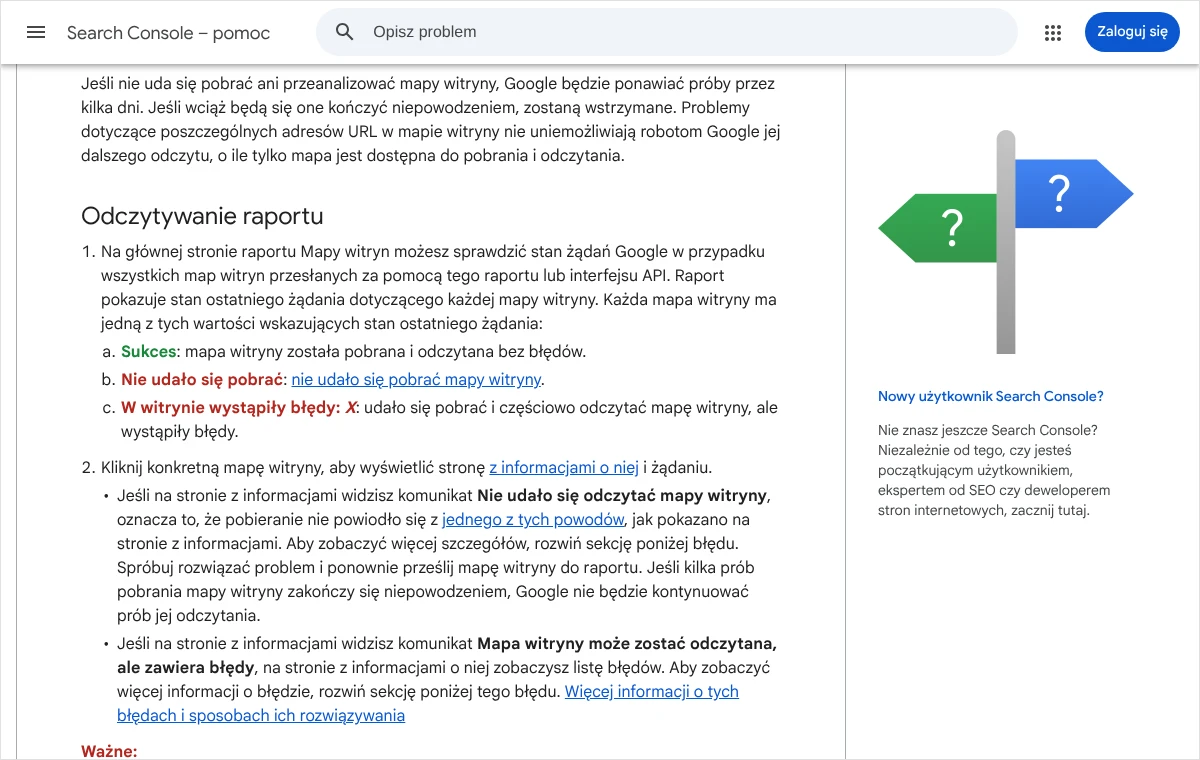
Po kliknięciu wiersza z mapą otwiera się strona z informacjami o niej i o ostatnim żądaniu. Jeśli widnieje tam komunikat „Nie udało się odczytać mapy witryny”, pod nim znajduje się nazwa błędu, którą można rozwinąć i przeczytać opis. To pierwsze miejsce, do którego należy zajrzeć, bo czasem przyczyna jest podana wprost. Bywa jednak, że opis jest ogólny i wtedy potrzebne są dalsze sprawdzenia opisane niżej. Jeśli mapy w ogóle jeszcze nie przesłano i dopiero trzeba to zrobić, pomocna będzie osobna instrukcja o tym, jak zgłosić mapę witryny w Google Search Console.
Jakie przyczyny nieudanego pobrania wymienia Google?
Pomoc Search Console podaje zamkniętą listę powodów, dla których robot nie pobiera mapy. Pierwszy to blokada w pliku robots.txt: Google przy pobieraniu map stosuje się do reguł z tego pliku, więc reguła zakazująca dostępu do adresu mapy zatrzymuje robota tak samo jak przy zwykłej podstronie. Drugi to ręczne działania podjęte wobec witryny. Dokumentacja mówi wprost, że mapy nie są odczytywane, dopóki ręczne działanie nie zostanie rozwiązane. Trzeci powód jest najprostszy i w praktyce bardzo częsty: pod podanym adresem nie ma pliku, czyli serwer odpowiada błędem 404.
Czwarta grupa to według dokumentacji „inny ogólny błąd”, na przykład brak dostępności serwera. Mieszczą się tu chwilowe awarie hostingu, zbyt długi czas odpowiedzi, zapory i wtyczki bezpieczeństwa odrzucające roboty, błędy certyfikatu oraz kłopoty z rozpoznawaniem domeny. Część takich błędów jest przejściowa i ustępuje bez żadnej ingerencji, dlatego Google radzi odczekać i sprawdzić, czy problem powtarza się przy kolejnych próbach. Piąty powód nie jest awarią: zapotrzebowanie na indeksowanie mapy może być niewielkie. Dotyczy to zwykle nowych lub mało rozbudowanych witryn, w których robot bywa rzadko.
| Przyczyna | Jak ją potwierdzić | Co naprawić |
|---|---|---|
| Zły adres mapy | Adres otwarty w przeglądarce pokazuje błąd 404 albo inną stronę zamiast pliku. | Ustalić właściwy adres w systemie strony i przesłać go od nowa. |
| Blokada w robots.txt | W teście wersji opublikowanej pole o zgodzie na skanowanie ma wartość inną niż „Tak”. | Usunąć lub zawęzić regułę, która obejmuje adres mapy. |
| Błąd serwera lub zapory | Pole „Pobranie strony” pokazuje niepowodzenie mimo zgody na skanowanie. | Odblokować robota Google na serwerze, w zaporze lub we wtyczce bezpieczeństwa. |
| Ręczne działania | Raport „Ręczne działania” pokazuje co najmniej jeden wpis. | Usunąć naruszenie i wysłać prośbę o sprawdzenie. |
| Niskie zapotrzebowanie | Test wersji opublikowanej kończy się powodzeniem, a stan nadal się nie zmienia. | Poczekać i rozwijać treść witryny, zamiast przesyłać mapę wiele razy. |
Jak sprawdzić, czy adres mapy jest prawidłowy i należy do właściwej usługi?
Search Console zapisuje dokładnie ten adres, który został wpisany przy przesyłaniu, i nie podąża za przekierowaniami w tabeli raportu. Literówka, brakujący ukośnik, stara nazwa pliku po zmianie wtyczki albo adres z poprzedniej wersji strony wystarczą, żeby robot trafiał w próżnię. Systemy zarządzania treścią i wtyczki do pozycjonowania tworzą mapy pod różnymi adresami, a po wymianie wtyczki dawny adres zwykle przestaje działać. Dlatego adresu nie należy zgadywać ani przepisywać z pamięci. Trzeba go odczytać z ustawień systemu lub wtyczki, która mapę tworzy.
- Skopiowanie adresu z raportu W raporcie „Mapy witryn” należy kliknąć wiersz z błędem i skopiować pełny adres mapy ze strony z informacjami, razem z początkiem https.
- Otwarcie adresu w oknie prywatnym Adres wkleja się do przeglądarki w trybie prywatnym, bez zalogowania do panelu strony. Prawidłowa mapa wyświetla listę adresów albo kod XML, a nie stronę błędu, stronę logowania czy stronę główną.
- Porównanie z ustawieniami strony W panelu systemu lub wtyczki tworzącej mapę należy odszukać jej aktualny adres i porównać go znak po znaku z tym, który widnieje w Search Console.
- Sprawdzenie wersji adresu Trzeba ustalić, czy mapa i wybrana usługa w Search Console mają ten sam początek adresu: ten sam protokół i tę samą postać z www albo bez www.
- Zapisanie wyniku Jeśli przeglądarka pokazuje błąd 404, przyczyna jest znaleziona. Jeśli plik otwiera się poprawnie, należy przejść do testu w narzędziu do sprawdzania adresów URL.
Czwarty krok bywa lekceważony, a tłumaczy wiele nieporozumień. Pomoc Search Console zaznacza, że raport pokazuje wyłącznie mapy należące do aktualnej usługi, i radzi sprawdzić, czy nie pomylono usług http i https albo adresów z www i bez www. Mapa przesłana w jednej usłudze nie jest widoczna w drugiej. Zdarza się więc, że właściciel ogląda stary wpis w usłudze, której adres od dawna przekierowuje na nową wersję strony. W takiej sytuacji najbezpieczniej jest pracować w usłudze odpowiadającej adresowi, pod którym strona faktycznie działa, i tam przesłać mapę z tym samym początkiem adresu.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejmę sprawę: ustalę, dlaczego Google nie pobiera mapy, usunę przyczynę po stronie witryny lub przygotuję gotową prośbę do firmy hostingowej i dopilnuję, żeby mapa wróciła do stanu „Sukces”.
Jak potwierdzić przyczynę w narzędziu do sprawdzania adresów URL?
Google sam wskazuje sposób na potwierdzenie błędu pobierania: adres mapy należy sprawdzić w narzędziu do sprawdzania adresów URL i uruchomić test wersji opublikowanej. Narzędzie pobiera wtedy plik w czasie rzeczywistym, tak jak robi to robot, i pokazuje, na którym etapie próba się zatrzymała. To najważniejsze badanie w całej procedurze, bo zastępuje domysły konkretną odpowiedzią. Mapa nie jest zwykłą podstroną i nie będzie zindeksowana jak artykuł, więc informacja, że adresu nie ma w Google, jest w tym przypadku normalna i nie należy się nią przejmować. Liczy się wyłącznie sekcja o dostępności.
- Wklejenie adresu mapy Adres skopiowany z raportu „Mapy witryn” wkleja się w pole wyszukiwania na górze Search Console i zatwierdza klawiszem Enter.
- Uruchomienie testu Po wyświetleniu wyniku należy kliknąć przycisk „Sprawdź URL wersji opublikowanej” i poczekać na zakończenie testu.
- Rozwinięcie sekcji o dostępności W wynikach testu trzeba rozwinąć sekcję „Dostępność strony”, w której znajdują się pola opisujące zgodę na skanowanie i pobranie pliku.
- Odczytanie pola o skanowaniu Pole „Czy skanowanie jest dozwolone” powinno mieć wartość „Tak”. Inna wartość oznacza, że adres mapy blokuje reguła w pliku robots.txt.
- Odczytanie pola o pobraniu Pole „Pobranie strony” powinno mieć wartość „Udało się”. Przy niepowodzeniu obok widnieje powód, który należy zapisać dosłownie, bo od niego zależy dalsza naprawa.
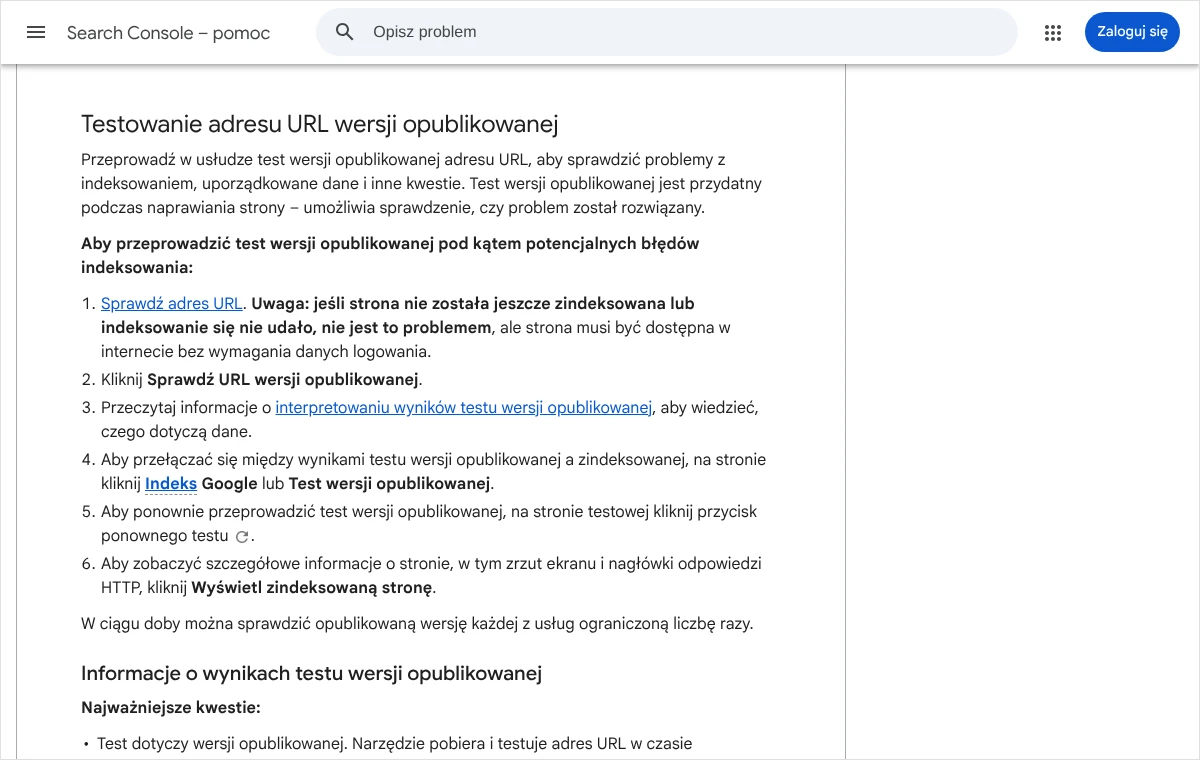
Wartości pola „Pobranie strony” są opisane w pomocy narzędzia. Poza wartością „Udało się” możliwe jest niepowodzenie z podaną przyczyną, „Błąd wewnętrzny”, który oznacza kłopot po stronie Google i wymaga jedynie ponowienia testu po chwili, oraz „Nie dotyczy”, gdy błąd nie pasuje do żadnej znanej kategorii. Jeśli problem obejmuje całą witrynę, narzędzie podaje jeden z opisanych powodów: serwer DNS nie odpowiada, nieznany host, brak połączenia z serwerem, nieprawidłowa odpowiedź serwera, nieprawidłowy certyfikat SSL, niedostępny plik robots.txt albo przekroczony limit obciążenia hosta. Każdy z nich kieruje do innej osoby: sprawy DNS do rejestratora domeny, a serwer i certyfikat do firmy hostingowej.
Trzeba pamiętać o dwóch ograniczeniach. Po pierwsze, liczba testów wersji opublikowanej w ciągu doby jest ograniczona dla każdej usługi, więc nie należy uruchamiać ich bez potrzeby po każdej drobnej zmianie. Po drugie, test pokazuje stan z chwili badania. Jeżeli serwer zawodzi tylko czasami, pojedynczy udany test nie wyklucza kłopotów z dostępnością w innych godzinach. Sposób czytania pozostałych pól tego narzędzia opisałem osobno w tekście o tym, jak czytać wynik narzędzia Sprawdzanie adresu URL.
Jak usunąć blokadę w robots.txt, na serwerze i w zabezpieczeniach?
Wynik testu dzieli dalszą pracę na trzy ścieżki. Gdy skanowanie nie jest dozwolone, poprawia się plik robots.txt. Gdy skanowanie jest dozwolone, a pobranie mimo to się nie udaje, przyczyny trzeba szukać w odpowiedzi serwera i w zabezpieczeniach. Gdy oba pola są w porządku, pozostaje sprawdzenie ręcznych działań i cierpliwość. Poniżej opisuję każdą ścieżkę osobno, razem ze sposobem potwierdzenia, że poprawka zadziałała. Przed każdą zmianą w plikach strony należy zachować kopię dotychczasowej wersji, żeby w razie pomyłki móc ją przywrócić.
Reguła w pliku robots.txt obejmuje adres mapy
Plik robots.txt znajduje się zawsze w katalogu głównym, pod adresem domeny z dopiskiem /robots.txt. Po jego otwarciu w przeglądarce należy poszukać wierszy zaczynających się od słowa Disallow i ocenić, czy któryś obejmuje ścieżkę mapy. Najczęstsze przypadki to ogólna blokada całej witryny pozostawiona po pracach nad stroną, czyli wiersz Disallow: /, blokada katalogu, w którym leży mapa, oraz reguła zatrzymująca wszystkie adresy z rozszerzeniem xml. Wystarczy usunąć taki wiersz albo zawęzić go tak, aby nie dotyczył adresu mapy. Samo wpisanie mapy do pliku wierszem Sitemap: https://example.com/sitemap.xml nie znosi blokady, bo przy przetwarzaniu reguł roboty ten wiersz pomijają.
Po zapisaniu zmian trzeba pamiętać, że Google przechowuje treść pliku robots.txt w pamięci podręcznej zwykle do 24 godzin. Robot może więc przez pewien czas stosować starą wersję. W Search Console, w części „Ustawienia”, znajduje się raport dotyczący pliku robots.txt, który pokazuje ostatnio pobraną wersję pliku, czas jej sprawdzenia i ewentualne problemy. Z tego samego miejsca, pod ikoną dodatkowych ustawień obok pliku, można wybrać polecenie „Poproś o ponowne zindeksowanie”, co dokumentacja zaleca właśnie po odblokowaniu ważnych adresów lub usunięciu błędu krytycznego. Szerzej o budowie tego pliku piszę w tekście o tym, jak ustawić plik robots.txt. Osobną sprawą jest sytuacja, w której sam plik robots.txt jest niedostępny i serwer odpowiada na jego żądanie błędem. Google wstrzymuje wtedy skanowanie witryny, a wraz z nim pobieranie mapy, więc naprawę zaczyna się od przywrócenia poprawnej odpowiedzi dla pliku robots.txt.
Serwer, zapora albo wtyczka bezpieczeństwa odrzuca robota
Jeśli skanowanie jest dozwolone, a pole „Pobranie strony” pokazuje niepowodzenie, plik istnieje, lecz robot go nie dostaje. Typowe źródła to zapora firmy hostingowej, usługa ochrony przed atakami, wtyczka bezpieczeństwa blokująca ruch automatyczny lub ruch z zagranicy, ochrona katalogu hasłem oraz przeciążony serwer. Pomoc Search Console przypomina, że mapa musi być dostępna dla robota Google bez żadnego logowania. Warto więc sprawdzić, czy strona nie działa w trybie prac serwisowych albo czy środowisko testowe z hasłem nie zostało przeniesione na adres produkcyjny razem z zabezpieczeniem.
Dodatkowych wskazówek dostarcza raport „Statystyki indeksowania”, dostępny w Search Console po kliknięciu „Ustawienia”. W części „Stan hosta” widać trzy kategorie: pobieranie pliku robots.txt, rozpoznawanie nazw DNS i połączenie z serwerem. Problem w którejkolwiek z nich oznacza, że kłopot dotyczy całej witryny, a mapa jest tylko jego najbardziej widocznym objawem. Z takim ustaleniem należy zwrócić się do firmy hostingowej. Prośba powinna być konkretna, na przykład: Proszę o sprawdzenie, czy zapora lub reguły bezpieczeństwa serwera nie odrzucają żądań robota Google do pliku mapy witryny, oraz o podanie kodu odpowiedzi serwera dla tych żądań z ostatnich dni.
Ryzykowną drogą jest wyłączenie całej ochrony albo dopuszczenie każdego ruchu, który w nagłówku przedstawia się jako Googlebot. Pod tę nazwę łatwo się podszyć, więc taka reguła otwiera drzwi także niechcianym automatom. Bezpieczniej jest zastosować metodę opisaną przez Google: sprawdzić odwrotny wpis DNS adresu, z którego przyszło żądanie, i upewnić się, że wskazuje on na domenę googlebot.com, google.com lub googleusercontent.com, albo oprzeć wyjątek w zaporze na listach adresów publikowanych przez Google. Więcej o tego typu blokadach zawiera tekst o komunikacie „Zablokowano z powodu zabronionego dostępu (403)”.
Wobec witryny podjęto ręczne działania
Ręczne działanie to decyzja pracownika Google, który uznał, że strony witryny naruszają zasady dotyczące spamu. Skutkiem jest ograniczenie widoczności części lub całości witryny w wynikach, a przy okazji także wstrzymanie odczytu map. Sprawdzenie zajmuje chwilę: w menu Search Console, w grupie dotyczącej bezpieczeństwa, znajduje się raport „Ręczne działania”. Brak problemów jest tam oznaczony zielonym znacznikiem i odpowiednim komunikatem. Jeśli raport pokazuje wpis, należy rozwinąć jego opis, ustalić, których stron dotyczy, i przeczytać wskazówki pod odnośnikiem „Więcej informacji”.
Naprawa polega na usunięciu naruszenia na wszystkich wskazanych stronach, a nie tylko na części z nich, i upewnieniu się, że Google ma do tych stron dostęp. Następnie w raporcie klika się „Poproś o sprawdzenie” i opisuje wprowadzone poprawki. Rozpatrzenie takiej prośby wymaga czasu i nie ma gwarancji pozytywnego wyniku za pierwszym razem, dlatego opis powinien być rzetelny i konkretny. Dopiero po wycofaniu ręcznego działania ma sens ponowne przesłanie mapy. Wcześniejsze próby nie zmienią stanu, niezależnie od tego, ile razy zostaną powtórzone.
Jak ponownie przesłać mapę i po czym poznać, że naprawa zadziałała?
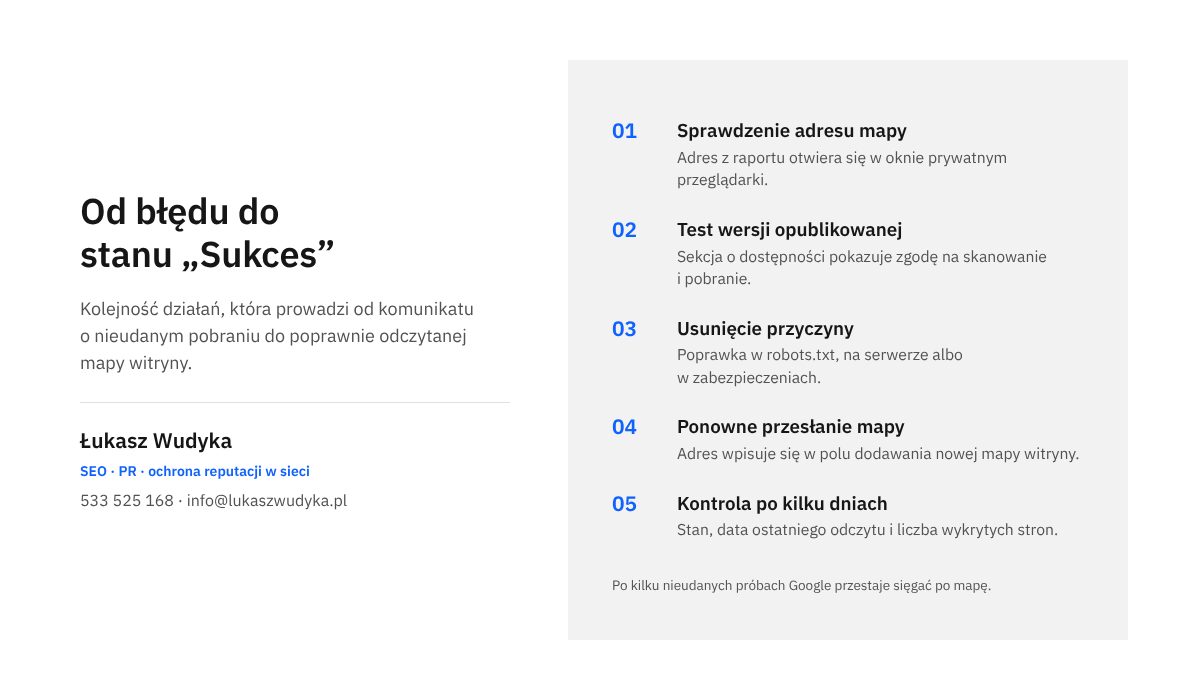
Dokumentacja opisuje zachowanie Google dość dokładnie. Jeśli mapy nie uda się pobrać, robot ponawia próby przez kilka dni. Gdy kolejne próby kończą się niepowodzeniem, zostają wstrzymane i Google przestaje sięgać po plik. Oznacza to, że sama naprawa po stronie witryny może nie wystarczyć: stary wpis w raporcie będzie nadal pokazywał stan ostatniej nieudanej próby. Dlatego po usunięciu przyczyny mapę przesyła się jeszcze raz, nową prośbą. Wcześniej warto powtórzyć test wersji opublikowanej i upewnić się, że oba pola w sekcji o dostępności mają już prawidłowe wartości.
- Powtórzenie testu Adres mapy należy ponownie sprawdzić w narzędziu do sprawdzania adresów URL i potwierdzić, że pole „Pobranie strony” ma wartość „Udało się”.
- Otwarcie raportu W menu Search Console wybiera się raport „Mapy witryn” w usłudze odpowiadającej adresowi, pod którym działa strona.
- Wpisanie adresu mapy W polu „Dodaj nową mapę witryny” wpisuje się lub wkleja sprawdzony adres, a następnie należy kliknąć „Prześlij”.
- Odczytanie nowego stanu Według dokumentacji mapa powinna zostać pobrana natychmiast, więc po odświeżeniu raportu w kolumnie „Stan” powinien pojawić się „Sukces”, a w kolumnie „Ostatni odczyt” bieżąca data.
- Kontrola po kilku dniach Po kilku dniach warto wrócić do raportu i sprawdzić, czy stan się utrzymuje oraz czy liczba w kolumnie „Wykryte strony” odpowiada wielkości witryny.
Jeśli w raporcie widnieje stary, błędny wpis z nieaktualnym adresem, można go usunąć. Należy kliknąć wiersz z mapą, na stronie szczegółów otworzyć menu dodatkowych opcji i wybrać „Usuń mapę witryny”. Usunięcie porządkuje raport, ale nie sprawia, że Google zapomina o mapie i jej adresach, o czym dokumentacja wyraźnie informuje. Nie ma też potrzeby usuwania wpisu przed ponownym przesłaniem tego samego adresu, bo liczy się nowa prośba. Usuwanie i dodawanie mapy na przemian nie przyspiesza pracy robota, a jedynie utrudnia późniejsze odczytanie historii.
Udane pobranie mapy nie jest równoznaczne z zaindeksowaniem stron. Google zaznacza, że zindeksowanie adresów z mapy może zająć trochę czasu, a część adresów może w ogóle nie trafić do indeksu. Stan „Sukces” oznacza tyle, że adresy z mapy trafiły do kolejki. To, co dzieje się z nimi dalej, pokazuje raport „Indeksowanie stron”, który można przefiltrować według mapy witryny, albo odnośnik „Zobacz stan w indeksie” na stronie szczegółów mapy. Jeśli po naprawie pojawi się komunikat o błędach w mapie, to dobry znak co do dostępności: plik jest już pobierany, a do poprawienia zostały konkretne wpisy wymienione na liście błędów.
Co zrobić, gdy stan się nie zmienia, i jakich błędów unikać?
Zdarza się, że plik otwiera się w przeglądarce, test wersji opublikowanej kończy się powodzeniem, raport „Ręczne działania” jest czysty, a w tabeli nadal widnieje „Nie udało się pobrać”. W takiej sytuacji najpierw należy upewnić się, że mapa została przesłana ponownie już po naprawie, bo stary wpis pokazuje stan ostatniej próby sprzed poprawek. Jeżeli nowa prośba również nie zmienia stanu, w grę wchodzi przyczyna przejściowa albo niewielkie zapotrzebowanie na indeksowanie, które dokumentacja wymienia wśród powodów. Wtedy rozsądniej jest odczekać kilka dni, niż przesyłać mapę kilkanaście razy z rzędu.
W okresie oczekiwania mapa nie jest jedyną drogą dotarcia Google do stron. Robot odkrywa adresy także dzięki odnośnikom między podstronami, a pojedyncze ważne adresy można zgłosić w narzędziu do sprawdzania adresów URL. Dokumentacja dopuszcza też wskazanie mapy wierszem Sitemap w pliku robots.txt, co jest przydatne zwłaszcza dla osób bez uprawnień właściciela usługi. Mapy odkryte tą drogą nie pojawiają się jednak w raporcie, więc nie da się w nim śledzić ich stanu. Gdy mapa jest bardzo duża, warto sprawdzić limity: pojedynczy plik może mieć najwyżej 50 MB po rozpakowaniu i 50 tysięcy adresów, a większe zbiory dzieli się na kilka map zebranych w pliku indeksu. Serwer, który długo tworzy ogromną mapę przy każdym żądaniu, potrafi nie zdążyć z odpowiedzią.
Najczęstsze błędy, które widzę przy tym komunikacie, mają wspólne źródło: działanie bez ustalenia przyczyny. Poniższe punkty zbierają te, które kosztują najwięcej czasu.
- Poprawianie zawartości mapy, choć robot nie pobrał pliku, nie zmienia stanu, bo problem dotyczy dostępu, a nie treści.
- Wielokrotne przesyłanie tego samego adresu bez usunięcia blokady daje za każdym razem ten sam wynik i zaciemnia historię w raporcie.
- Wyłączenie zapory lub wtyczki bezpieczeństwa na stałe naraża stronę na ataki, a wystarczy wyjątek dla zweryfikowanych adresów Google.
- Przesłanie mapy w usłudze o innym początku adresu niż działająca strona prowadzi do oglądania danych, które nie dotyczą właściwej wersji witryny.
- Ocenianie naprawy wyłącznie w przeglądarce jest mylące, ponieważ serwer może inaczej traktować człowieka, a inaczej robota.
Najczęstsze pytania
Czy stan „Nie udało się pobrać” oznacza, że strona zniknie z wyników Google?
Nie. Mapa witryny jest dla Google wskazówką, gdzie szukać adresów, a nie warunkiem obecności w wynikach. Dokumentacja podaje, że informacje odczytane wcześniej z mapy są zapamiętywane, a późniejsza nieudana próba nie powoduje ich zapomnienia. Strony już zindeksowane pozostają w indeksie, a robot odkrywa nowe adresy także dzięki odnośnikom. Komunikat warto jednak wyjaśnić, bo ta sama przyczyna, na przykład zapora odrzucająca robota, może utrudniać dostęp również do zwykłych podstron.
Mapa otwiera się w przeglądarce bez problemu. Dlaczego Google jej nie pobiera?
Przeglądarka i robot Google łączą się z serwerem z innych adresów i inaczej się przedstawiają. Zapora, usługa ochrony przed atakami albo wtyczka bezpieczeństwa może przepuszczać zwykłych odwiedzających i jednocześnie odrzucać ruch automatyczny. Możliwa jest też blokada w pliku robots.txt, której przeglądarka w ogóle nie bierze pod uwagę. Rozstrzyga test wersji opublikowanej w narzędziu do sprawdzania adresów URL, ponieważ wykonuje go sam Google i pokazuje wynik w sekcji „Dostępność strony”.
Jak długo Google ponawia próby pobrania mapy witryny?
Pomoc Search Console podaje, że po nieudanym pobraniu Google ponawia próby przez kilka dni, bez wskazania dokładnej liczby. Jeśli mapa wciąż jest niedostępna albo zawiera błędy krytyczne, próby zostają wstrzymane. Od tego momentu sama naprawa po stronie witryny nie zmieni wpisu w raporcie. Po usunięciu przyczyny mapę trzeba przesłać ponownie, nową prośbą w polu „Dodaj nową mapę witryny”, i dopiero wtedy raport pokaże wynik świeżej próby.
Czy wpisanie mapy do pliku robots.txt zastępuje przesłanie jej w Search Console?
Google traktuje wiersz Sitemap w pliku robots.txt jako pełnoprawny sposób wskazania mapy i odczyta ją przy kolejnym pobraniu tego pliku. Adres w tym wierszu musi być pełny, razem z protokołem i nazwą hosta. Różnica dotyczy kontroli: raport „Mapy witryn” pokazuje wyłącznie mapy przesłane przez ten raport lub przez interfejs API, więc mapy z pliku robots.txt nie mają tam swojego stanu. Dlatego radzę stosować oba sposoby jednocześnie.
Stan zmienił się na komunikat o błędach w mapie. Czy to gorzej niż wcześniej?
To krok naprzód. Taki komunikat oznacza, że plik jest już pobierany, a Google zatrzymał się na etapie analizy części wpisów. Adresy odczytane bez błędów trafiają do kolejki indeksowania, a lista problemów jest dostępna po kliknięciu mapy w tabeli. Typowe błędy analizy to nieprawidłowy adres URL, adresy z innej domeny lub z innym protokołem niż mapa, nieprawidłowy format daty i przekroczony rozmiar pliku. Każdy z nich ma w pomocy Search Console osobny opis z wyjaśnieniem.
Czy mała strona firmowa w ogóle potrzebuje mapy witryny?
Według pomocy Search Console mała witryna, czyli taka do 500 stron, w której do każdej podstrony da się dojść odnośnikami ze strony głównej, prawdopodobnie nie potrzebuje mapy ani tego raportu. Podobnie jest w usługach hostingu witryn, które same zarządzają mapą. Mimo to poprawnie działająca mapa ułatwia kontrolę, bo pokazuje, ile adresów Google wykrył. Jeśli mapa została już przesłana, lepiej doprowadzić ją do stanu „Sukces”, niż zostawiać błąd w raporcie.
Źródła
- Zarządzanie mapami witryn przy użyciu raportu Mapy witryn, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Przygotowywanie i przesyłanie mapy witryny, Centrum wyszukiwarki Google
- Jak Google interpretuje specyfikację pliku robots.txt, Centrum wyszukiwarki Google
- Raport dotyczący pliku robots.txt, Pomoc Search Console
- Raport Statystyki indeksowania, Pomoc Search Console
- Raport Ręczne działania, Pomoc Search Console
- Weryfikowanie żądań od robotów i modułów pobierania Google, Centrum wyszukiwarki Google
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Komunikat o mapie witryny potrafi zabrać cały wieczór, zwłaszcza gdy przyczyna leży na serwerze, do którego właściciel firmy nie zagląda na co dzień. Chętnie zajmę się tym w całości. Sprawdzę adres mapy i usługę w Search Console, wykonam test wersji opublikowanej, przejrzę plik robots.txt, raport o stanie hosta i raport ręcznych działań, a następnie usunę przyczynę albo przygotuję dokładną prośbę do firmy hostingowej i dopilnuję jej wykonania. Na koniec prześlę mapę ponownie i potwierdzę, że Google ją pobiera oraz że adresy trafiają do indeksowania.
Wystarczy krótka wiadomość z adresem strony i opisem tego, co widać w raporcie. Odpowiem, czego potrzebuję, żeby zacząć, i wyjaśnię prostymi słowami, co ustaliłem i co zostało zmienione, tak aby po zakończeniu pracy wszystko było zrozumiałe. Można zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl.



