Po zalogowaniu do Search Console wielu właścicieli firm widzi w raporcie o indeksowaniu szary słupek z liczbą stron, których nie ma w Google, a pod nim długą tabelę z powodami o technicznym brzmieniu. Część tych powodów oznacza prawdziwą usterkę, przez którą oferta nie pojawia się w wyszukiwarce. Większość opisuje jednak sytuacje całkowicie prawidłowe: stare adresy z przekierowaniem, kopie tej samej podstrony albo strony celowo ukryte przed wyszukiwarką. Kłopot polega na tym, że raport pokazuje jedne i drugie w tej samej tabeli i w tym samym kolorze.
Ta instrukcja jest przeznaczona dla osób, które prowadzą firmową stronę lub sklep i chcą samodzielnie ocenić, czy liczba niezindeksowanych stron jest powodem do niepokoju. Wyjaśnia, gdzie znajduje się raport, jak czytać kolumny tabeli z powodami, które wiersze można spokojnie zostawić, a które wymagają naprawy i w jakiej kolejności się nimi zająć. Po lekturze czytelnik będzie umiał sprawdzić pojedynczy adres, usunąć przyczynę blokady, zgłosić poprawkę do Google i rozpoznać, czy naprawa przyniosła skutek.
Najważniejsze w skrócie
- Raport otwiera się w Search Console z menu po lewej stronie: sekcja „Indeksowanie”, pozycja „Strony”, a w pomocy Google nosi on nazwę „Indeksowanie stron”.
- Stan „Nie zindeksowano” nie oznacza automatycznie błędu, ponieważ duplikaty, przekierowania i strony celowo zablokowane nie powinny trafiać do indeksu.
- Kolumna „Źródło” wskazuje, po czyjej stronie leży powód: naprawić da się tylko te pozycje, przy których widnieje wartość „Witryna”.
- Lista przykładowych adresów przy każdym powodzie jest ograniczona do 1000 wierszy, dlatego ważne podstrony trzeba sprawdzać osobno narzędziem do sprawdzania adresów URL.
- Po usunięciu wszystkich wystąpień problemu klika się „Sprawdź poprawkę”, a weryfikacja zajmuje zazwyczaj do 2 tygodni, choć bywa znacznie dłuższa.
Gdzie znaleźć raport i co pokazuje jego pierwsza strona?
Raport znajduje się w menu po lewej stronie Search Console, w sekcji „Indeksowanie”, pod pozycją „Strony”. W oficjalnej pomocy Google ten sam raport nazywa się „Indeksowanie stron”, dlatego obie nazwy oznaczają to samo miejsce. Na stronie podsumowania widać wykres oraz dwie liczby: strony zindeksowane, oznaczone kolorem zielonym, i strony niezindeksowane, oznaczone kolorem szarym. Pod wykresem znajduje się link „Wyświetl dane na temat zindeksowanych stron”, który prowadzi do historii liczby zindeksowanych adresów i ich przykładowej listy. Niżej umieszczono tabelę „Dlaczego strony nie są indeksowane”, a pod nią, jeśli Google ma takie uwagi, drugą tabelę z ostrzeżeniami, czyli problemami, które nie blokują indeksowania, ale utrudniają zrozumienie strony.
Nad wykresem działa filtr map witryn z trzema podstawowymi ustawieniami: „Wszystkie znane strony”, „Wszystkie przesłane strony” oraz „Tylko strony nieprzesłane”. Pierwsze, domyślne, obejmuje każdy adres, o którym Google wie, także stare, techniczne i przypadkowe. Drugie zawęża widok do adresów zgłoszonych w mapie witryny, czyli do tych, które właściciel sam uznał za ważne. To ustawienie jest najbardziej przydatne w codziennej pracy, bo oddziela istotne podstrony od całej reszty.
Google zaznacza w pomocy, że przy witrynach liczących mniej niż 500 stron raport zwykle nie jest potrzebny do codziennej kontroli. W takiej sytuacji wystarcza wyszukanie w Google własnej domeny z operatorem site:, na przykład site:example.com, oraz sprawdzenie kilku najważniejszych adresów pojedynczo. Do raportu warto zajrzeć wtedy, gdy ważnych podstron brakuje w wynikach, gdy wykres nagle się zmienia albo gdy Search Console przysyła wiadomość o nowym powodzie niezindeksowania. Na wykresie rozwijającej się witryny liczba zindeksowanych stron powinna rosnąć stopniowo. Gwałtowne spadki i skoki są sygnałem, że trzeba przejrzeć tabelę z powodami.
Jak czytać kolumny tabeli „Dlaczego strony nie są indeksowane”?
Każdy wiersz tabeli to jeden powód, a nie jedna strona. W wierszu podana jest nazwa przyczyny, jej źródło, stan weryfikacji, mały wykres zmian w czasie oraz liczba adresów, których dany powód dotyczy. Według pomocy Google tabela jest ułożona w kolejności od problemów uznanych za najważniejsze. Kliknięcie wiersza otwiera stronę ze szczegółami: wykres liczby stron z tym problemem oraz listę przykładowych adresów. Lista jest ograniczona do 1000 wierszy i nie musi zawierać wszystkich adresów, nawet gdy jest ich mniej.
Najwięcej mówi kolumna „Źródło”. Przyjmuje ona jedną z dwóch wartości i pokazuje, czy powód leży po stronie Google, czy po stronie witryny. Pomoc Search Console stwierdza wprost, że rozwiązywać można wyłącznie problemy, których źródłem jest „Witryna”. Wiersze ze źródłem po stronie Google opisują decyzje lub kolejkę samej wyszukiwarki i nie da się ich usunąć jedną zmianą w ustawieniach. Kolumna „Weryfikacja” informuje natomiast, czy właściciel prosił już o sprawdzenie poprawki i z jakim skutkiem. Google zaleca, aby w pierwszej kolejności zająć się pozycjami, w których weryfikacja ma stan „Niepowodzenie” lub „Nie rozpoczęto”, a źródłem jest „Witryna”.
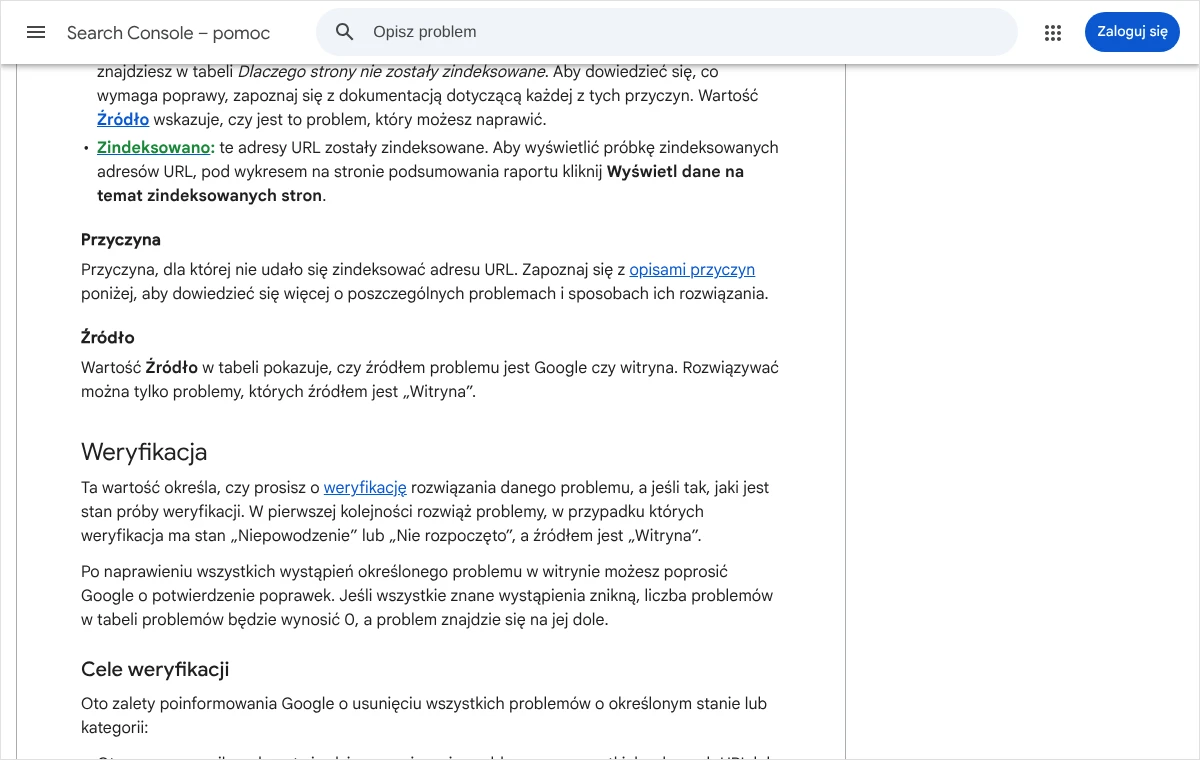
Przy lekturze tabeli pomaga prosta zasada: najpierw źródło, potem liczba stron, na końcu nazwa powodu. Wiersz ze źródłem „Witryna” i kilkoma adresami z oferty jest ważniejszy niż wiersz z setkami adresów technicznych, o których nikt nie wiedział. Mały wykres w wierszu pozwala ocenić, czy problem narasta, czy wygasa. Jeśli jego kształt pokrywa się ze spadkiem na głównym wykresie, najpewniej właśnie ten powód odpowiada za utratę zindeksowanych stron. Pomoc Google podaje dwie typowe przyczyny nagłych skoków: zmianę w szablonie strony, która wprowadziła nowy błąd, oraz mapę witryny zawierającą adresy zablokowane plikiem robots.txt, tagiem noindex albo wymogiem logowania.
Które powody zwykle nie wymagają żadnego działania?
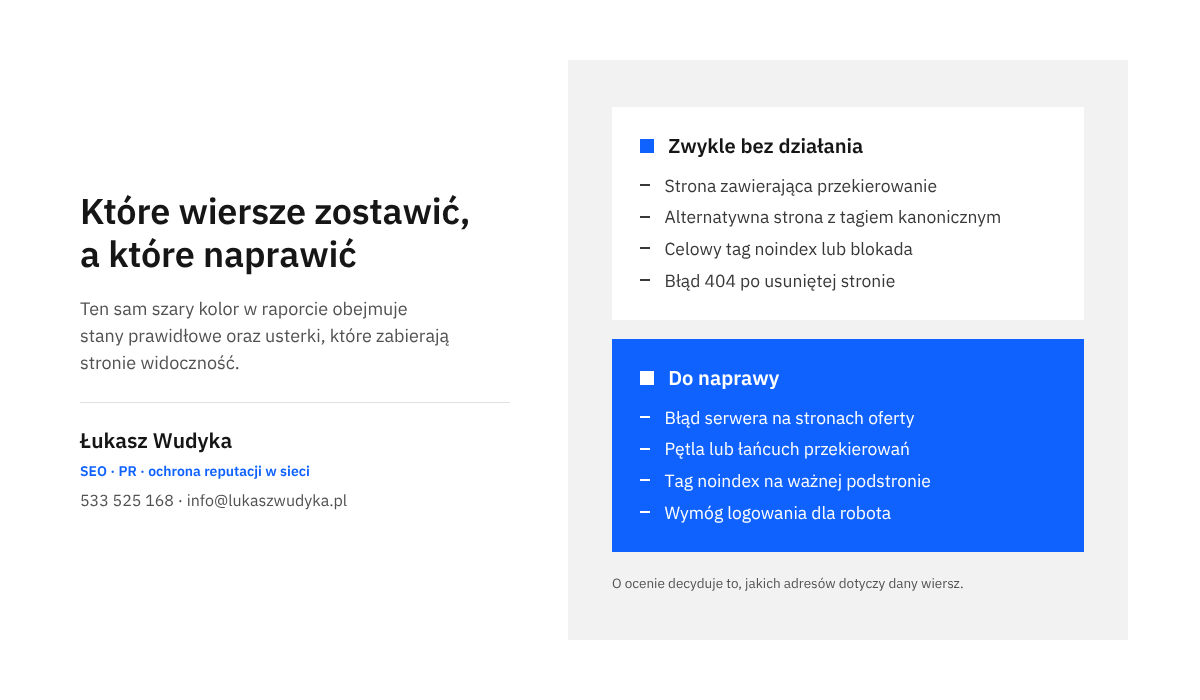
Google podkreśla, że nie należy oczekiwać zindeksowania wszystkich adresów w witrynie. Do indeksu ma trafić wersja kanoniczna, czyli główna wersja każdej ważnej podstrony, a kopie i adresy pomocnicze powinny pozostać poza nim. Powód „Alternatywna strona zawierająca prawidłowy tag strony kanonicznej” oznacza, że adres poprawnie wskazuje stronę główną dla danej treści i że ta strona jest zindeksowana. Pomoc stwierdza przy nim wprost, że nie trzeba nic robić. Podobnie jest z powodem „Strona zawierająca przekierowanie”: adres, który przenosi odwiedzającego w inne miejsce, sam nie jest indeksowany, a w indeksie może znaleźć się strona docelowa.
Do tej samej grupy należą blokady założone celowo. Powód „URL zawiera tag noindex” przy stronie koszyka, podziękowania za zamówienie czy wynikach wewnętrznej wyszukiwarki potwierdza, że blokada działa zgodnie z zamiarem. To samo dotyczy powodu „URL zablokowany przez plik robots.txt” przy panelu administracyjnym lub adresach filtrowania. Powód „Nie znaleziono (404)” również nie musi być usterką: jeśli podstrona została usunięta i nie ma następcy, odpowiedź 404 jest poprawna. Google informuje, że robot będzie jeszcze przez pewien czas odwiedzał taki adres, coraz rzadziej, i że nie da się nakazać mu trwałego zapomnienia adresu. Raport pokazuje wyłącznie te adresy, które zwróciły błąd 404 w ciągu ostatniego miesiąca.
Osobnej uwagi wymagają dwa powody dotyczące kopii. „Duplikat, użytkownik nie oznaczył strony kanonicznej” informuje, że Google znalazł kilka adresów z tą samą treścią i sam wybrał jeden z nich. Pomoc nazywa to działaniem zgodnym z zamierzeniami, a nie błędem. „Duplikat, wyszukiwarka Google wybrała inną stronę kanoniczną niż użytkownik” oznacza z kolei, że właściciel wskazał jedną wersję, a Google uznał za lepszą inną. W obu przypadkach należy sprawdzić tylko jedno: czy wybrana przez Google wersja jest tą, która ma się wyświetlać klientom. Jeśli tak, wiersz można zostawić. Jeśli nie, trzeba wyraźnie oznaczyć właściwy adres jako kanoniczny albo zadbać o to, by obie strony miały wyraźnie inną treść.
Kto woli nie zajmować się tym samodzielnie, może zadzwonić pod numer 533 525 168 albo napisać na info@lukaszwudyka.pl. Przejrzę raport wiersz po wierszu, wskażę powody, które naprawdę zabierają stronie widoczność, i przygotuję listę poprawek ułożoną w kolejności wykonywania.
Które powody oznaczają usterkę i jak ją usunąć?
Usterką jest każdy powód ze źródłem „Witryna”, który dotyczy adresu przeznaczonego dla klientów: strony głównej, oferty, kategorii, produktu, wpisu na blogu. Poniżej opisane są trzy grupy takich powodów wraz z ustaleniem przyczyny i sposobem naprawy. Nazwy podano w brzmieniu z pomocy Google, a w samym panelu sformułowanie bywa nieznacznie inne.
Serwer odmawia dostępu albo odsyła robota w kółko
„Błąd serwera (5xx)” oznacza, że robot Google nie uzyskał dostępu do adresu: serwer zwrócił błąd, odrzucił żądanie albo nie odpowiedział na czas. Pomoc wymienia jako typowe przyczyny przeciążenie lub wadliwą konfigurację serwera, bardzo wolne strony generowane z wielu parametrów oraz zabezpieczenia, które biorą robota za atak, ponieważ wysyła on więcej żądań niż zwykły odwiedzający. Pierwszym krokiem jest sprawdzenie dostępności hosta w raporcie „Statystyki indeksowania”, drugim rozmowa z firmą hostingową o blokadach w zaporze i o wydajności serwera. Takie błędy bywają przejściowe, dlatego pojedynczy udany test nie dowodzi, że problem zniknął na dobre.
Powody „Strona zablokowana z powodu nieautoryzowanego żądania (401)” i „Strona zablokowana z powodu zabronionego dostępu (błąd 403)” mówią, że strona żąda logowania albo odmawia wejścia. Robot Google nigdy nie podaje danych logowania, więc taka podstrona nie zostanie zindeksowana. Najprostszy test to otwarcie adresu w oknie incognito przeglądarki: jeśli pojawia się prośba o hasło, przyczyną jest ochrona hasłem pozostawiona po pracach nad stroną albo wtyczka ograniczająca dostęp. „Błąd przekierowania” oznacza zbyt długi łańcuch przekierowań, pętlę, zbyt długi adres końcowy albo pusty lub nieprawidłowy adres w łańcuchu. Naprawa polega na ustawieniu jednego, bezpośredniego przekierowania ze starego adresu na docelowy.
Ważna strona została zablokowana przez pomyłkę
Ten sam powód, który przy koszyku jest prawidłowy, przy stronie oferty staje się poważną usterką. Jeśli wiersz „URL zawiera tag noindex” obejmuje adresy przeznaczone dla klientów, należy usunąć dyrektywę z kodu strony lub z nagłówka odpowiedzi serwera. W WordPressie częstym źródłem jest ustawienie widoczności dla wyszukiwarek w ustawieniach czytania, włączone na czas budowy strony, albo przełącznik we wtyczce SEO przy konkretnym wpisie. Pomoc Google podpowiada, by przeszukać źródło strony i nagłówki odpowiedzi pod kątem słowa „noindex”, a następnie potwierdzić wynik testem wersji opublikowanej.
Przy powodzie „URL zablokowany przez plik robots.txt” trzeba znaleźć regułę, która obejmuje ważny adres, i ją usunąć lub zawęzić. Sposób szukania opisuję we wpisie o tym, jak znaleźć regułę blokującą w pliku robots.txt. Trzeba też znać ograniczenie tej metody: plik robots.txt nie gwarantuje, że adres nie trafi do indeksu, bo Google może go zindeksować na podstawie linków z innych stron, bez odczytania treści. Stąd bierze się ostrzeżenie „Strona zindeksowana, ale zablokowana przez plik robots.txt”. Jeśli celem jest ukrycie strony, Google zaleca zdjęcie blokady z pliku i zastosowanie tagu noindex, ponieważ robot musi móc odczytać stronę, żeby ten tag zauważyć.
Adres nie istnieje albo udaje, że istnieje
Wiersz „Nie znaleziono (404)” wymaga naprawy wtedy, gdy są w nim adresy, które powinny działać, albo adresy przeniesione w inne miejsce. Google zaleca zajmowanie się tylko tymi błędami 404, które dotyczą własnych linków lub adresów z mapy witryny. Przeniesioną podstronę należy przekierować stałym przekierowaniem 301 pod nowy adres, a błędne linki wewnętrzne poprawić u źródła. Usuniętą stronę bez następcy można zostawić z odpowiedzią 404. Szczegółowe kryteria wyboru opisałem w tekście o tym, które adresy 404 naprawiać, a które zostawić.
„Pozorny błąd 404” to sytuacja, w której strona wyświetla komunikat o braku treści albo jest niemal pusta, ale serwer odpowiada tak, jakby wszystko było w porządku. Zdarza się to przy pustych kategoriach w sklepie, wyprzedanych produktach bez opisu i stronach wyników bez pozycji. Google zaleca, by strony faktycznie nieistniejące zwracały prawdziwy kod 404, a strony istniejące uzupełnić o treść, która pokaże, że nie są puste. W narzędziu do sprawdzania adresów URL po teście wersji opublikowanej można kliknąć „Wyświetl przetestowaną stronę” i obejrzeć zrzut ekranu pokazujący, co widzi robot. Często okazuje się wtedy, że treść ładuje się dopiero po działaniu odwiedzającego i dla Google pozostaje niewidoczna.
| Powód w raporcie | Co zwykle oznacza | Co zrobić |
|---|---|---|
| Błąd serwera (5xx) | Serwer nie odpowiedział robotowi lub odrzucił żądanie | Sprawdzić dostępność hosta i ustawienia zapory u dostawcy hostingu |
| Błąd przekierowania | Pętla, zbyt długi łańcuch albo błędny adres w łańcuchu | Ustawić jedno bezpośrednie przekierowanie na adres docelowy |
| URL zawiera tag noindex | Strona sama prosi o pominięcie w indeksie | Zostawić przy stronach ukrytych celowo, usunąć tag przy stronach oferty |
| URL zablokowany przez plik robots.txt | Reguła w pliku zabrania robotowi wejścia | Usunąć lub zawęzić regułę, jeśli obejmuje ważne adresy |
| Nie znaleziono (404) | Pod adresem nie ma strony | Przekierować adresy przeniesione, poprawić błędne linki, resztę zostawić |
| Pozorny błąd 404 | Strona pusta lub z komunikatem o braku treści bez kodu 404 | Zwracać kod 404 albo uzupełnić treść strony |
| Strona zawierająca przekierowanie | Adres przenosi w inne miejsce | Nic, o ile strona docelowa jest właściwa |
Co oznaczają stany „wykryta” i „zeskanowana”, których nie da się naprawić jednym kliknięciem?
Dwa powody budzą najwięcej pytań, ponieważ nie wskazują żadnej konkretnej usterki. „Strona wykryta – obecnie niezindeksowana” oznacza, że Google zna adres, ale jeszcze go nie odwiedził. Pomoc podaje jako najczęstszą przyczynę obawę, że próba pobrania strony mogłaby przeciążyć witrynę, przez co wizytę przełożono na później. Dlatego data ostatniego pobrania jest w tym wierszu pusta. „Strona zeskanowana, ale jeszcze niezindeksowana” to etap dalszy: robot stronę odwiedził, lecz nie umieścił jej w indeksie. Google dodaje, że strona może zostać zindeksowana w przyszłości i że nie ma potrzeby ponownego przesyłania takiego adresu.
W obu przypadkach nie istnieje przełącznik, który rozwiązuje sprawę, ale właściciel nie jest bezradny. Google wyjaśnia, że aby stronę zindeksować, musi ją najpierw znaleźć, czyli trafić na link ze znanej już strony albo na wpis w mapie witryny. Pierwszym działaniem jest więc sprawdzenie, czy do podstrony prowadzą linki z menu, kategorii lub innych wpisów i czy adres jest w mapie. Drugim jest ocena samej treści: w dokumentacji dotyczącej próśb o indeksowanie Google stwierdza, że jego systemy najszybciej uwzględniają treści o wysokiej jakości, przydatne dla użytkowników. Strony bardzo krótkie, powielające inne podstrony albo niewnoszące nic nowego pozostają w tych stanach najdłużej.
Trzeba też uwzględnić zwykły upływ czasu. Według pomocy rozpoczęcie skanowania nowej strony lub witryny może potrwać około tygodnia, a zindeksowanie części lub całości serwisu, gdy adresy są już znane, nawet kilka tygodni. Indeksowanie nigdy nie następuje od razu, także po bezpośredniej prośbie. Jeśli przy stanie „wykryta” witryna działa wolno lub serwer miewa przerwy, w pierwszej kolejności należy poprawić jego wydajność, bo to ona skłania robota do odkładania wizyt. Szersze omówienie przyczyn i sposobów postępowania zawiera wpis o komunikacie „Strona wykryta – obecnie niezindeksowana”.
Jak sprawdzić pojedynczy adres i ustalić faktyczną przyczynę?
Raport służy do oglądania całości i nie odpowiada na pytanie o konkretną podstronę. Google zaznacza, że nie można w nim wyszukiwać ani filtrować według adresu, a stan pojedynczej strony sprawdza się narzędziem do sprawdzania adresów URL. Narzędzie pokazuje dwie różne rzeczy: dane zapisane w indeksie podczas ostatniej wizyty robota oraz wynik testu przeprowadzonego w danej chwili na działającej stronie. Różnica między nimi bywa źródłem nieporozumień, dlatego obie części należy czytać osobno. Kolejność czynności jest następująca.
- Otwarcie strony ze szczegółami powodu W tabeli „Dlaczego strony nie są indeksowane” należy kliknąć wiersz z wybranym powodem, a u góry strony link „Więcej informacji”, który otwiera opis problemu w pomocy.
- Wybór przykładowego adresu Na liście przykładów trzeba odszukać adres ważny dla firmy i kliknąć obok niego ikonę sprawdzania adresu, która czasem pojawia się dopiero po najechaniu kursorem. Otworzy się narzędzie do sprawdzania adresów URL z wynikiem dla tego adresu.
- Odczytanie danych z indeksu W sekcji o stanie w indeksie należy rozwinąć część dotyczącą skanowania i indeksowania. Widać tam datę ostatniej wizyty robota, odpowiedź serwera, informację, czy indeksowanie jest dozwolone, oraz adres kanoniczny wybrany przez Google.
- Test działającej strony Należy kliknąć „Sprawdź URL wersji opublikowanej”. Test pokaże, czy w tej chwili robot może stronę pobrać i czy blokada nadal istnieje.
- Porównanie obu wyników Jeśli dane z indeksu pokazują błąd, a test wersji opublikowanej już nie, usterka została usunięta po ostatniej wizycie robota i wystarczy poprosić o ponowne sprawdzenie.
- Prośba o zindeksowanie Po potwierdzeniu, że strona jest dostępna, klika się „Poproś o zindeksowanie”. Przycisk jest dostępny dla właściciela usługi i użytkownika z pełnym dostępem.
Adres można też wpisać ręcznie w pasku wyszukiwania u góry dowolnego ekranu Search Console, pod warunkiem że należy do otwartej usługi. Trzeba pamiętać o ograniczeniach testu. Sprawdzenie wersji opublikowanej nie bada duplikatów ani wyboru strony kanonicznej, więc przy powodach dotyczących kopii liczą się wyłącznie dane z indeksu. Test podąża też za przekierowaniem i bada adres końcowy, nie pokazując, że przekierowanie nastąpiło. Błędy serwera bywają chwilowe, dlatego udany test nie wyklucza, że robot trafił wcześniej na przerwę w działaniu. Pełny opis ekranu wyników zawiera instrukcja o tym, jak czytać wynik narzędzia Sprawdzanie adresu URL.
Przy prośbach o zindeksowanie obowiązują dwa zastrzeżenia z dokumentacji Google. Liczba adresów, które można zgłosić w ten sposób, jest ograniczona, a wielokrotne zgłaszanie tego samego adresu niczego nie przyspiesza. Prośba nie daje również gwarancji, że strona trafi do indeksu szybko ani że trafi do niego w ogóle. Gdy poprawionych adresów jest wiele, Google wskazuje mapę witryny jako właściwy sposób przekazania ich naraz.
Jak zgłosić poprawkę i po czym poznać, że zadziałała?
Po usunięciu przyczyny można czekać, aż Google sam odnotuje zmianę, albo poprosić o sprawdzenie. Obie drogi prowadzą do tego samego wyniku: liczba wystąpień jest aktualizowana przy każdej wizycie robota na stronie ze znanym problemem, niezależnie od tego, czy weryfikację zgłoszono. Zgłoszenie ma jednak dwie zalety wymienione w pomocy. Search Console wysyła wiadomość e-mail, gdy potwierdzi naprawę wszystkich adresów albo gdy znajdzie pozostałe wystąpienia, a postęp i stan każdego adresu można śledzić w dzienniku. Weryfikację uruchamia się w następujący sposób.
- Naprawa wszystkich wystąpień Przed zgłoszeniem trzeba usunąć problem na wszystkich adresach z danego wiersza. Weryfikacja zostaje zatrzymana, gdy Google znajdzie choć jedno pozostałe wystąpienie.
- Otwarcie strony problemu W raporcie należy kliknąć wiersz naprawionego powodu. Jeśli nad wykresem ustawiony jest filtr konkretnej mapy witryny, weryfikacja obejmie tylko adresy z tej mapy.
- Uruchomienie sprawdzenia Należy kliknąć „Sprawdź poprawkę” i nie klikać przycisku ponownie, dopóki weryfikacja nie zakończy się powodzeniem lub niepowodzeniem.
- Śledzenie postępu Stan widać na stronie problemu oraz w kolumnie „Weryfikacja”. Link „Sprawdź szczegóły” otwiera listę adresów ze stanem każdego z nich.
- Postępowanie po niepowodzeniu Na stronie szczegółów należy odszukać adres, który nie przeszedł kontroli, usunąć na nim problem, a następnie kliknąć „Rozpocznij nową weryfikację”.
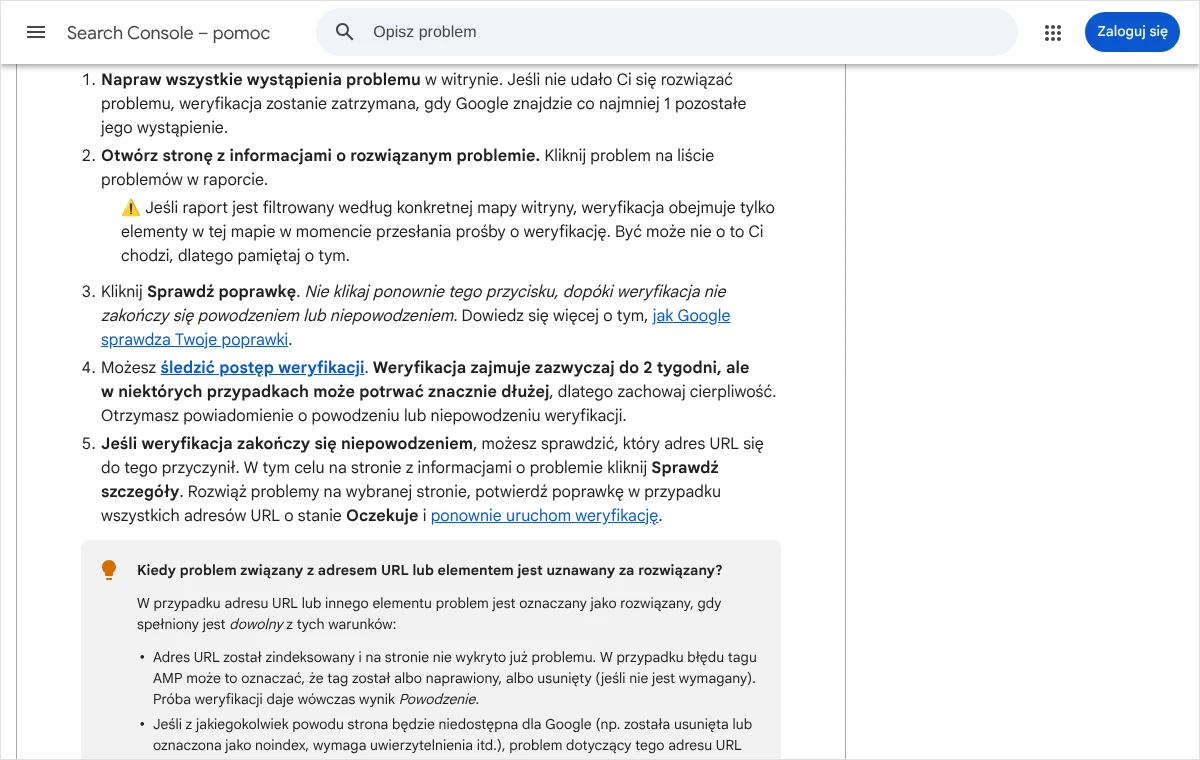
Weryfikacja zajmuje zazwyczaj do 2 tygodni, ale według pomocy w niektórych przypadkach trwa znacznie dłużej. Zaraz po kliknięciu Search Console sprawdza kilka stron. Jeśli na którejś nadal znajdzie problem, weryfikacja kończy się od razu, a jeśli nie, przechodzi w stan „Rozpoczęto”. Kolejne etapy to „Wszystko w porządku”, gdy dotychczas sprawdzone adresy są naprawione, i „Powodzenie”, gdy zniknęły wszystkie znane wystąpienia. Stan „Nie dotyczy” oznacza, że Google uznał problem za rozwiązany bez zgłoszenia.
Skuteczną naprawę poznaje się po trzech rzeczach. Liczba stron w wierszu spada, aż do zera, a sam wiersz przesuwa się na dół tabeli. Na głównym wykresie rośnie zielona liczba stron zindeksowanych. W narzędziu do sprawdzania adresów URL naprawiona podstrona otrzymuje informację, że jest w indeksie. Wiersz z zerem nie znika od razu: problem pozostaje w tabeli jeszcze przez 90 dni od zniknięcia ostatniego wystąpienia i dopiero po tym czasie jest z niej usuwany. Nie jest to więc sygnał, że naprawa się nie powiodła.
Jakich błędów unikać przy czytaniu raportu?
Najczęstszy błąd to próba doprowadzenia szarej liczby do zera. Jest to cel nieosiągalny i niepotrzebny, bo każda rozbudowana witryna ma adresy, które nie powinny być w indeksie. Pogoń za zerem prowadzi do szkodliwych działań: zdejmowania tagu noindex ze stron technicznych, usuwania przekierowań albo odblokowywania w pliku robots.txt sekcji, które miały pozostać zamknięte. Właściwym celem jest stan, w którym wszystkie ważne podstrony są zielone, a każdy szary wiersz ma zrozumiałe uzasadnienie. Pomoc Google ujmuje to podobnie: przy decyzji, czy dany problem rozwiązywać, należy kierować się zdrowym rozsądkiem.
Drugi błąd to łączenie blokady w pliku robots.txt z tagiem noindex na tej samej stronie. Robot, któremu zabroniono wejścia, nie odczyta tagu, więc adres może mimo wszystko pojawić się w wynikach, tyle że z bardzo ograniczonym opisem. Trzeci błąd dotyczy mapy witryny: umieszczanie w niej adresów z przekierowaniem, z tagiem noindex albo nieistniejących powoduje skoki liczby problemów i zaciemnia obraz. Mapa powinna zawierać wyłącznie adresy kanoniczne, które mają się wyświetlać w Google.
Najczęstsze pytania
Czy duża liczba niezindeksowanych stron obniża pozycję całej witryny?
Dokumentacja raportu nie zawiera takiego stwierdzenia. Google wyjaśnia w niej, że większość witryn ma przynajmniej kilka niezindeksowanych adresów, że kopie i strony alternatywne nie powinny być indeksowane, a oznaczenie ich w raporcie jest zwykle dobrym znakiem, bo oznacza odnalezienie i zindeksowanie wersji kanonicznej. Znaczenie ma to, czy w indeksie są wszystkie ważne podstrony. Sama wielkość szarej liczby nie jest miarą kondycji serwisu i nie należy jej traktować jako oceny wystawionej witrynie.
Dlaczego łączna liczba stron w raporcie różni się od liczby podstron w serwisie?
Raport liczy adresy, a nie podstrony w rozumieniu właściciela. Ta sama treść dostępna pod kilkoma adresami, na przykład z parametrami sortowania i filtrowania, jest liczona wielokrotnie, co zawyża szarą liczbę. Odwrotna sytuacja, czyli suma wyraźnie mniejsza od liczby podstron, oznacza według Google, że części stron wyszukiwarka nie znalazła. Dzieje się tak, gdy strony są nowe albo gdy nie prowadzi do nich żaden link ani wpis w mapie witryny. Google uprzedza też, że niewielkie rozbieżności są normalne.
Strona została naprawiona, a raport nadal pokazuje błąd. Co to oznacza?
Najczęściej naprawa nastąpiła po ostatniej wizycie robota, a raport pokazuje stan z tamtej wizyty. Należy porównać datę ostatniego skanowania widoczną w szczegółach adresu z dniem wprowadzenia zmiany. Jeśli test wersji opublikowanej nie wykazuje już problemu, wystarczy poprosić o zindeksowanie albo zgłosić poprawkę dla całego wiersza i poczekać. Trzeba też pamiętać, że test wersji opublikowanej nie bada duplikatów ani strony kanonicznej, więc przy tych powodach brak błędu w teście niczego nie przesądza.
Jak długo Google będzie wracał do usuniętej strony z błędem 404?
Google nie podaje konkretnego terminu. Wyjaśnia jedynie, że robot odwiedza znane adresy także wtedy, gdy przez pewien czas zwracają błędy z grupy 4xx, na wypadek gdyby były to błędy przejściowe, i że z czasem robi to coraz rzadziej. Nie ma sposobu, by nakazać mu trwałe zapomnienie adresu. Raport pokazuje tylko te adresy, które zwróciły błąd 404 w ciągu ostatniego miesiąca, więc lista nie rośnie w nieskończoność. Jeśli usunięta strona ma następcę, właściwym rozwiązaniem jest przekierowanie 301.
Strona jest w indeksie, ale nie widać jej w wynikach. Czy raport się myli?
Zwykle nie. Google wyjaśnia, że zindeksowanie strony nie gwarantuje jej wyświetlenia w wynikach każdego wyszukiwania, ponieważ wyniki zależą między innymi od lokalizacji osoby szukającej, historii jej wyszukiwań i wielu innych zmiennych. Jeżeli Search Console pokazuje adres jako zindeksowany, można przyjąć, że znajduje się on w indeksie i kwalifikuje do wyświetlania. Brak widoczności na konkretne zapytanie jest wtedy kwestią oceny treści i konkurencji w wynikach, a nie indeksowania.
Czym różni się tabela z powodami od tabeli z ostrzeżeniami pod nią?
Pierwsza tabela zawiera adresy, których nie ma w indeksie. Druga obejmuje strony zindeksowane, przy których Google ma zastrzeżenia. Pomoc wymienia tu dwa ostrzeżenia: „Strona zindeksowana, ale zablokowana przez plik robots.txt” oraz „Strona zindeksowana bez zawartości”, czyli sytuację, w której adres jest w indeksie, lecz Google nie zdołał odczytać jego treści. Takie strony mogą pojawiać się w wynikach z bardzo ubogim opisem, dlatego przy ważnych adresach należy sprawdzić je narzędziem do sprawdzania adresów URL.
Źródła
- Raport Indeksowanie stron, Pomoc Search Console
- Narzędzie do sprawdzania adresów URL, Pomoc Search Console
- Zgłaszanie do Google prośby o ponowne zindeksowanie adresów URL, Centrum wyszukiwarki Google
- Blokowanie indeksowania przez wyszukiwarki za pomocą tagu noindex, Centrum wyszukiwarki Google
- Jak określić stronę kanoniczną za pomocą rel=”canonical” i innych metod, Centrum wyszukiwarki Google
Brak czasu albo ochoty, żeby zająć się tym samodzielnie?
Raport o indeksowaniu potrafi zniechęcić samą liczbą wierszy i technicznym językiem, a prowadzenie firmy rzadko zostawia czas na czytanie dokumentacji. Chętnie przejmę tę sprawę w całości. Przejrzę raport, oddzielę powody, które są w porządku, od tych, które zabierają stronie widoczność, sprawdzę najważniejsze podstrony pojedynczo i ustalę, skąd bierze się każda blokada. Następnie wprowadzę poprawki albo przekażę wykonawcy strony dokładną listę zmian, zgłoszę je do Google i dopilnuję weryfikacji aż do jej zakończenia.
Na koniec przygotuję krótkie, zrozumiałe podsumowanie: co było przyczyną, co zostało zmienione i na co zwracać uwagę w przyszłości, żeby problem nie wrócił. Wystarczy zadzwonić pod numer 533 525 168 albo napisać na adres info@lukaszwudyka.pl i podać adres strony. Odpowiem, od czego warto zacząć i ile pracy wymaga dana sytuacja.



